General news
基于 Spring Boot 构建生产级 AI 应用平台
掘金
把一个能调用模型的 Spring Boot 服务直接称为 AI 平台,通常只完成了平台能力的很小一部分。生产级平台需要同时管理模型、知识库、Agent、会话、工具、权限、成本和运行状态,并把这些能力稳
Score: 57.35Confidence: 54%
View offerLoading the catalog…
THE AI OPPORTUNITY INDEX
Find your next AI tool. Explore free access, trials, and credits — all in one place.
掘金
把一个能调用模型的 Spring Boot 服务直接称为 AI 平台,通常只完成了平台能力的很小一部分。生产级平台需要同时管理模型、知识库、Agent、会话、工具、权限、成本和运行状态,并把这些能力稳
Score: 57.35Confidence: 54%
View offer掘金
@TOC 合并冲突本身不难,删掉几行标记、留下该留的代码而已。 难的是看不出两边原本想干什么。默认的冲突块里只有两段代码:你的和对方的。缺了最关键的一段——它们分叉之前长什么样。人缺这段信息要靠猜,A
Score: 57.34Confidence: 54%
View offeriThome 新聞
資安業者Gambit Security揭露一波利用AI代理發動的大規模網路攻擊,攻擊者使用3套開源AI工具鎖定線上零售商,攻擊活動從7月延續至今,Gambit Security發布報告時表示活動仍在進行。光是9月10日至15日就啟動105個攻擊專案,至少27家公司遭入侵,攻擊者還從兩家受害企業竊取超過60萬筆尚未到期的信用卡資料,並在多個電商網站植入信用卡資料竊取程式。
Score: 55.75Confidence: 54%
View offervelog
이 글은 개인 프로젝트 'Dungeon Adventure'을 만들며 겪은 이슈 기록입니다. Dungeon Adventure [Github] 문제 상황 방에 들어가는 순간 문이 닫히면서 플레이어가 문에 끼거나 밀려남 원인 확인 1차 확인 트리거 경계가 안쪽 벽면과 같아서 플레이어가 문 칸 위에 있을 때 입장 이벤트가 발생 → 플레이어 위에서 문 콜라이더가 켜짐 2차 확인 단순히 방 트리거를 줄여도 문제가 해결되지 않음 들어오는 문 방향에 따라 해결된 모습을 보이기도 하고 그대로인 모습을 보이기도 함 트리거가 줄어들기만 한게 아니라 위치가 정중앙이 아님을 확인 해결 public Vector3 GetRoomCenterWorldPos(Room room) { DungeonGridConverter gridconverter = new DungeonGridConverter(); Vector2Int offset = gridconverter.GetRoomOffset(room, tileWidth, tileHeight); int x = offset.x + (tileWidth / 2); int y = offset.y + (tileHeight / 2); Vector3Int centerPos = new Vector3Int(x, y, 0); // 수정 전 // return tilemap.GetCellCenterWorld(centerPos); // 수정 후 return tilemap.CellToWorld(centerPos); } 짝수 크기(10×10) 방의 중심은 칸 사이의 경계인데, GetCellCenterWorld로 칸의 중심을 구해서 0.5칸 어긋남 GetCellCenterWorld ⇒ CellToWorld로 변경 이후 트리거 크기 재변경 BoxCollider2D roomcollider = roomMap.AddComponent<BoxCollider2D>(); roomcollider.isTrigger = true; roomcollider.size = new Vector2(tileWidth - 3, tileHeight - 3); 트리거 크기 조건 벽과 트리거 사이 틈 > 0 → 문 칸 위에서는 입장 이벤트가 발생하지 않음 틈 < 플레이어 콜라이더 크기 → 트리거를 피해서 방을 지나갈 수 없음 −4는 1칸 틈이 생겨 트리거를 우회할 수 있음을 확인, -3으로 결정 결과 문에 끼는 현상 없이 입장하고 트리거를 건너뛰고 방을 통과하는 경우도 없어짐 아쉬운 점 및 배운 점 지금의 해결 방식은 방 크기가 홀수가 되면 다시 반 칸 어긋나게 된다. 또한 트리거 크기도 방 크기에 묶여 있는 상태다. 문 콜라이더를 켜기 전에 플레이어가 문 칸을 벗어났는지 확인하는 방식이 더 근본적인 해결이라는 생각이 든다.
Score: 54.4Confidence: 49%
View offervelog
오늘은 css를 시작했다.
Score: 54.4Confidence: 49%
View offervelog
학습 목표 타입스크립트와 자바스크립트의 차이를 말로 설명할 수 있다. 타입스크립트 코드를 작성할 수 있다. 타입스크립트란 어떤 언어일까? 타입스크립트는 자바스크립트를 보다 안전하게 사용할 수 있도록 타입 관련 기능을 자바스크립트에 추가한 언어 즉 타입스크립트는 자바스크립트의 상위 개념(확장판)이라고 이해할 수 있다. 타입스크립트는 타입 안정성을 보장하고, 유지보수성을 높이며 런타임 에러를 줄이는 데 중요한 역할을 한다. 이로 인해 대다수 FE 개발에선 타입스크립트가 주축을 이루고 있다. TS(TypeScript) 기본 문법 우선 자바스크립트는 보통 변수를 선언할 때 let , const , var 를 사용한다. 타입스크립트도 이와 같이 선언을 하지만 변수의 타입(number, string ...)을 직접 선언할 수 있다. let num: number = 1; // number 타입 변수 생성 이처럼 TS는 타입을 지정할 수 있는데 정의한 타입 이외의 타입(string, array...)으로 지정하게 된다면 오류가 발생한다. let num: number = 1; num = "hello"; // 에러 발생!! 매개변수의 경우에도 동일한 문법을 사용한다. function addNumber(num1: number, num2: number):number /* <= 함수의 반환값도 지정 가능*/ { return num1 + num2; } 그렇다면 타입을 지정하지 않으면 에러가 발생할까? 타입스크립트는 변수를 선언할 때 타입을 정의하지 않아도 초깃값 을 기준으로 타입을 자동으로 추론한다. 이를 타입 추론(Type Inference)이라고 한다. 그러나 예외적으로 초깃값이 없는 매개변수의 타입은 추론되지 않는다. 따라서 매개변수처럼 초깃값이 없는 변수는 타입을 지정하지 않는다면 에러가 발생한다. function concating(str1, str2) { // 에러 발생 return str1 + str2; } 식별자 정의 타입스크립트는 자주 사용하는 타입 구조(ex 객체)를 별도의 이름(식별자)으로 정의해 재사용할 수 있다. 이를 타입 별칭(Type Alias)이라 한다. 예제를 보며 알아보자. type User = { // 식별자 정의 name: string; age: number; } const user: User = { name: "Gijin", age: 25, } Interface 타입 별칭은 복잡한 타입 구조를 간단하게 표현할 수 있어 이를 사용하면 유지보수성이 올라간다. 타입 별칭 말고 인터페이스(Interface)로도 객체의 타입을 정의할 수 있다. interface Book { title: string; author: string; }; const book: Book = { title: "한 입 크기로 잘라먹는 Next.js" author: "이정환" } 타입스크립트의 특징 정적 타입 검사(Static Type Checking) 코드를 실행하기 전 타입을 검사 자바스크립트는 코드를 실행하면서 오류를 발견하지만, 타입스크립트는 실행하기 전에 미리 코드 타입에 문제가 존재하는지 확인한다. 그 덕에 실수로 타입을 잘못 입력해도 코드를 실행하기 전에 알려주기 때문에 더 안전한 코드를 작성할 수 있다.
Score: 54.4Confidence: 49%
View offervelog
안녕하세요, 쇼츠존(Shorts Zone) 만들고 있는 사람입니다. 롱폼 영상 하나 올리면 편집 에이전트가 통째로 다 보고, 어디를 잘라야 쇼츠가 되는지부터 자막·리프레이밍·타이틀까지 알아서 끝내주는 서비스예요. 지금까지 나온 쇼츠 자동화 툴들 여러 개 써봤는데 "똑똑함"과 "가격" 둘 다 만족하는 게 없어서 직접 만들었습니다. 영상만 넣으면 끝 유튜브 링크만 넣으면 편집 에이전트가 영상을 처음부터 끝까지 보고 쇼츠로 만들 만한 구간을 스스로 찾아서 잘라줍니다. 사람이 타임라인 뒤지면서 구간 찾을 필요가 없어요. 사람 얼굴 따라다니는 리프레이밍 + 자막까지 자동 여러 명 나오는 영상도 알아서 인물 수 보고 화면을 나눠 잡고, 말하는 사람 따라 프레임이 움직여요. 자막도 스타일 골라서 자동으로 박힙니다. 바이럴 될 확률까지 점수로 알려줌 그냥 자르기만 하는 게 아니라, 뽑은 쇼츠마다 "이게 왜 될 것 같은지 / 안될 것 같은지"를 점수랑 코멘트로 같이 줘요. 처음 3초가 약하면 그 부분까지 콕 집어서 알려주고 에이전트한테 바로 고쳐달라고 할 수 있습니다. (핵심) 편집 몰라도, 말만 하면 편집 에이전트가 다 함 타임라인 만지고 자막 위치 드래그하고 할 필요 없이, 채팅창에 "이 구간 자막 좀 크게 해줘", "오프닝 좀 더 당겨줘", "이 사람 나올 때마다 확대해줘" 이런 식으로 그냥 말로 시키면 에이전트가 바로 편집을 실행해줍니다. 결과 마음에 안 들면 그냥 되돌리기. 편집 프로그램 다룰 줄 몰라도 말로 편집이 끝나는 게 이 서비스의 핵심입니다. 가격 — 클립당 10원 다른 툴들 쓰다 보면 결국 크레딧 아까워서 제대로 못 씁니다. 쇼츠존은 클립 하나 뽑는 데 10원 수준으로 맞춰서, 영상 하나 올렸을 때 나올 만한 쇼츠는 다 뽑아보고 골라도 부담 없게 만들었어요. 똑똑하게 자르는 에이전트 + 이 가격, 이 조합이 지금 없다고 생각해서 자신 있게 올립니다. 궁금하신 분들은 댓글 남겨주세요. 링크 -> https://shortszone.studio4any.com/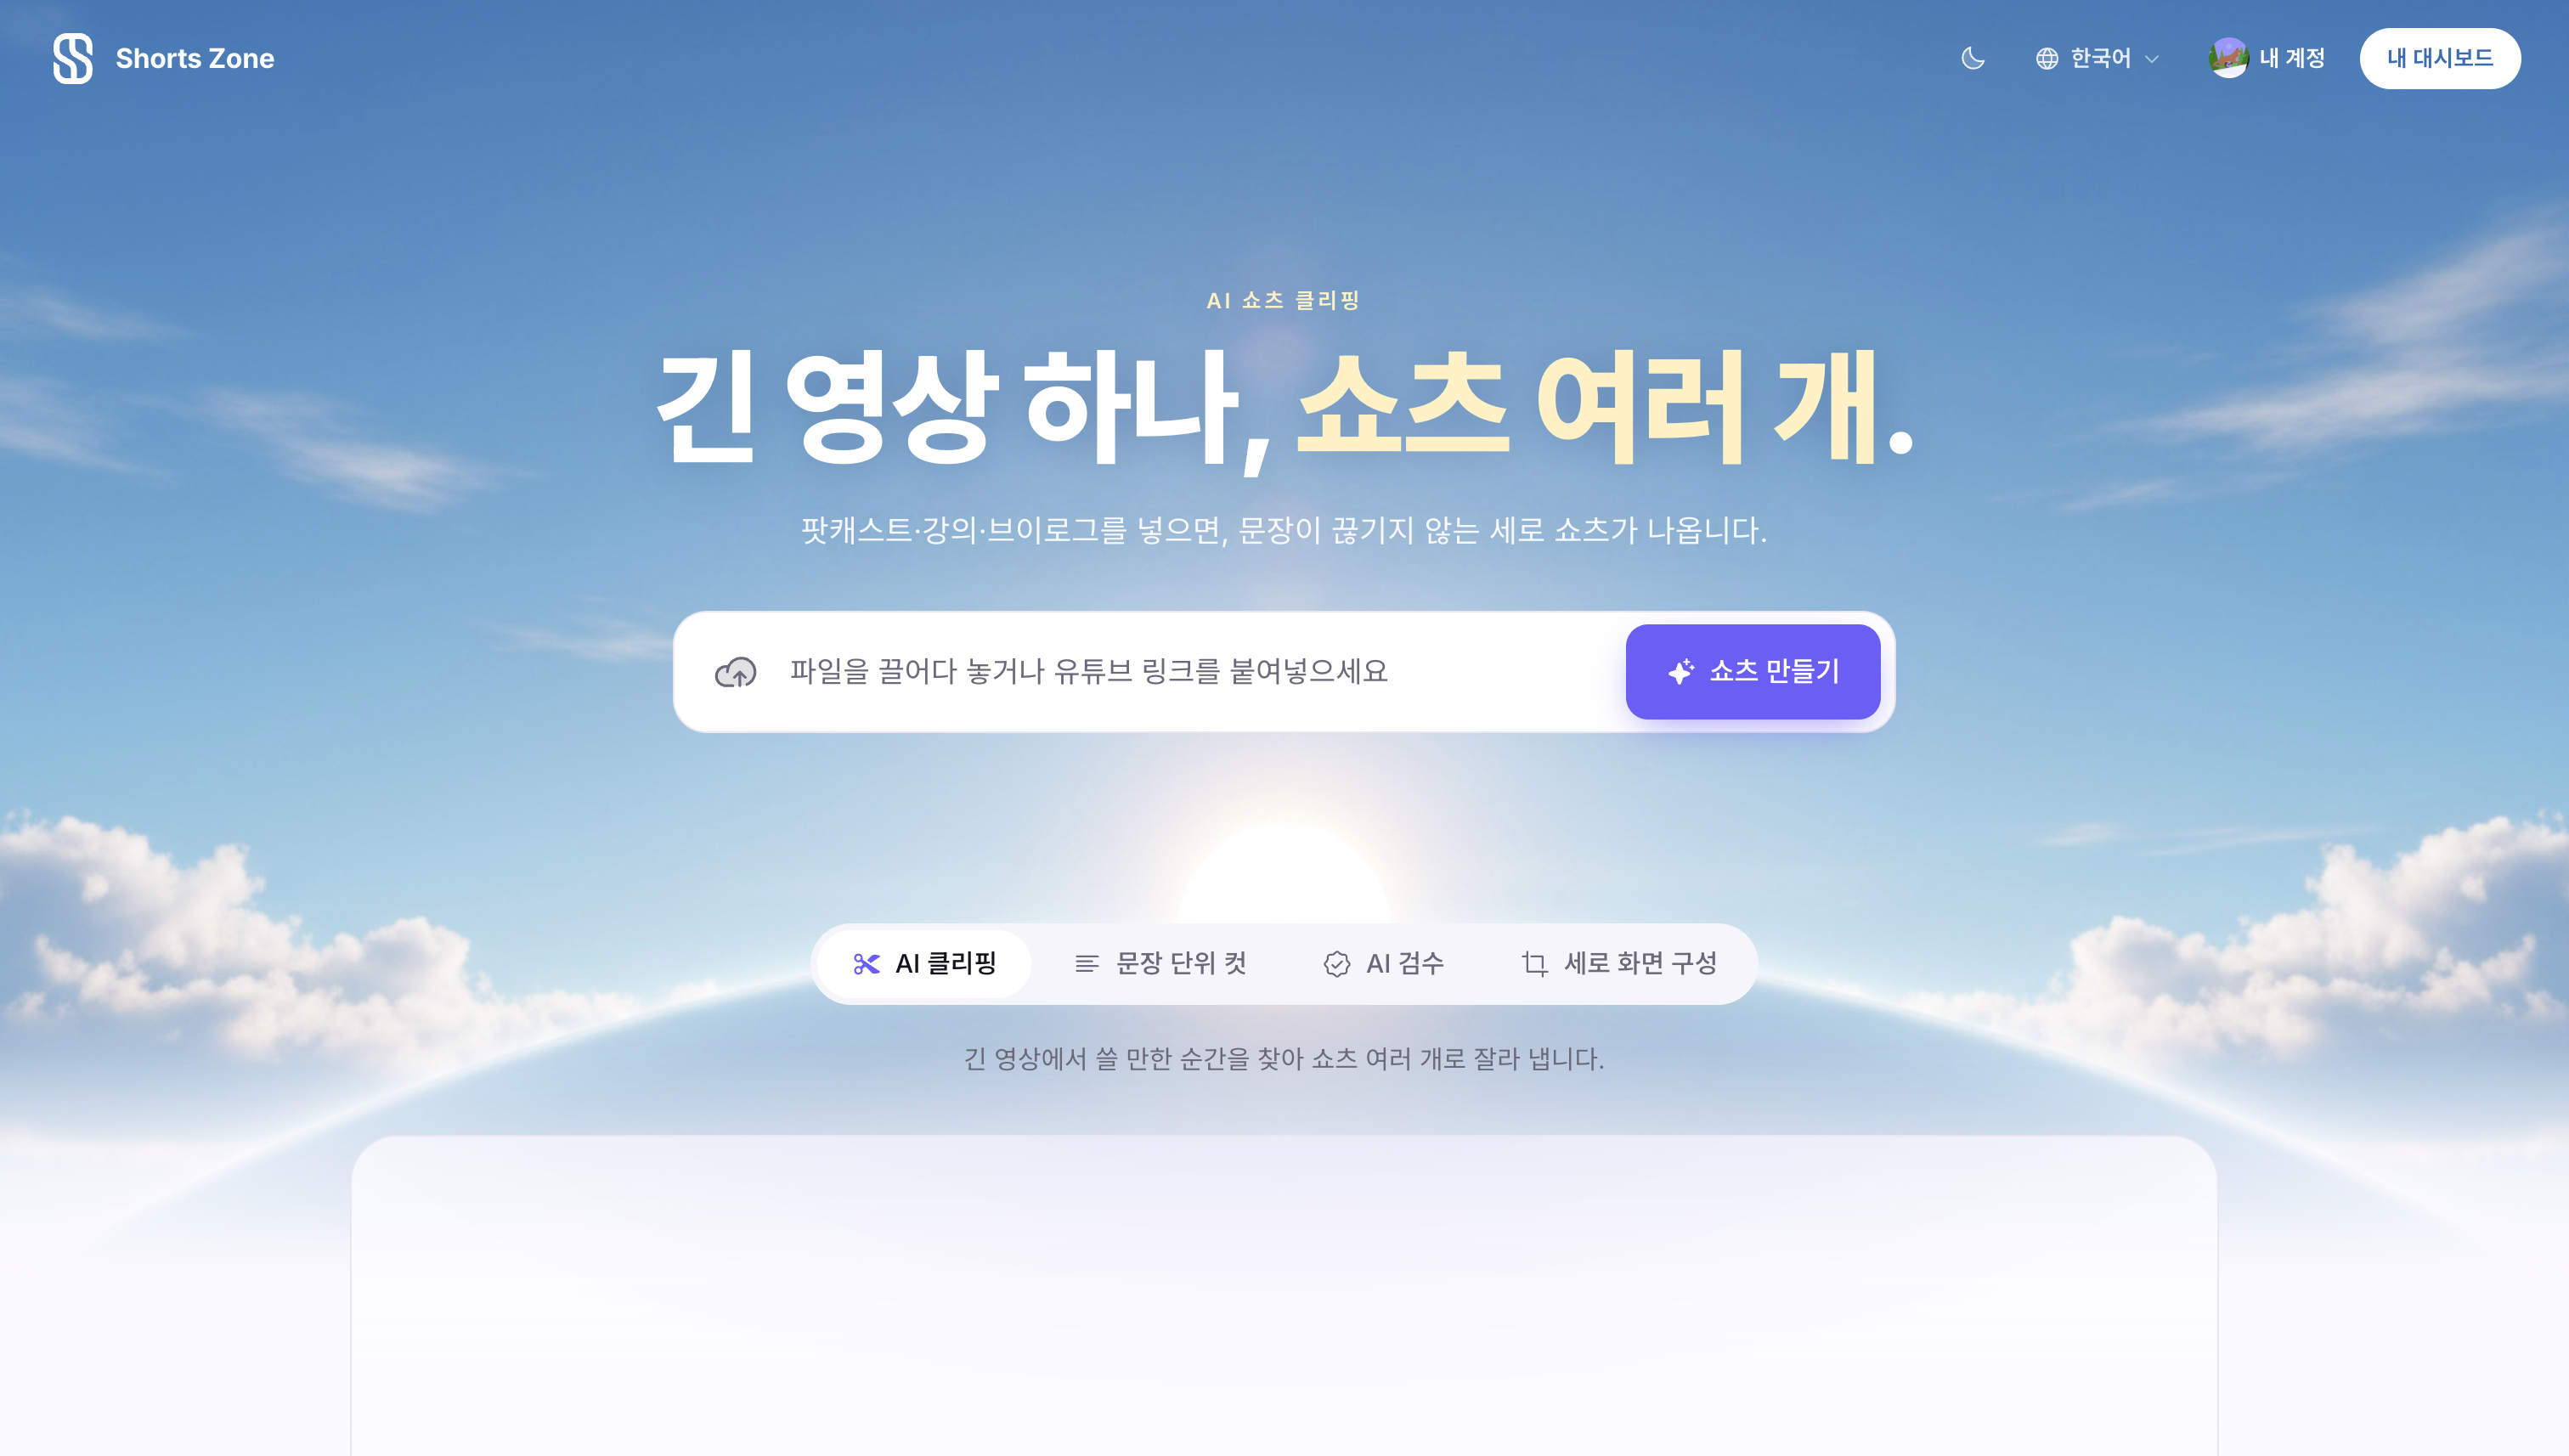
Score: 54.4Confidence: 49%
View offervelog
오늘 팀 실습에서는 Frontend, Backend, Database를 각각 나누어 구성하고, EC2에서 Docker Compose로 실행한 뒤 하나의 서비스로 연결해보았다. 나는 Database를 구성하면서 PostgreSQL(pgvector) 컨테이너를 실행했는데, docker compose up 단계에서 바로 오류가 발생했다. 문제 상황 EC2에 .env , compose.yml , init.sql 을 준비한 뒤 Database 컨테이너를 실행했다. docker compose --env-file .env -f compose.yml up -d 그런데 PostgreSQL 컨테이너가 실행되지 않고 다음 오류가 발생했다. Error response from daemon: Conflict. The container name "/aidevs-pgvector" is already in use 기존 컨테이너와 이름이 충돌해 실행에 실패했고, compose.yml 에서 컨테이너 이름을 변경한 뒤 team-pgvector 가 정상적으로 시작됐다. 오류 메시지에서 눈에 들어온 부분은 Conflict 와 already in use 였다. DB 자체가 실행되지 않는 문제가 아니라, 같은 이름의 컨테이너가 이미 존재하고 있다는 의미였다. 원인 이번에 실행하려던 Compose에서도 PostgreSQL 컨테이너 이름으로 aidevs-pgvector 를 사용하고 있었다. 그런데 EC2에는 기존 실습에서 실행한 aidevs-pgvector 컨테이너가 이미 존재하고 있었다. 결국 하나의 EC2에서 서로 다른 용도의 컨테이너가 같은 이름을 사용하려 하면서 충돌이 발생한 것이었다. 기존 컨테이너도 사용 중이었기 때문에 삭제하는 대신 새로 실행할 DB 컨테이너의 이름을 분리 하기로 했다. 해결 compose.yml 을 열어 새로운 DB 컨테이너의 이름을 team-pgvector 로 변경했다. nano compose.yml 수정한 뒤 다시 실행했다. docker compose --env-file .env -f compose.yml up -d 이번에는 Container team-pgvector Started 가 출력되면서 새로운 컨테이너가 정상적으로 실행됐다. 이후 상태를 다시 확인했다. docker compose --env-file .env -f compose.yml ps 처음에는 Up 4 seconds (health: starting) 이었지만 잠시 후 다시 확인하자 Up 49 seconds (healthy) 로 변경됐다. 단순히 컨테이너가 Started 된 것에서 끝내지 않고 실제로 DB가 정상 상태가 되었는지까지 확인했다. DB 내부까지 확인 컨테이너가 정상적으로 실행된 뒤 PostgreSQL에 직접 접속했다. docker exec -it team-pgvector psql -U agent_user -d agent_db 그리고 필요한 테이블이 생성되어 있는지 확인했다. \dt simple_multi_llm.* 결과: Schema | Name | Type | Owner -----------------|---------------|-------|----------- simple_multi_llm | chat_messages | table | agent_user simple_multi_llm | notes | table | agent_user team-pgvector 가 healthy 상태가 된 것을 확인한 뒤 PostgreSQL에 접속해 chat_messages , notes 테이블까지 확인했다. chat_messages , notes 테이블까지 확인하면서 컨테이너 실행뿐 아니라 실제 DB 구성까지 정상적으로 되어 있는 것을 확인했다. 이번에 알게 된 점 Docker Compose를 처음 배울 때는 compose.yml 에 정의한 서비스를 실행하는 것에만 집중했는데, 하나의 EC2에서 여러 실습 환경을 직접 운영해보니 이미 존재하는 컨테이너의 이름과 포트도 함께 확인해야 한다는 것 을 알게 됐다. 특히 이번처럼 기존 실습 DB aidevs-pgvector + 새로운 팀 실습 DB aidevs-pgvector 처럼 서로 다른 DB라도 컨테이너 이름이 같으면 충돌할 수 있었다. 그래서 새로운 Compose 환경을 실행하기 전에는 docker ps docker ps -a 로 기존 컨테이너를 먼저 확인하는 것이 좋다. 그리고 충돌이 발생했다고 기존 컨테이너를 바로 삭제하기보다는 기존 컨테이너가 필요한지 먼저 확인하고, 필요하다면 새로운 컨테이너의 이름과 포트를 분리하는 것이 안전하다. 정리 이번 오류의 흐름은 다음과 같았다. Docker Compose 실행 ↓ Container name Conflict ↓ 기존 컨테이너 확인 ↓ 기존 컨테이너도 필요함 ↓ 새 DB 컨테이너 이름 분리 ↓ team-pgvector 실행 ↓ healthy 확인 ↓ PostgreSQL 접속 ↓ 실제 테이블 확인 처음에는 단순히 Docker Compose로 DB를 실행하는 실습이라고 생각했는데, 여러 서비스를 같은 서버에서 구성하면서 컨테이너를 실행하는 것뿐 아니라 기존 실행 환경과 충돌하지 않도록 관리하는 것도 중요하다 는 것을 직접 확인할 수 있었다. 앞으로 Compose를 실행하다 Conflict 오류가 발생하면 코드나 DB부터 확인하기보다 먼저 기존 컨테이너의 이름과 포트부터 확인해봐야겠다. GitHub 이번 실습에서 배운 Docker Compose와 EC2 실행 환경은 GitHub에도 다시 확인할 수 있도록 정리해두었다. 📂 Docker Compose & EC2 학습 기록 https://github.com/jbbdyee/ai-development-journey/tree/main/DevOps/01-docker-compose-ec2
velog
목차 개념 Spanning Tree Sort by cost Union-Find Kruskal Algorithm 구현 1. 개념 Krushkal Algorithm 그래프에서 MST(Minimum Spanning Tree)를 찾기 위한 Greedy 알고리즘 간선을 하나씩 추가하면서 MST(최소 신장 트리)를 만드는 방식 2. Spanning Tree Tree 사이클이 없는 그래프 Spanning Tree 신장 트리, 모든 vertex를 포함 + 사이클이 없는 edge MST 최소 신장 트리, Weight가 최소인 Spanning Tree 3. Sort by cost edge의 weight를 기준으로 정렬하기 implements comparator의 int compare(Edge e, Edge f) 를 사용하여 비교 기준 선언하기 빨리 추가=-1 / 늦게 추가=1 weight가 클수록 늦게 추가 static class Weight_Comparison implements Comparator<Edge> { // weight를 기준으로 우선순위 큐를 사용하기 위해 public int compare(Edge e, Edge f) { if (e.weight > f.weight) return 1; else if (e.weight < f.weight) return -1; return 0; } } 4. Union-Find Algorithm Union-Find 사이클이 생기는지 확인하기 위한 자료구조 Find vertex가 속한 set의 대표 node(=parent) 찾기 Union 두 vertex가 속한 집합을 하나로 합치기 사이클 조건 두 vertex의 대표 node(=parent)가 동일 = 이미 같은 집합 = 사이클 발생 구현 부모가 동일한지 확인(종료조건) 트리의 depth(=rank) 확인 -> 추가하기 public class UnionFind { protected int[] p; // 배열 크기는 정점의 수 N이고, p[i]는 i의 부모를 저장 protected int[] rank; // level을 저장(depth) ... //i가 속한 집합의 루트를 순환으로 찾고, 최종적으로 경로상의 각 원소의 부모를 루트로 경로 압축 protected int find(int i) { /* 구현 */ //초기조건 if(p[i]==i) return i; //p[i]는 i의 대표 vertex를 저장하므로 p[i]가 i(본인)이 될 때까지 find 수행하기ᄂ p[i]=find(p[i]); return p[i]; } //i와 j가 같은 트리에 있는지를 검사 public boolean isConnected(int i, int j) { return find(i) == find(j); } public void union(int i, int j) { // Union 연산 /* 구현 */ // 부모가 동일한지 확인하기 int parent_i = find(i); int parent_j = find(j); // 동일하면 return if(parent_i == parent_j) return; // 트리의 depth(=rank)를 비교 -> 업데이트(간선 하나씩 묶기) // 낮은 트리 -> 높은 트리 (트리의 전체 높이가 늘어나는 것을 방지) // 같으면 아무쪽에 붙이고 반대쪽에 rank++ 해주기 if(rank[parent_i]<rank[parent_j]) p[parent_i] = parent_j; else if(rank[parent_i]>rank[parent_j]) p[parent_j] = parent_j; else { p[parent_i]=parent_j; rank[parent_j]++; } } } 5. Kruskal Algorithm 구현 [구현] 1. weight를 기준으로 하는 priorityQueue를 생성 2. 중복되지 않도록 edge를 순회하여 priorityQueue에 추가 3. 현재 priorityQueue에서 weight 하나씩 선택하여 같은 tree에 있는지 검사 4. 다름 -> 기존 unionfind에 해당 edge 추가하고, MST에 추가 5. count가 vertex-1이 되면 과정을 종료한다. package Kruskal; import java.util.*; public class KruskalMST { int N, M; // 그래프 정점, 간선의 수 List<Edge>[] graph; UnionFind uf; // Union-Find 연산을 사용하기 위해 Edge[] tree; static class Weight_Comparison implements Comparator<Edge> { // weight를 기준으로 우선순위 큐를 사용하기 위해 public int compare(Edge e, Edge f) { if (e.weight > f.weight) return 1; else if (e.weight < f.weight) return -1; return 0; } } public KruskalMST(List<Edge>[] adjList, int numOfEdges) { N = adjList.length; M = numOfEdges; graph = adjList; uf = new UnionFind(N); // Union-Find 연산을 사용하기 위해 tree = new Edge[N - 1]; // edge = vertex-1 } public Edge[] mst() { // Kruskal 알고리즘 /* 구현 */ // weight 순으로 edge 정렬할 기준 생성 (compare()를 통한 자동비교) PriorityQueue<Edge> sortByWeight = new PriorityQueue<>(new Weight_Comparison()); // 실제로 weight 순으로 정렬하기 for(int i=0; i<N; i++) { if(graph[i]!=null) { for(Edge e: graph[i]) { // 무방향 그래프이므로 (v,a) = (a,v) 동일, 중복 제거하기 if(e.vertex < e.adjvertex) sortByWeight.add(e); } } } //추가한 edge count하기 (N-1(edge 최대 개수)이 될때까지 수행 - 종료조건) int count=0; while(!sortByWeight.isEmpty()) { if(count >= N-1) break; //현재 목록에서 가장 작은 weight를 가진 edge Edge e = sortByWeight.poll(); //같은 tree에 있는지 검사 = 이미 연결되어있는지 검사 (사이클 존재 유무) if(!uf.isConnected(e.vertex, e.adjvertex)) { //새로운 (vertex, adjvertex) edge를 기존 uf에 추가하기 uf.union(e.vertex, e.adjvertex); //선택한 edge -> MST tree에 저장 tree[count] = e; count++; //추가했으니 edge 개수 늘려주기 } } return tree; } }
velog
문제 해결전략 문제를 읽어보면, 가장 멀리 양끝 길이에서부터 진행하는 것이 맞다고 생각해서 투포인터로 접근함. 2개의 값 중에서 가장 작은거를 제외하고 안쪽으로 이동하면서 제외된 값을 변경해서 중간값을 구하고 최대값을 구하는 방식으로 하면 되지 않을까? 생각함. 제미나이 의문점 해결. 의문점. : L ~ R 중에서 작은거를 지워나가는 식의 반대로 생각해보기 L이 R보다 작은 상황에서 L을 지우지 말고, R을 지운상태로 진행한다고 가정하자. 이때 L ~ X (만약에 R보다 X가 크다고 하자.) 그래봤자 어차피 L은 R보다 작은 상황이었기 때문에 아무리 X를 만난다고 하더라도 L과 X중에 계산식에는 L이 선택되는 상황인데, 오히려 L ~ R보다 폭이 좁아진 상태이다. => 반례 발견
Score: 54.4Confidence: 49%
View offervelog
지난 글 에서는 Coroutine 에 대해 다뤘었다. 관련해 설명하면서, 이제는 코루틴은 사용하지 않고 UniTask 로 많이들 넘어가서, UniTask 위주로 사용한다고 설명했다. Coroutine이 밀려나는 이유 간략하게 왜 Coroutine 을 사용하지 않게 된 건지 다시 알아보자. 반환형 사용 불가능 반환형이 사용 불가능하다. Coroutine 은 반드시 IEnuemrator 형을 반환형으로 가져야 하기 때문에, 내부 로직에 의해 산출된 결과물을 받아서 사용할 방법이 없다. 예외 처리 불가능 우리가 Coroutine 을 통해 비동기적으로 처리하고자 하는 작업들은 네트워크 통신, 파일 읽기처럼 오래 걸리는 작업도 포함되는데 예외처리가 불가능하면...문제가 많다. GC 부담 발생 흔히 사용하는 yield return new WaitForSeconds(); 같은 함수를 사용하면 new 이기 때문에 동적할당 발생하면서 GC가 감당해야 할 객체가 늘어난다. 생명주기 종속 생명주기가 Monobehaviour 에 종속되어있는 것도 문제이다. 그래서 MonoBehaviour 가 죽으면 사라지면서 뒤처리를 못하고 상태를 꼬아둔 상태로 사라지는 일도 잦음. UniTask 특징 Unity에 최적화 된 비동기 프로그래밍 라이브러리로, 다음과 같은 특징이 있다. 구조체 기반 -> GC할당 없음 Unity PlayerLoop와 통합 되어 메인 스레드에서 동작 -> Unity 에서의 사용감 좋음 async/await 완벽 지원 -> 직관적, 안정적인 비동기 코드 사용 방법 UniTask 를 어떻게 사용하는지, 문법에 대해 알아보자. 반환 타입 UniTask 가장 기본적인 방식으로, 반환값이 없는 경우에 사용한다. async UniTask DoTask() { await UniTask.Delay(1000); Debug.Log("작업 완료"); } UniTask<T> 비동기 작업의 결과를 반환해야 할 때 사용한다. T 는 제네릭으로, 반환값의 자료형을 명시한다. async UniTask<int> GetScore() { await UniTask.Delay(1000); return 100; } // 호출 int score = await GetScore(); Debug.Log(score); // 100 UniTask<T> 결과를 기다릴 필요 없는, Fire And Forget 전용이라고 보면 된다. 호출 시에 await 의 사용 자체가 불가능함. async UniTaskVoid LogMessageAsync() { await UniTask.Delay(1000); Debug.Log("Fire and Forget"); } // 호출 (await 없음) LogMessageAsync().Forget(); 위의 세 가지 설명에 대해서 그림으로 간단히 요약하면 아래와 같다. 핵심 API 이제 코루틴 내부에서 사용하는 핵심 API에 대해서 알아보자. UniTask.Delay() 특정 시간(ms)만큼 대기한다 async UniTaskVoid MyTask() { await UniTask.Delay(1000); Debug.Log("완료!"); } UniTask.DelayFrame() 특정 프레임 만큼 대기한다. async UniTaskVoid MyTask() { await UniTask.DelayFrame(10); Debug.Log("열 프레임 지남"); } UniTask.Yield() 현재 실행을 중단하고 Unity PlayerLoop에 제어권을 반환한 뒤, 지정된 PlayerLoopTiming에서 실행을 이어간다. 하나의 큰 작업을 나누어 처리할 때 주로 사용함. // 다음 Update까지 대기 await UniTask.Yield(); // 다음 FixedUpdate까지 대기 await UniTask.Yield(PlayerLoopTiming.FixedUpdate); // LateUpdate 이후(PostLateUpdate)까지 대기 await UniTask.Yield(PlayerLoopTiming.PostLateUpdate); UniTask.WhenAll() 병렬로 여러 개의 UniTask작업을 수행하며, 모두 완료될때까지 대기한다. 독립적인 비동기 작업을 순차 실행하는 것보다 빠를 확률이 높다. 물론 그렇다고 멀티스레딩 기반으로 동작하는 것은 아니기에, 내부에 대기 작업이 없다면 빠르지 않기도 하다. // 여러 작업 병렬 실행 async UniTask<string> LoadData1() { /* ... */ } async UniTask<string> LoadData2() { /* ... */ } async UniTask<string> LoadData3() { /* ... */ } // WhenAll로 병렬 실행 var (result1, result2, result3) = await UniTask.WhenAll( LoadData1(), LoadData2(), LoadData3() ); Debug.Log($"{result1}, {result2}, {result3}"); UniTask.WhenAny() 역시 병렬적으로 실행하나, 하나만 완료되면 종료된다. async UniTask<string> Server1() { /* ... */ } async UniTask<string> Server2() { /* ... */ } // 먼저 완료된 작업 사용 // 개별 인자 오버로드는 (winArgumentIndex, result1, result2) 3-튜플을 반환 var (winIndex, result1, result2) = await UniTask.WhenAny( Server1(), Server2() ); var result = winIndex == 0 ? result1 : result2; if (winIndex == 0) Debug.Log("Server1이 먼저 응답"); else Debug.Log("Server2가 먼저 응답"); 이를 통해 TimeOut등을 관리할 수도 있다. 타임아웃용 타이머와 특정 작업을 수행시키고 타이머가 먼저 끝나면 타임아웃으로 처리하는 등의 방법 CancellationToken UniTask는 실행 중간에 취소할 수도 있다. 아래와 같이 사용 가능 // 외부에서 TokenSource 생성 private void StartLevel() { CancellationTokenSource cts = new CancellationTokenSource(); // 토큰 넣어서 호출 MyUniTask(levelCts.Token).Forget(); } // 실행되면, 토큰 무효화됨 private void OnDestroy() { cts.Cancel(); cts.Dispose(); } // 토큰 받아서 실행 async UniTask MyUniTask(CancellationToken ct) { DoTask(); // 2초 대기 도중 cts가 무효화되면 종료됨 await UniTask.Delay(2000, cancellationToken: ct); } CancelltationTokenSource에서 뽑힌 Token은 Source가 Cancel 되면 효력이 사라진다. Cancel 시에는 하는 김에 Dispose 까지 해주면 좋음. CancellationToken 덕분에 UniTask는 생명주기를 보다 편리하게 관리할 수 있게 된다. 정리 Coroutine 도 여전히 간단한 연출이나 시간 제어에는 충분히 사용할 수 있다. 하지만 작업의 결과를 반환해야 하거나, 여러 비동기 작업을 함께 관리하고, 예외 처리와 취소까지 고려해야 한다면 코드가 점점 복잡해진다. UniTask 는 async/await 를 기반으로 이러한 작업들을 비교적 자연스럽게 표현할 수 있고, Unity의 PlayerLoop 와 통합되어 있어 Unity 환경에서도 부담 없이 사용할 수 있다. 특히 CancellationToken 을 이용하면 오브젝트가 사라지거나 더 이상 작업이 필요하지 않은 상황에서 실행 중인 비동기 작업까지 함께 정리할 수 있다. 결국 단순히 Coroutine 의 문법을 UniTask 로 바꾸는 것이 아니라, 비동기 작업의 시작부터 결과 반환, 대기, 예외 처리, 취소까지 하나의 흐름으로 관리할 수 있다는 점 이 UniTask 를 사용하는 가장 큰 이유일 것이다. 우리도 UniTask 를 사용해 보다 효율적으로 비동기 흐름을 구현해보자.
velog
333
Score: 54.4Confidence: 49%
View offerScore: 54.4Confidence: 49%
Score: 54.4Confidence: 49%
Score: 54.4Confidence: 49%