06 · JWT 다루기 💡 한 줄 요약 : JwtUtil에 토큰 생성·전달·추출·검증·Claim 조회 기능을 모읍니다. 구현할 기능 기능 입력 결과 토큰 생성 사용자 식별값, 권한 서명된 JWT 쿠키 저장 토큰, 응답 객체 클라이언트에 토큰 전달 토큰 추출 요청의 쿠키 값 검증할 JWT 문자열 검증 JWT, 서버 키 정상·만료·위변조 판단 Claim 조회 검증된 JWT 사용자 식별값·권한 의존성과 키 설정 implementation 'io.jsonwebtoken:jjwt-api:0.11.5' runtimeOnly 'io.jsonwebtoken:jjwt-impl:0.11.5' runtimeOnly 'io.jsonwebtoken:jjwt-jackson:0.11.5' jwt.secret.key=${JWT_SECRET_KEY} 여기서 환경변수에는 충분한 길이의 임의 키를 Base64로 인코딩한 값을 넣습니다. HS256에는 최소 256비트의 키가 필요합니다. Base64는 키를 숨기는 암호화가 아니라 문자열 표현 방식입니다. @Value("${jwt.secret.key}") private String secretKey; private Key key; @PostConstruct public void init() { byte[] bytes = Base64.getDecoder().decode(secretKey); key = Keys.hmacShaKeyFor(bytes); } @PostConstruct 는 의존성 주입 이후 초기화에 활용됩니다. 설정값을 읽은 뒤 실제 서명·검증에 사용할 Key를 준비합니다. 토큰 생성 private static final String BEARER_PREFIX = "Bearer "; private static final long TOKEN_TIME = 60 * 60 * 1000L; public String createToken(String username, UserRoleEnum role) { Date now = new Date(); String jwt = Jwts.builder() .setSubject(username) .claim("auth", role.name()) .setIssuedAt(now) .setExpiration(new Date(now.getTime() + TOKEN_TIME)) .signWith(key, SignatureAlgorithm.HS256) .compact(); return BEARER_PREFIX + jwt; } setSubject() 에는 사용자 식별값을 넣습니다. claim() 으로 권한 같은 값을 추가합니다. setExpiration() 은 토큰의 유효기간을 지정합니다. signWith() 는 서명에 사용할 키·알고리즘을 지정합니다. Bearer 는 JWT 자체의 일부가 아니라 토큰을 전달할 때 붙이는 접두어입니다. 쿠키로 전달하기 public void addJwtToCookie(String token, HttpServletResponse response) { String encoded = URLEncoder.encode(token, StandardCharsets.UTF_8) .replace("+", "%20"); Cookie cookie = new Cookie("Authorization", encoded); cookie.setPath("/"); response.addCookie(cookie); } 요청에서 같은 이름의 쿠키를 찾고 URL 디코딩한 뒤 토큰을 사용합니다. 📝 전달 방식 : 이름이 Authorization 인 쿠키와 Authorization HTTP 헤더는 서로 다릅니다. 이번 흐름은 쿠키에서 토큰을 읽습니다. 헤더 방식으로 바꾸려면 클라이언트 전송과 서버 추출 코드를 함께 바꿉니다. Bearer 접두어 제거 public String substringToken(String tokenValue) { if (tokenValue == null || !tokenValue.startsWith(BEARER_PREFIX)) { throw new IllegalArgumentException("토큰 형식이 올바르지 않습니다."); } String token = tokenValue.substring(BEARER_PREFIX.length()); if (token.isBlank()) { throw new IllegalArgumentException("토큰이 비어 있습니다."); } return token; } 서명·만료 검증과 Claim 조회 public Claims parseClaims(String token) { return Jwts.parserBuilder() .setSigningKey(key) .build() .parseClaimsJws(token) .getBody(); } 위 메서드는 단순히 문자열을 디코딩하는 작업이 아닙니다. 서명·만료 등의 검증에 실패하면 예외가 발생합니다. 상황 의미 만료된 토큰 허용된 사용 시간이 지남 서명 불일치 토큰 변경 또는 잘못된 검증 키 잘못된 형식 정상적인 JWT 구조가 아님 빈 토큰 검증할 문자열이 없음 Claims claims = jwtUtil.parseClaims(token); String username = claims.getSubject(); String role = claims.get("auth", String.class); 검증 함수와 정보 추출 함수를 따로 만들 수도 있지만, 같은 요청에서 검증을 마친 Claim을 재사용하면 중복 파싱을 줄일 수 있습니다. 복습 체크 토큰에 넣는 사용자 식별값·권한·발급일·만료일을 설명할 수 있습니다. 쿠키 URL 디코딩과 JWT 서명 검증을 구분할 수 있습니다. Bearer 를 제거한 뒤 검증해야 하는 이유를 설명할 수 있습니다. 위변조·만료된 토큰에서 사용자 정보를 그대로 신뢰하지 않습니다. 07 · 회원가입 구현 💡 한 줄 요약 : 회원 중복·역할을 확인하고 비밀번호를 해시한 뒤 회원 정보를 DB에 저장합니다. User에 필요한 정보 필드 역할 확인할 조건 id DB 식별값 기본 키 username 로그인에 사용할 회원 ID 중복 불가 password 비밀번호 해시 평문 저장하지 않음 email 이메일 중복·형식 확인 role 사용자 역할 USER 또는 ADMIN @Entity @Table(name = "users") @Getter @NoArgsConstructor public class User { @Id @GeneratedValue(strategy = GenerationType.IDENTITY) private Long id; @Column(nullable = false, unique = true) private String username; @Column(nullable = false) private String password; @Column(nullable = false, unique = true) private String email; @Enumerated(EnumType.STRING) @Column(nullable = false) private UserRoleEnum role; public User(String username, String password, String email, UserRoleEnum role) { this.username = username; this.password = password; this.email = email; this.role = role; } } EnumType.STRING 은 역할의 문자열 이름을 저장합니다. 순서 번호로 저장하는 방식과 구분합니다. Repository 조회 메서드 public interface UserRepository extends JpaRepository<User, Long> { Optional<User> findByUsername(String username); Optional<User> findByEmail(String email); } 회원가입 처리 순서 요청 DTO에서 아이디·비밀번호·이메일 등을 받습니다. 같은 아이디 또는 이메일이 이미 존재하는지 확인합니다. 기본 역할을 USER 로 지정합니다. 관리자 가입을 요청했다면 별도 승인 조건을 확인합니다. PasswordEncoder.encode() 로 비밀번호를 해시합니다. User Entity를 만들고 저장합니다. public void signup(SignupRequestDto requestDto) { if (userRepository.findByUsername(requestDto.getUsername()).isPresent()) { throw new IllegalArgumentException("중복된 사용자입니다."); } if (userRepository.findByEmail(requestDto.getEmail()).isPresent()) { throw new IllegalArgumentException("중복된 이메일입니다."); } // 이 축약 예제는 일반 사용자 가입만 보여줍니다. String encoded = passwordEncoder.encode(requestDto.getPassword()); User user = new User( requestDto.getUsername(), encoded, requestDto.getEmail(), UserRoleEnum.USER ); userRepository.save(user); } 비밀번호는 왜 matches()로 비교할까? BCrypt는 같은 비밀번호라도 Salt 때문에 해시 문자열이 달라질 수 있습니다. 입력 비밀번호를 다시 encode() 해서 저장된 문자열과 equals() 로 비교하지 않습니다. boolean matched = passwordEncoder.matches(inputPassword, storedHash); 실습의 관리자 가입 방식 관리자 가입 여부와 별도 관리자 토큰을 받아, 토큰이 맞으면 ADMIN 역할을 저장하는 흐름입니다. 사용자가 보낸 admin=true 만으로 관리자 권한을 부여하지 않습니다. 실제 권한 부여에는 승인된 관리자의 변경 기능 등 별도의 절차가 필요합니다. 📝 중복 확인 : 서비스에서 먼저 조회하면 사용자에게 오류를 안내하기 쉽습니다. 다만 동시에 가입 요청이 들어오는 경우도 있으므로 DB의 Unique 제약조건도 함께 적용합니다. 복습 체크 DTO와 User Entity의 역할을 구분할 수 있습니다. 회원가입 때 비밀번호 해시를 저장할 수 있습니다. 중복 조회와 DB Unique 제약조건이 각각 필요한 이유를 설명할 수 있습니다. 클라이언트가 보낸 값만으로 관리자 권한을 부여하지 않습니다. 08 · 로그인 구현 · JWT 💡 한 줄 요약 : 회원과 비밀번호를 확인한 뒤 해당 사용자의 JWT를 발급합니다. 로그인 요청 기능 메서드 경로 처리 로그인 화면 GET /api/user/login-page 화면 반환 로그인 POST /api/user/login 자격 증명 확인·토큰 발급 @Getter @Setter public class LoginRequestDto { private String username; private String password; } Service에서 직접 처리하는 단계 public void login(LoginRequestDto requestDto, HttpServletResponse response) { User user = userRepository.findByUsername(requestDto.getUsername()) .orElseThrow(() -> new IllegalArgumentException("로그인 정보가 일치하지 않습니다.")); if (!passwordEncoder.matches(requestDto.getPassword(), user.getPassword())) { throw new IllegalArgumentException("로그인 정보가 일치하지 않습니다."); } String token = jwtUtil.createToken(user.getUsername(), user.getRole()); jwtUtil.addJwtToCookie(token, response); } 확인해야 할 결과 상황 기대 동작 존재하는 회원·올바른 비밀번호 JWT 발급 존재하지 않는 회원 로그인 실패 잘못된 비밀번호 로그인 실패 정상 로그인 후 API 요청 발급받은 토큰으로 사용자 확인 이 단계에서는 Service가 직접 비밀번호를 비교합니다. 이후 Spring Security를 적용하면 인증 관리자·Provider가 인증을 처리하도록 연결합니다. 로그아웃과 토큰 유효기간 클라이언트의 쿠키를 삭제하면 해당 브라우저가 토큰을 보내지 않게 됩니다. 하지만 이미 발급된 토큰의 서명·만료 상태가 자동으로 바뀌지는 않습니다. 복사된 토큰까지 즉시 차단하려면 별도의 폐기 정책이 필요합니다. 복습 체크 로그인 성공 시에만 JWT가 발급되는 위치를 설명할 수 있습니다. 로그인 때 저장된 비밀번호 해시를 복호화하지 않습니다. 쿠키 삭제와 서버 측 토큰 무효화의 차이를 설명할 수 있습니다.
Designing Better Product Pages for Visual E-commerce Catalogs Building an e-commerce product page looks straightforward at first. You need a title, price, images, description, options, and an add-to-cart button. Then the real requirements begin appearing. A product has twelve images. Another has two sizes and five finishes. A third belongs to several categories. Mobile users need the important information immediately, while desktop users expect a richer gallery. Search engines need structured information. Images need to remain sharp without making the page painfully slow. Visual product categories such as furniture make these problems especially obvious. Working through this type of interface reveals several lessons that apply to almost any e-commerce frontend. 1. Treat the Product Page as Structured Data One of the easiest mistakes is building the UI first and then forcing product information into it. A better approach is to define the product model first. For example: const product = { name: "Upholstered Bed", price: 145000, currency: "PKR", category: "Beds", images: [], variants: [ { name: "Size", options: ["Queen", "King"] } ], dimensions: { width: null, depth: null, height: null }, material: [], availability: "made-to-order" }; The exact schema will differ between stores, but the principle remains the same. Product information should exist independently of presentation. This makes it easier to: render different layouts on mobile and desktop build filters generate structured data create comparison tools support future APIs reuse product information elsewhere It also prevents important specifications from becoming random strings buried inside HTML. 2. Product Images Are Usually the Biggest Performance Problem Visual stores often need large images because customers want to inspect materials, texture, proportions, and construction. The problem is that large photographs can destroy page performance. If a page loads ten full-resolution images immediately, the browser may download several megabytes before the visitor has even scrolled. A better strategy is to load the primary image first and defer the rest. <img src="/images/product-main.webp" alt="Upholstered bed viewed from the front" width="1200" height="900" fetchpriority="high" /> <img src="/images/product-side.webp" alt="Side view of upholstered bed" width="1200" height="900" loading="lazy" /> The first image contributes heavily to perceived page speed, so it deserves priority. Gallery images further down the page usually do not. Modern formats such as WebP or AVIF can also reduce file size significantly compared with unnecessarily large JPEG or PNG files. But compression alone is not enough. The browser should also receive an image close to the size it actually needs. <img srcset=" product-480.webp 480w, product-800.webp 800w, product-1200.webp 1200w " sizes="(max-width: 768px) 100vw, 50vw" src="product-800.webp" alt="Product view" /> A phone should not download the same enormous image intended for a large desktop monitor. 3. A Gallery Should Answer Questions, Not Just Look Attractive It is tempting to treat product photography as decoration. For e-commerce, every image should ideally answer something. Customers may want to know: What does the product look like from the front? How deep is it? What does the back look like? How does the material appear close up? What is its scale inside a room? Are there visible seams or joints? What changes between variants? That means gallery architecture should be intentional. A useful pattern might be: 1. Hero view 2. Angled view 3. Side view 4. Rear view 5. Detail close-up 6. Material close-up 7. Lifestyle image 8. Dimension reference This is far more useful than uploading eight nearly identical photographs. 4. Variant Selection Needs to Be Obvious Variants often introduce unnecessary friction. Suppose a bed is available in Queen and King sizes. A user should be able to understand three things immediately: which options exist which option is currently selected whether choosing an option changes the price The interface should never make visitors guess. A simple component can work: function SizeSelector({ sizes, selected, onChange }) { return ( <div className="size-selector"> {sizes.map((size) => ( <button key={size} aria-pressed={selected === size} onClick={() => onChange(size)} > {size} </button> ))} </div> ); } The same pattern can support finishes, upholstery choices, module configurations, or other product variations. The important part is that state remains explicit. 5. Don't Hide Dimensions For furniture and other physical products, dimensions are not secondary information. They may determine whether the customer can use the product at all. Yet many stores bury measurements inside long paragraphs or expandable descriptions. A better interface exposes important specifications in a predictable structure. For example: Overall Width 82 in Overall Depth 36 in Overall Height 32 in Seat Height 18 in Using semantic markup also helps accessibility: <dl> <dt>Overall Width</dt> <dd>82 inches</dd> <dt>Overall Depth</dt> <dd>36 inches</dd> <dt>Overall Height</dt> <dd>32 inches</dd> </dl> The <dl> element is appropriate because each measurement has a clearly defined label and value. 6. Design Mobile First, Especially Around the Purchase Decision Desktop product pages have plenty of horizontal space. Mobile pages do not. This forces an important prioritization question: What does someone need before deciding whether to continue? Usually: Product image Product name Price Variant selection Availability Primary action Detailed materials, care instructions, FAQs, warranties, and long descriptions can appear later. This does not mean hiding information. It means arranging information according to decision priority. A page that begins with five screens of marketing copy before showing the size or price is technically complete but practically frustrating. 7. Real Catalogs Reveal Problems Mockups Don't Designing with three placeholder products can hide architectural weaknesses. Real catalogs expose them. Some products have one price. Others have ranges. Some have variants. Some belong to several categories. Some require numerous images. Names vary dramatically in length. Looking through a real furniture e-commerce catalog is useful because it quickly shows why product-card and product-page components need to support varied content rather than assuming every item follows an identical structure. For example, a rigid product card may break when: Product A: Short name + fixed price Product B: Long name + price range Product C: Sale price + regular price Product D: Multiple configurations Designing against realistic content is one of the easiest ways to discover these edge cases early. 8. Structured Data Should Come From the Same Product Model SEO metadata should not require manually rewriting product data. If the frontend already knows the name, SKU, price, currency, availability, images, and variants, those fields can feed structured data too. Conceptually: const schema = { "@context": "https://schema.org", "@type": "Product", name: product.name, image: product.images, sku: product.sku, offers: { "@type": "Offer", priceCurrency: product.currency, price: product.price } }; The real implementation may require more detail, particularly for variants, but maintaining a single source of truth reduces inconsistencies. 9. Accessibility and Conversion Often Point in the Same Direction Accessibility is sometimes treated as an extra requirement. In product interfaces, accessibility improvements often make the experience better for everyone. Examples include: descriptive image alt text properly labelled variant controls visible keyboard focus sufficient text contrast semantic headings buttons instead of clickable <div> elements clear form validation A customer should not need perfect eyesight, a mouse, or prior knowledge of the interface to understand how to choose a product. Good accessibility usually means clearer UI. Final Thought A strong e-commerce product page is not simply a collection of attractive components. It is a system for turning complex product information into a fast and understandable decision-making experience. For image-heavy categories, the most important frontend lessons are surprisingly practical: optimize images aggressively, model product data properly, expose important specifications early, treat variants as real application state, test with realistic catalog content, and prioritize mobile usability. The visual design still matters. But once someone begins seriously considering a purchase, clarity and performance matter just as much.
09 · 필터 💡 한 줄 요약 : Filter는 요청·응답의 공통 처리를 Controller 바깥에서 수행합니다. Filter의 위치와 역할 HTTP 요청은 Servlet 필터들을 거친 뒤 DispatcherServlet으로 들어갑니다. 필터는 로깅·인증 같은 공통 처리를 수행하거나 요청 진행을 중단할 수 있습니다. 작업 활용 예 전처리 요청 URL 기록, 토큰 확인 다음 단계 실행 chain.doFilter(request, response) 후처리 하위 처리 완료 뒤 로그 기록 흐름 중단 인증 실패 응답 반환 LoggingFilter 예제 @Component @Order(1) @Slf4j public class LoggingFilter implements Filter { @Override public void doFilter(ServletRequest request, ServletResponse response, FilterChain chain) throws IOException, ServletException { HttpServletRequest httpRequest = (HttpServletRequest) request; log.info("요청: {}", httpRequest.getRequestURI()); chain.doFilter(request, response); log.info("하위 요청 처리 완료"); } } Filter Chain에서 실행되는 순서 첫 필터의 전처리를 실행합니다. chain.doFilter() 로 다음 필터를 호출합니다. 마지막 필터 이후 Servlet이 요청을 처리합니다. 처리가 끝나면 호출이 되돌아오면서 후처리를 실행합니다. 📝 흐름 이해 : chain.doFilter() 다음 줄은 하위 처리가 정상 반환한 뒤 실행됩니다. 하위에서 예외가 발생해도 반드시 수행해야 하는 작업은 try/finally 등으로 구성합니다. 직접 만든 인증 필터의 처리 로그인·회원가입·정적 자원처럼 공개할 경로인지 확인합니다. 인증이 필요한 경로라면 JWT를 찾습니다. 토큰을 검증하고 사용자 정보를 조회합니다. 필요한 정보를 요청 객체에 담습니다. 정상 요청만 다음 단계로 넘깁니다. // 개념을 보여주는 발췌 예제 Claims claims = jwtUtil.parseClaims(token); User user = userRepository.findByUsername(claims.getSubject()) .orElseThrow(() -> new IllegalArgumentException("회원이 없습니다.")); request.setAttribute("user", user); chain.doFilter(request, response); 이 방식의 request.setAttribute() 와 Spring Security의 SecurityContext 는 서로 다른 저장 방식입니다. 복습 체크 chain.doFilter() 가 없으면 요청이 계속 진행되지 않는 이유를 설명할 수 있습니다. 요청 전처리와 응답 후처리의 순서를 설명할 수 있습니다. 인증 로직을 여러 Controller에 반복하지 않고 분리할 수 있습니다. 10 · Spring Security 프레임워크 💡 한 줄 요약 : Spring Security는 보안 필터와 인증·인가 기능을 제공해 요청 접근을 제어합니다. 적용 효과 직접 구현할 때 Spring Security를 활용할 때 요청마다 인증 확인 로직 작성 보안 필터 체인으로 공통 처리 URL별 접근 조건을 직접 분기 접근 정책을 설정으로 선언 사용자 정보를 별도 방식으로 전달 Authentication·SecurityContext 활용 로그인 처리 흐름 직접 구성 인증 관리자·Provider 등 활용 주요 구성 요소 요소 역할 SecurityFilterChain 특정 요청에 적용할 보안 필터 체인 HttpSecurity 접근 정책·로그인·필터 등을 설정하는 구성 객체 Authentication 인증 요청 또는 인증 결과를 나타내는 객체 SecurityContext 현재 인증 정보를 담는 컨텍스트 SecurityContextHolder 현재 실행 흐름에서 컨텍스트에 접근 기본 접근 정책 @Configuration @EnableWebSecurity public class WebSecurityConfig { @Bean public SecurityFilterChain securityFilterChain(HttpSecurity http) throws Exception { http.authorizeHttpRequests(auth -> auth .requestMatchers("/css/**", "/js/**", "/api/user/**").permitAll() .anyRequest().authenticated() ); http.formLogin(Customizer.withDefaults()); return http.build(); } } permitAll() 은 해당 접근 규칙에서 인증 없이도 접근을 허용합니다. authenticated() 는 인증된 사용자에게 접근을 허용합니다. permitAll() 이 필터 체인을 통째로 건너뛰게 하는 것은 아닙니다. 경로 규칙은 구체적인 조건을 먼저, 나머지 조건을 마지막에 둡니다. CSRF 이해하기 CSRF는 브라우저가 자동으로 전송하는 인증 정보 등을 이용해 사용자가 의도하지 않은 요청을 보내게 하는 공격입니다. 폼 기반 요청에서는 CSRF 토큰을 함께 제출하도록 구성할 수 있습니다. 실습의 JWT 설정에서는 csrf.disable() 을 사용하지만 이를 모든 서비스의 공통 정답으로 적용하지 않습니다. JWT를 쿠키에 넣으면 브라우저가 자동 전송하므로, JWT나 REST라는 이름만으로 CSRF 위험이 없어지지 않습니다. 📝 정리 : 인증 정보를 어디에 저장하고 어떻게 요청에 실어 보내는지에 따라 CSRF 정책을 결정합니다. 복습 체크 공개 경로와 인증 필요 경로를 나누어 설정할 수 있습니다. SecurityFilterChain 과 일반 Controller의 역할을 구분할 수 있습니다. JWT 사용 여부만으로 CSRF 설정을 결정하지 않습니다.
14 · Validation 💡 한 줄 요약 : DTO에 데이터 조건을 선언하고 @Valid 로 요청값을 검증합니다. 왜 입력값을 검증할까? 필요한 값이 누락된 요청을 처리 전에 발견합니다. 잘못된 길이·형식·수치 범위의 데이터를 막습니다. 여러 곳에서 반복하는 단순 검증을 DTO 조건으로 표현합니다. 클라이언트 검증만으로 서버 데이터의 정확성을 보장할 수 없으므로 서버에서도 확인합니다. 주요 애너테이션 애너테이션 검증하는 조건 @NotNull null이 아님 @NotEmpty null이 아니며 비어 있지 않음 @NotBlank 문자열이 null·빈 문자열·공백 문자열이 아님 @Size 문자열·컬렉션 등의 크기 범위 @Min , @Max 수치의 최소·최대 범위 @Positive , @Negative 양수·음수 @Email 이메일 형식 @Pattern 정규 표현식 일치 NotNull·NotEmpty·NotBlank 비교 입력 @NotNull @NotEmpty @NotBlank null 실패 실패 실패 "" 통과 실패 실패 " " 통과 통과 실패 "hello" 통과 통과 통과 DTO에 조건 선언 @Getter @Setter public class SignupRequestDto { @NotBlank(message = "아이디는 필수입니다.") private String username; @NotBlank(message = "비밀번호는 필수입니다.") private String password; @NotBlank(message = "이메일은 필수입니다.") @Email(message = "이메일 형식이 올바르지 않습니다.") private String email; } @Email , @Pattern , @Size 같은 조건만으로 필수 입력까지 항상 보장되는 것은 아닙니다. 값의 필수 여부는 적절한 조건과 조합합니다. 검증 실행 implementation 'org.springframework.boot:spring-boot-starter-validation' @PostMapping("/api/users") public ResponseEntity<Void> signup(@RequestBody @Valid SignupRequestDto dto) { userService.signup(dto); return ResponseEntity.status(201).build(); } Bean Validation과 서비스 검증 구분 검증할 내용 위치 입력 형식 공백·길이·이메일 형식 DTO 제약조건 비즈니스 규칙 이메일 중복·가입 가능 여부 Service 데이터 무결성 Unique·Not Null 등 DB 제약조건 DTO에서 이메일 형식이 정상이어도 이미 가입된 이메일인지는 DB 조회로 확인해야 합니다. 복습 체크 공백 문자열을 차단할 조건을 선택할 수 있습니다. DTO에 조건을 선언한 뒤 @Valid 로 검증을 실행할 수 있습니다. 입력 형식 검증·비즈니스 검증·DB 제약조건을 구분할 수 있습니다. 15 · Validation 예외처리 💡 한 줄 요약 : 검증 결과를 확인해 잘못된 요청에서는 가입 처리를 중단하고 오류를 안내합니다. 검증 실패 후 처리 흐름 요청 데이터를 DTO로 받습니다. @Valid 가 제약조건을 검사합니다. 오류가 있으면 필드별 오류 정보를 확인합니다. 정상 데이터일 때만 Service를 호출합니다. 오류가 있으면 회원가입 화면 또는 오류 응답을 반환합니다. BindingResult로 결과 받기 @PostMapping("/api/user/signup") public String signup(@Valid @ModelAttribute SignupRequestDto dto, BindingResult bindingResult) { if (bindingResult.hasErrors()) { return "signup"; } userService.signup(dto); return "redirect:/api/user/login-page"; } BindingResult 는 검증 대상 바로 다음 매개변수에 둡니다. hasErrors() 로 오류 여부를 확인합니다. 오류가 있을 때 Service를 실행하지 않도록 분기합니다. 정상 가입일 때만 로그인 화면으로 이동합니다. 필드별 오류 확인 for (FieldError error : bindingResult.getFieldErrors()) { String field = error.getField(); String message = error.getDefaultMessage(); log.info("검증 실패: {} - {}", field, message); } 비밀번호 등 입력한 원문을 로그에 남기지 않고, 필드명·오류 메시지 중심으로 확인합니다. 화면 반환과 redirect 차이 처리 의미 검증 오류와의 관계 return "signup" 현재 요청에서 템플릿 렌더링 현재 바인딩·검증 정보를 활용 가능 return "redirect:/..." 브라우저가 새 요청 전송 오류·입력값 전달을 별도로 구성해야 함 검증 실패 후 화면으로 돌아갔다고 해서 오류 문구가 자동으로 눈에 보이는 것은 아닙니다. 템플릿에서 해당 필드의 오류를 표시하도록 연결합니다. JSON API라면? 화면 이동 대신 클라이언트가 해석할 수 있는 오류 상태·필드별 메시지를 반환합니다. @RequestBody @Valid 검증 실패는 예외 처리 흐름으로 연결할 수 있으며, 폼의 화면 반환 방식과 구분합니다. { "message": "입력값을 확인해 주세요.", "errors": { "email": "이메일 형식이 올바르지 않습니다." } } 복습 체크 BindingResult의 위치와 역할을 설명할 수 있습니다. 오류가 있으면 회원 저장을 실행하지 않도록 처리할 수 있습니다. 템플릿 반환과 redirect의 차이를 설명할 수 있습니다. 화면용 오류 처리와 JSON API용 오류 처리를 구분할 수 있습니다.
CPU는 메모리에 저장된 명령어를 읽고 해석하여 실행한다. 그 과정에서 ALU는 실제 계산을 담당 하고, 제어장치는 명령어를 해석하여 컴퓨터의 여러 부품이 어떻게 동작할지 제어 신호를 보낸다. 한 줄 요약: ALU는 계산하고, 제어장치는 명령어를 해석해 각 부품을 제어한다. 핵심 요약 ALU 는 산술·논리 연산을 수행한다. ALU는 레지스터에서 피연산자 , 제어장치에서 제어 신호 를 받는다. ALU는 연산 결과와 함께 플래그 를 내보낸다. 연산 결과는 주로 레지스터 에 저장된다. 플래그 는 연산 결과에 대한 추가 정보를 나타낸다. 제어장치 는 명령어를 해석하고 CPU 내부와 외부에 제어 신호 를 보낸다. 1. CPU의 내부 구성 앞서 CPU에는 크게 다음과 같은 구성 요소가 있다고 배웠다. CPU │ ├─ ALU │ └─ 계산 │ ├─ 제어장치 │ └─ 명령어 해석 및 제어 │ └─ 레지스터 └─ 임시 데이터 저장 이번 강의에서는 이 중 ALU와 제어장치 를 자세히 살펴본다. 2. ALU란? ALU(Arithmetic Logic Unit) 는 CPU 내부에서 계산을 담당하는 장치 다. 이름 그대로 크게 두 종류의 연산을 수행한다. Arithmetic → 산술 연산 Logic → 논리 연산 예를 들어 10 + 20 10 - 5 A AND B A OR B 같은 계산을 처리한다. 하지만 ALU가 계산하려면 두 가지 정보가 필요하다. 계산할 값 어떤 계산을 수행할지 3. ALU가 받아들이는 정보 ALU는 크게 피연산자와 제어 신호 를 받아들인다. 레지스터 │ │ 피연산자 ↓ ┌─────────┐ │ ALU │ └─────────┘ ↑ │ 제어 신호 │ 제어장치 피연산자 피연산자(Operand) 는 계산에 사용되는 값이다. 예를 들어 10 + 20 이라면 10, 20 → 피연산자 + → 수행할 연산 이다. ALU는 이러한 피연산자를 레지스터를 통해 전달받는다. 제어 신호 ALU가 어떤 연산을 수행해야 하는지는 제어장치가 보내는 제어 신호 를 통해 전달받는다. 피연산자 + 제어 신호 ↓ ALU ↓ 연산 수행 4. ALU가 내보내는 정보 ALU가 연산을 끝내면 크게 두 종류의 정보를 내보낸다. ALU │ ├─ 연산 결과 │ └─ 플래그 연산 결과 예를 들어 ALU가 10 + 20 을 계산했다면 30 이라는 결과가 만들어진다. 이 결과는 일반적으로 레지스터에 저장 된다. ALU ↓ 연산 결과 ↓ 레지스터 왜 바로 메모리에 저장하지 않을까? CPU가 레지스터에 접근하는 것이 메모리에 접근하는 것보다 빠르기 때문 이다. 연산할 때마다 결과를 메모리에 저장한다면 메모리 접근 횟수가 증가한다. 따라서 CPU 내부에서 사용할 값은 레지스터를 적극적으로 활용한다. 5. 플래그란? ALU는 단순히 계산 결과만 내놓는 것이 아니다. 연산 결과에 대한 추가 정보 도 함께 내보내는데, 이를 플래그(Flag) 라고 한다. 예를 들어 결과가 0인지? 음수인지? 자리 올림이 발생했는지? 오버플로우가 발생했는지? 같은 정보를 나타낼 수 있다. 플래그 정보는 플래그 레지스터(Flag Register) 에 저장된다. 대표적인 플래그 플래그 의미 부호 플래그 연산 결과의 부호 정보 제로 플래그 연산 결과가 0인지 캐리 플래그 올림수나 빌림수가 발생했는지 오버플로우 플래그 오버플로우가 발생했는지 인터럽트 플래그 인터럽트를 허용할 수 있는지 슈퍼바이저 플래그 커널/사용자 모드 관련 정보 제로 플래그 예시 10 - 10 ↓ 0 결과가 0 이므로 제로 플래그 를 통해 이를 알 수 있다. 오버플로우 플래그 CPU가 표현할 수 있는 범위를 벗어난 연산 결과가 발생했는지를 나타낸다. 즉, 플래그는 CPU가 이후 명령어를 처리할 때 사용할 수 있는 연산 결과에 대한 상태 정보 라고 생각하면 된다. 6. 제어장치란? 제어장치(Control Unit) 는 명령어를 해석하고 컴퓨터의 여러 부품에 제어 신호를 보내는 장치 다. 쉽게 생각하면 ALU → 실제 계산 담당 제어장치 → 무엇을 해야 할지 지시 라고 구분할 수 있다. 7. 제어장치가 받아들이는 정보 제어장치는 크게 다음과 같은 정보를 받아들인다. 제어장치 ← 클럭 ← 해석할 명령어 ← 플래그 ← 외부에서 들어오는 제어 신호 1 클럭 클럭(Clock) 은 컴퓨터의 여러 부품이 움직이는 시간 단위 역할을 하는 신호 다. Tick → Tick → Tick → Tick 처럼 일정한 박자에 맞춰 발생한다. 컴퓨터 부품들은 이 클럭 신호에 맞춰 작업을 수행한다. 클럭이 한 번 발생할 때마다 반드시 하나의 명령어가 끝난다는 의미는 아니다. 하나의 명령어가 실행되는 데 여러 클럭이 필요할 수도 있다. 2 해석할 명령어 제어장치의 중요한 역할 중 하나가 명령어 해석 이다. 앞에서 명령어는 연산 코드 + 오퍼랜드 로 구성된다고 배웠다. 제어장치는 현재 실행할 명령어를 받아 어떤 연산을 해야 하는가? 어떤 부품을 움직여야 하는가? 를 판단한다. 3 플래그 제어장치는 플래그 레지스터의 값 도 참고한다. 예를 들어 이전 연산 결과가 0인지 음수인지 오버플로우가 발생했는지 등을 확인하여 이후 동작을 결정하는 데 사용할 수 있다. 4 제어 신호 CPU 외부에서도 제어 신호가 들어올 수 있다. 즉, 제어 신호는 제어장치만 만들어내는 것이 아니다. 입출력장치 등 외부 장치에서도 CPU로 제어 신호가 전달될 수 있다. 8. 제어장치가 내보내는 정보 제어장치는 명령어를 해석한 뒤 제어 신호를 내보낸다. 이 신호는 크게 CPU 내부 와 외부 로 나눠 생각할 수 있다. CPU 내부 제어장치 │ ├─→ ALU │ └─→ 레지스터 예를 들어 ALU에 "덧셈을 수행해라" 와 같은 제어 신호를 보낼 수 있다. 레지스터에도 데이터를 저장하거나 이동하기 위한 제어 신호를 전달한다. CPU 외부 CPU 외부의 메모리 입출력장치 에도 제어 신호를 전달한다. 예를 들어 메모리에 "이 주소의 데이터를 읽어라" "이 주소에 데이터를 저장해라" 와 같은 동작을 요청할 수 있다. 9. ALU와 제어장치 한 번에 이해하기 전체 흐름을 간단하게 보면 다음과 같다. 명령어 ↓ ┌───────────┐ │ 제어장치 │ └───────────┘ ↓ ↓ 제어 신호 제어 신호 ↓ 레지스터 → ALU │ │ 피연산자 │ └──────→ │ ↓ 연산 ↓ ┌──────┴──────┐ ↓ ↓ 연산 결과 플래그 ↓ ↓ 레지스터 플래그 레지스터 즉, 제어장치가 무엇을 할지 결정하고, ALU가 실제 계산을 수행한다. 라고 기억하면 이해하기 쉽다. 게임 개발과 연결해서 생각하기 C#에서 다음 코드를 실행한다고 생각해보자. int currentHp = 100; int damage = 30; currentHp -= damage; if (currentHp == 0) { // 사망 처리 } 개발자 입장에서는 단순한 코드지만 CPU 수준에서는 필요한 값 준비 ↓ ALU에서 뺄셈 수행 ↓ 결과 저장 ↓ 비교 연산 수행 ↓ 연산 결과에 따른 상태 확인 ↓ 다음 명령어 결정 같은 과정이 필요하다. C# 코드가 CPU에서 그대로 실행되는 것은 아니지만, 최종적으로 기계 명령어가 실행될 때 레지스터·ALU·제어장치가 서로 협력한다는 큰 그림 을 이해하는 것이 중요하다. 이 내용은 이후 CPU 레지스터 명령어 사이클 조건 분기 CPU 성능 명령어 병렬 처리 등을 이해하는 기반이 된다. 질문 포인트 Q. ALU의 역할은 무엇인가요? ALU는 CPU 내부에서 산술 및 논리 연산을 담당한다. 레지스터로부터 피연산자를 받고 제어장치로부터 제어 신호를 받아 연산한다. Q. 플래그란 무엇인가요? ALU의 연산 결과에 대한 부가적인 상태 정보다. 결과가 0인지, 부호가 무엇인지, 캐리나 오버플로우가 발생했는지 등을 나타낼 수 있다. Q. 제어장치의 역할은 무엇인가요? 명령어를 해석하고 CPU 내부의 ALU와 레지스터, CPU 외부의 메모리와 입출력장치 등에 제어 신호를 보내 각 부품의 동작을 제어한다. 오늘의 정리 이번 강의에서 기억해야 할 핵심은 다음과 같다. ALU는 실제 계산을 담당한다. ALU는 레지스터에서 피연산자를 받고 제어장치에서 제어 신호를 받는다. ALU는 연산 결과와 플래그를 내보낸다. 플래그는 연산 결과에 대한 추가적인 상태 정보다. 제어장치는 명령어를 해석한다. 제어장치는 CPU 내부와 외부에 제어 신호를 보낸다. 클럭은 컴퓨터 부품들이 동작하는 시간 단위 역할을 하는 신호다. 핵심 암기: ALU = 계산 제어장치 = 명령어 해석 + 제어 신호 CPU의 동작을 이해할 때는 제어장치가 무엇을 해야 할지 지시하고, ALU가 실제 연산을 수행하며, 레지스터가 필요한 값을 빠르게 보관한다 는 관계를 먼저 기억하자.
📌 오늘의 주요 작업 오늘은 언리얼 멀티플레이 강의를 들으며 학습했다. 주요 내용은 다음과 같다. NetMode로 서버와 클라이언트 구분하기 액터의 Ownership과 Owning Connection 서버와 클라이언트에 존재하는 객체 클라이언트에서 GameMode에 접근할 때 주의할 점 1. NetMode 멀티플레이에서는 같은 코드가 서버와 여러 클라이언트에서 실행될 수 있다. 따라서 디버깅할 때는 현재 코드가 어느 환경에서 실행되는지 확인해야 한다. 이를 구분하는 것이 NetMode 다. 모드 의미 Standalone 외부 연결 없이 로컬에서 실행 Client 서버에 접속한 플레이어 Listen Server 플레이어가 참여하면서 서버 역할도 수행 Dedicated Server 플레이어 없이 서버 역할만 수행 리슨 서버와 데디케이티드 서버는 서버 쪽에 직접 플레이하는 사람이 있는지 로 구분했다. 2. Ownership과 Owning Connection 액터는 Owner 를 통해 소유 관계를 가질 수 있다. PlayerController → Character → Weapon 캐릭터의 Owner가 PlayerController이고, 무기의 Owner가 캐릭터라면 이 관계를 따라 플레이어의 연결을 확인할 수 있다. Owner : 액터의 소유 관계 Owning Connection : 소유 관계를 통해 연결되는 플레이어의 네트워크 연결 이 관계는 이후 배울 RPC와 Property Replication 에도 영향을 준다. 3. 객체가 존재하는 위치 모든 객체가 서버와 클라이언트에 똑같이 존재하는 것은 아니다. 객체 존재하는 위치 GameMode 서버 GameState / PlayerState 서버와 클라이언트에 복제 PlayerController 서버와 해당 플레이어의 클라이언트 복제되는 캐릭터 서버와 관련 클라이언트 UI 로컬 플레이어 쪽 액터의 복제 설정과 네트워크 관련성에 따라 클라이언트에 존재하는 객체는 달라질 수 있다. 또한 애니메이션 블루프린트는 서버에도 존재할 수 있으므로 , 클라이언트 전용으로 생각하지 않도록 주의해야겠다. 4. 클라이언트에서 GameMode에 접근하기 접속한 클라이언트에는 GameMode가 없으므로 GetGameMode() 를 호출하면 nullptr 이 반환된다. GameMode를 사용하는 작업은 서버에서 처리해야 한다. 클라이언트 요청 → Server RPC → 서버에서 GameMode 사용 여기서 Server RPC는 적절한 소유 관계를 가진 액터를 통해 호출해야 한다. 또한 두 개념을 구분해서 기억해야 한다. NetMode : 월드의 네트워크 실행 모드 HasAuthority() : 해당 액터의 권한 여부 💡 오늘 배운 점 멀티플레이에서는 코드의 내용뿐 아니라 어디에서 실행되는지, 해당 객체가 그곳에 존재하는지 도 중요하다. 앞으로 코드를 볼 때는 다음 세 가지를 먼저 확인해야겠다. 서버와 클라이언트 중 어디에서 실행되는가? 접근하려는 객체가 그곳에 존재하는가? 액터의 소유 관계와 권한은 어떻게 되는가? 다음에는 Ownership이 RPC와 복제에 어떻게 연결되는지 실행 흐름을 따라가며 정리하고 싶다.
13 · 접근 불가 페이지 만들기 💡 한 줄 요약 : 사용자의 권한으로 접근을 제어하고, 권한이 부족하면 접근 불가 응답·화면을 제공합니다. 권한 정보 구성 public enum UserRoleEnum { USER("ROLE_USER"), ADMIN("ROLE_ADMIN"); private final String authority; UserRoleEnum(String authority) { this.authority = authority; } public String getAuthority() { return authority; } } @Override public Collection<? extends GrantedAuthority> getAuthorities() { return List.of(new SimpleGrantedAuthority(user.getRole().getAuthority())); } 회원의 실제 역할에서 권한을 만듭니다. 모든 사용자를 고정된 관리자 권한으로 만드는 코드를 사용하지 않습니다. Role과 Authority 표현 확인하는 권한 hasRole("ADMIN") 기본 규칙에서 ROLE_ADMIN hasAuthority("ROLE_ADMIN") 정확히 ROLE_ADMIN @Secured("ROLE_ADMIN") 지정한 권한 문자열 모든 Authority가 반드시 ROLE_ 로 시작하는 것은 아닙니다. ROLE_ 는 역할 기반 표현에서 사용하는 기본 접두어 규칙입니다. @Secured 적용 @Configuration @EnableWebSecurity @EnableMethodSecurity(securedEnabled = true) public class WebSecurityConfig { // SecurityFilterChain 등의 설정 } @Secured("ROLE_ADMIN") @GetMapping("/api/products/secured") public String getProductsByAdmin( @AuthenticationPrincipal UserDetailsImpl userDetails) { return "redirect:/"; } @Secured 를 선언하는 것과 해당 메서드 보안을 활성화하는 설정을 함께 적용합니다. 접근 불가 화면 연결 http.exceptionHandling(exceptions -> exceptions .accessDeniedPage("/forbidden.html") ); 접근 불가 화면 자체가 다시 차단되지 않도록 정적 화면의 접근 정책도 확인합니다. 인증 실패와 인가 실패 상황 중심 문제 API 응답의 일반적인 표현 인증 정보 없음·잘못된 토큰 사용자 인증 실패 401 Unauthorized 인증되었지만 필요한 권한 없음 접근 권한 부족 403 Forbidden 브라우저 로그인 방식에서는 로그인 화면 이동 등으로 응답할 수도 있습니다. 화면 서비스의 이동 처리와 JSON API의 상태 코드 응답을 구분합니다. 복습 체크 일반 사용자와 관리자 권한을 동적으로 설정할 수 있습니다. @Secured 와 @EnableMethodSecurity 를 함께 적용할 수 있습니다. 401과 403이 나타내는 상황을 구분할 수 있습니다. 접근 불가 화면을 제공하되 실제 API 권한 검사도 적용합니다.
261002 블로그1 블로그2 논문 [논문] Performance Evaluation of MLO for XR Streaming 와이파이 7(Wi-Fi 7)에 도입된 MLO (다중 링크 운영) VR/XR 통신, 실시간 스트리밍, 대용량 전송이 필요한 환경에 한해 유용한 듯 장애물이 없는 한정된 공간에서 시행되어야 하는 제약이 있을 듯 싶다
지구에서의 음악과 같은 개념인 막화장실에서의 음막은 굉장히 방대한 부류가 있습니다. 요즘 유행하는 음막 종류는 반복 랩 음막 입니다. 말 그대로 가사를 반복하는 음막이죠. 대부분의 음막들은 막어를 사용하지만, 요즘엔 지구의 문화가 막화장실에 퍼져서 지구의 노래들이(특히 K-pop)편곡 되거나 리메이크 되어서 음막이 되는 경우도 있습니다. 몇몇 노래들은 영어, 한국어, 일본어 등을 사용하기도 하며, 10월 2일 65시(한국 기준 6시 51분) 기준으로 음막의 가장 기본이 되는 사이트인 음막 사이트의 막화장실 전체 차트는 다음과 같습니다.(노래 제목 옆 괄호 안 숫자는 어제 재생수 대비 변화) 1위: 음마-Segal so bad(+194억) 대표 가사: 세갈 소 배드 배드 배드 배드 2위: 가방쌤-가방이가방에들어간다(-67억) 대표 가사: 가방이 가방에 들어간다 3위: 마담-히히(+982억) 대표 가사: 히히 아우 히 히 아우! 4위: 음마-Lemonade(-198만) 대표 가사: I’ll make it LEMONADE 5위: ABC발디-실내화(-2015억) 대표 가사: 실내화가 왜 학교에 있어 6위: 음마-프리티막(+9183만) 대표 가사: 어디서나 당당치킨 먹기 7위: 가방쌤, ABC발디-실내화가방에들어간다(+208억) 대표 가사: 실내화가 가방에 들어간다 8위: 아바마마-엄청난 폭발력(+12억) 대표 가사: 오 엄청난 폭발력인데! 9위: 전신-봤어(-194만) 대표 가사: 나 나 나 나 오늘 봤어...! 10위: 가방쌤-그리고(-1037억) 대표 가사: 그리고!! 잘들어! 11위: 아바마마-멸바오(+36억) 대표 가사: 멸치도 우주에 갈 수 있는 시대라고! 12위: 포도포도막창단-고소미(+6만) 대표 가사: 고소미 고소미 고소미 13위: 음마-오하윤(-6억) 대표 가사: 오하윤 트름 했어 14위: 마담-아담아담(+310만) 대표 가사: 아담이 아담해 아담 아담 아담이 아담해 15위: 마담-최초의 아담(-13만) 대표 가사: 이히- 아우!! 히히- 막!! 음막가들 소개 음마: 현재 최고의 인기 음막가이다. 최근 지구 노래들을 리메이크 하며 막화장실 차트에서 큰 비중을 차지하는 인기 음막가이다. 특히 그의 대표곡인 는 음막 차트에서 3주간 1위를 차지하기도 한 인기곡이다. 가방쌤: 반복적인 가사의 랩 위주로 음막을 만든다. <가방이가방에들어간다>는 한동안 막화장실 내 최대 규모의 플랫폼인 막비디오s에서 조회수 2조 3914만회 라는 대기록을 세우기도 하였다. ABC발디: 꾸준히 활동해오던 음막가로, 대표적인 음막은 <실내화>, <사계>가 있다. 옛날 만큼 큰 인기를 받진 않지만 여전히 꾸준하게 차트에 이름을 올린다. 최근엔 가방쌤과 함께 음막을 만들기도 했다. 마담: 사실상 음막의 창시자이다. 그의 대표 음막인 <최초의 아담>은 음막 차트 15위 내에 12년 동안 유지 되어있다. 최근에 <히히> 같은 음막을 내긴 했지만, 너무 우려 먹는다는 반응이 많아서 최근엔 옛날에 비해 시들하다. 아바마마: <엄청난 폭발력>으로 최근에 데뷔하였다. 앞으로의 성장이 기대되는 음막가이다. 전신: 최근에 데뷔한 음막가이다. 아직 음막을 <봤어> 한 곡 밖에 쓰지 못했지만 그 영상이 막비디오s에서 조회수 1조 408만회를 달성하며 인기를 끌었다.
PostgreSQL 성능 튜닝 - PGTune으로 설정값 점검하기 PostgreSQL을 운영하면서 DB 성능과 관련된 설정값을 확인할 일이 있었다. 처음에는 PostgreSQL의 설정값을 하나씩 찾아보면서 적절한 값을 직접 설정해야 하나 싶었는데, 서버의 CPU나 메모리, 저장장치 등의 환경에 따라 적절한 설정값이 달라질 수 있다는 것을 알게 되었다. 그러던 중 PostgreSQL 서버 환경을 입력하면 적절한 설정값을 제안해주는 PGTune 이라는 도구를 알게 되었다. 이번 글에서는 PGTune을 사용하기 전에 왜 PostgreSQL 설정값을 튜닝해야 하는지 , 그리고 PGTune에 입력하는 값들이 어떤 의미를 가지고 있는지 정리해보려고 한다. 1. PostgreSQL 튜닝이 필요한 이유 PostgreSQL에는 데이터베이스의 동작 방식을 조절할 수 있는 다양한 설정값이 존재한다. 예를 들어 다음과 같은 설정들이 있다. shared_buffers work_mem maintenance_work_mem effective_cache_size max_connections random_page_cost effective_io_concurrency 이러한 값들은 메모리 사용량이나 쿼리 처리, 디스크 I/O, 데이터베이스 연결 수 등에 영향을 준다. 문제는 모든 서버에 동일한 설정값을 적용할 수 없다는 것 이다. 예를 들어 RAM이 8GB인 서버와 64GB인 서버에서 PostgreSQL을 운영한다면 동일한 메모리 관련 설정값을 사용하는 것이 적절하지 않을 수 있다. CPU의 수나 저장장치의 종류 역시 서버마다 다르다. 따라서 PostgreSQL을 운영하는 서버의 환경을 확인하고 그에 맞게 설정값을 조정할 필요가 있다. 2. PGTune이란? PGTune 은 PostgreSQL이 실행되는 서버의 환경과 데이터베이스 사용 목적 등을 입력하면 PostgreSQL의 설정값을 제안해주는 도구다. 서버의 하드웨어 환경뿐만 아니라 데이터베이스의 용도와 연결 수 등을 함께 입력할 수 있기 때문에 PostgreSQL 설정을 처음 점검할 때 참고하기 좋다. 다만 PGTune에서 생성한 값을 그대로 적용하면 무조건 성능이 좋아지는 것은 아니다. 실제 데이터베이스에서는 쿼리의 특성이나 데이터의 크기, 동시 접속 수, 인덱스 구성 등 다양한 요소가 성능에 영향을 주기 때문이다. 그래서 이번에는 PGTune을 최적의 값을 자동으로 찾아주는 도구라기보다는 현재 설정을 점검하고 튜닝 방향을 잡기 위한 참고 도구 로 사용했다. 3. PGTune에 어떤 정보를 입력할까? PGTune에서는 PostgreSQL 서버 환경을 입력해야 한다. 내가 사용한 환경은 다음과 같았다. 항목 입력값 DB Version PostgreSQL 11 OS Type Windows DB Type Desktop Application Total Memory 서버의 실제 RAM Number of CPUs 서버의 논리 프로세서 수 Number of Connections 1000 Data Storage SSD Total Data Size 실제 DB 크기에 맞게 선택 각 항목이 왜 필요한지 하나씩 확인해보았다. 4. DB Version DB Version 현재 사용하고 있는 PostgreSQL의 버전을 입력한다. PostgreSQL 버전에 따라 사용할 수 있는 기능이나 기본 설정 등이 달라질 수 있기 때문에 현재 사용 중인 버전을 기준으로 입력해야 한다. 현재 PostgreSQL 버전은 다음과 같이 확인할 수 있다. SELECT version(); 내가 사용하고 있던 PostgreSQL은 11 버전 이었다. 5. OS Type OS Type PostgreSQL이 설치되어 실행되고 있는 운영체제를 선택한다. 내 환경은 Windows 였기 때문에 Windows를 선택했다. 여기서 중요한 것은 PostgreSQL에 접속하는 클라이언트의 운영체제가 아니라 PostgreSQL 서버가 실행되는 운영체제 를 기준으로 해야 한다는 것이다. 예를 들어 Windows PC에서 Linux 서버의 PostgreSQL에 접속하고 있다면 Linux를 선택해야 한다. 6. DB Type DB Type PostgreSQL을 어떤 용도로 사용하는지 선택하는 항목이다. PGTune에서는 데이터베이스의 사용 형태에 따라 여러 유형을 제공한다. Web Application Online Transaction Processing (OLTP) Data Warehouse (DW) Desktop Application Mixed Type of Applications 내가 사용하던 환경에서는 Desktop Application 을 선택했다. 단순히 애플리케이션이 웹 기반인지 아닌지만 보고 선택하기보다는 실제 데이터베이스가 어떤 방식으로 사용되고 있는지를 기준으로 선택하는 것이 좋다. 7. Total Memory Total Memory (RAM) PostgreSQL 서버가 사용하는 전체 RAM 용량 을 입력한다. 메모리는 PostgreSQL의 여러 설정값과 직접적으로 관련되어 있다. 예를 들어 shared_buffers 는 PostgreSQL이 데이터 페이지를 캐싱하는 데 사용하는 메모리와 관련된 설정이고, work_mem 역시 쿼리 처리 과정에서 사용되는 메모리와 관련이 있다. 따라서 서버의 메모리 크기를 모른 상태에서 적절한 값을 설정하기는 어렵다. Windows에서는 다음과 같이 확인할 수 있다. 작업 관리자 → 성능 → 메모리 여기에서 실제 PostgreSQL 서버의 RAM을 확인해서 입력하면 된다. 8. Number of CPUs Number of CPUs 처음 PGTune을 사용할 때 조금 헷갈렸던 항목이다. 여기서 단순히 물리적인 CPU 코어 수를 입력하는 것은 아니다. 운영체제에서 인식하는 논리적인 CPU 실행 단위를 기준으로 생각할 수 있다. Windows에서는 작업 관리자의 CPU 정보에서 다음과 같은 항목을 확인할 수 있다. 코어 논리 프로세서 예를 들어 다음과 같은 CPU라면, 코어: 4 논리 프로세서: 8 PGTune의 Number of CPUs 에는 일반적으로 8 을 입력한다. 왜 CPU 개수가 필요할까? PostgreSQL은 쿼리를 처리하면서 CPU를 사용한다. 따라서 서버가 사용할 수 있는 CPU 자원이 얼마나 되는지를 알아야 CPU와 관련된 작업이나 메모리, 병렬 처리 등에 영향을 주는 설정값을 서버 환경에 맞춰 제안할 수 있다. 특히 하나의 물리 코어가 여러 개의 논리 프로세서로 인식되는 환경에서는 물리 코어 수와 운영체제가 인식하는 CPU 실행 단위의 수가 다를 수 있다. 예를 들어, 물리 코어 4개 ↓ 하이퍼스레딩 적용 ↓ 논리 프로세서 8개 와 같은 환경이라면 운영체제에서는 8개의 논리 프로세서를 사용할 수 있는 것으로 인식한다. 그래서 PGTune의 CPU 입력값을 확인할 때는 단순히 "코어가 몇 개인가?"만 확인하는 것이 아니라 운영체제에서 CPU가 어떻게 인식되고 있는지도 확인할 필요가 있다. Windows에서는 작업 관리자 → 성능 → CPU → 논리 프로세서 에서 확인할 수 있다. 9. Number of Connections Number of Connections PostgreSQL에 허용할 최대 연결 수를 입력한다. PostgreSQL에서는 max_connections 설정으로 최대 연결 수를 지정한다. 현재 설정값은 다음과 같이 확인할 수 있다. SHOW max_connections; 내가 사용하던 환경에서는 최대 연결 수가 1000 으로 설정되어 있었다. max_connections = 1000 여기서 주의할 점은 최대 연결 수와 현재 연결되어 있는 세션 수는 다르다는 것 이다. max_connections 는 PostgreSQL이 허용할 수 있는 최대 연결 수를 의미한다. 연결 수가 많아지면 PostgreSQL이 사용할 수 있는 메모리에도 영향을 줄 수 있기 때문에 서버 환경과 애플리케이션의 실제 연결 구조를 함께 확인해야 한다. 10. Data Storage Data Storage PostgreSQL의 데이터가 저장되는 저장장치의 종류를 선택한다. 대표적으로 SSD나 HDD 등을 선택할 수 있다. 내가 사용하던 서버의 데이터 저장장치는 SSD 였기 때문에 SSD를 선택했다. 저장장치의 속도는 PostgreSQL의 디스크 I/O 성능과 관련이 있기 때문에 이 정보 역시 설정값을 계산할 때 고려할 필요가 있다. 11. Total Data Size Total Data Size PostgreSQL에서 사용하는 데이터의 크기를 서버의 RAM과 비교해서 선택하는 항목이다. 예를 들어 서버의 RAM이 16GB이고 데이터베이스의 전체 크기가 수백 GB라면 데이터베이스의 크기가 RAM보다 큰 환경이라고 볼 수 있다. 반대로 데이터베이스가 RAM보다 훨씬 작은 환경이라면 다른 조건을 선택하게 된다. 이처럼 데이터베이스의 크기와 서버 메모리의 관계 역시 PostgreSQL의 캐시 및 I/O 관련 설정을 결정할 때 고려할 수 있는 요소다. 12. PGTune 결과 확인 모든 정보를 입력하면 PGTune에서 PostgreSQL 설정값을 생성할 수 있다. 결과에는 다음과 같은 설정값들이 포함된다. max_connections = ... shared_buffers = ... effective_cache_size = ... maintenance_work_mem = ... checkpoint_completion_target = ... wal_buffers = ... default_statistics_target = ... random_page_cost = ... effective_io_concurrency = ... work_mem = ... 여기서 바로 설정 파일을 수정하지 않고 현재 PostgreSQL의 설정값과 먼저 비교 해보았다. 13. 현재 PostgreSQL 설정 확인하기 PostgreSQL의 설정값은 SHOW 명령어를 이용해서 확인할 수 있다. SHOW shared_buffers; SHOW effective_cache_size; SHOW maintenance_work_mem; SHOW work_mem; SHOW max_connections; 여러 설정을 한 번에 확인하고 싶다면 pg_settings 를 사용할 수도 있다. SELECT name, setting, unit FROM pg_settings WHERE name IN ( 'max_connections', 'shared_buffers', 'effective_cache_size', 'maintenance_work_mem', 'work_mem', 'random_page_cost', 'effective_io_concurrency' ) ORDER BY name; 이렇게 확인한 현재 설정값과 PGTune에서 제안한 값을 비교한다. 현재 PostgreSQL 설정 ↓ PGTune 추천값 확인 ↓ 차이가 있는 설정 확인 ↓ 각 설정이 어떤 영향을 주는지 확인 ↓ 실제 환경에 적용할지 판단 14. PGTune의 값을 그대로 적용하면 될까? 여기서 가장 중요한 부분이다. PGTune에서 생성된 값을 그대로 적용한다고 해서 무조건 성능이 좋아지는 것은 아니다. 예를 들어 work_mem 의 경우 값을 크게 설정하면 하나의 작업에서 사용할 수 있는 메모리가 증가할 수 있지만, 여러 쿼리가 동시에 실행되면 전체 메모리 사용량이 증가할 수 있다. max_connections 역시 마찬가지다. 내 환경에서는 최대 연결 수가 1000 으로 설정되어 있었는데, 단순히 연결 수를 크게 설정하는 것이 항상 좋은 것은 아니다. 실제로는 애플리케이션의 연결 방식과 동시 접속 상황 등을 함께 확인해야 한다. 따라서 PGTune의 결과를 보고 "추천값이 나왔으니 그대로 적용한다." 보다는 "현재 설정과 어떤 차이가 있는지 확인하고, 왜 이런 값이 추천되었는지 이해한 후 적용한다." 는 방식으로 접근하는 것이 좋다고 생각한다. 마무리 이번에는 실제 운영 중인 PostgreSQL 환경을 기준으로 PGTune을 사용해 설정값을 점검해보았다. 내 환경은 다음과 같았다. Windows Desktop Application SSD max_connections = 1000 PGTune을 사용하면서 PostgreSQL의 설정값은 단순히 임의의 숫자를 지정하는 것이 아니라 CPU, 메모리, 저장장치, 데이터베이스 크기, 연결 수와 같은 서버 환경을 함께 고려해서 설정해야 한다는 것 을 알 수 있었다. 특히 PGTune은 설정값을 자동으로 최적화해주는 도구라기보다는, 현재 환경에서 어떤 설정을 확인하고 조정해볼 수 있는지 방향을 잡는 데 유용한 도구라고 생각한다. 다음에는 PGTune에서 생성된 설정값 중 실제로 많이 사용되는 shared_buffers , work_mem , effective_cache_size 등이 각각 어떤 역할을 하는지 조금 더 자세히 정리해볼 예정이다.
S.O.L.I.D 기초개념 1) SOLID란 유연성(새로운 기능 쉽게 추가), 유지보수성, 재사용성 끊임없이 변화하는 소프트웨어에 유연하게 대처 결합도 낮추고 응집도 높이기 2) 결합도와 응집도 결합도: 모듈과 모듈간의 의존 정도 <-> 클래스 간의 자유로운 교체 결합도 낮게! 응집도: 한 모듈내 구성요소의 연관정도 - 클래스 내부가 하나의 목적에 집중 응집도 높게! //안 좋은 코드 class Player { Sword s = new Sword(); Gun g = new Gun(); void attack() { s.slash(); g.shoot(); } } : Player라는 하나의 클래스에서 무기를 생성하고 관리 -> 검과 총을 모두 들음 -> 여러 책임 혼합되어 응집도가 낮음. 또한 새로운 무기 추가와 교체가 어려움 -> 결합도 높음 //좋은 코드 interface Weapon { void use(); } class Sword implements Weapon { public void use() { System.out.println("칼로 베었다!"); } } class Gun implements Weapon { public void use() { System.out.println("총을 발사했다!"); } } class Player { Weapon w; public Player(Weapon w) { // TODO Auto-generated constructor stub this.w=w; } public void attack() { w.use(); //총이든 검이든 상관없이 공격가능 } } : 무기를 직접 생성하는 대신 주입받음! Player는 attack()이라는 책임 하나에 집중 -> 응집도 높아짐 무기 종류가 바뀌더라도 Player 코드는 영향이 없음 -> 결합도 낮아짐 총과 검을 Weapon이라는 인터페이스를 구현시켜 따로 클래스를 만듦으로써 사용자가 무기를 무얼 선택하든 바로 w.use만 쓰면 공격할 수 있게 됨. 이런 코드는 나중에 무기가 추가되었을 때도 따로 함수를 사용할 필요 없이 동일하게 Weapon을 구현시킨 클래스를 만들면 되기 때문에 w.use를 통해 간단하게 공격할 수 있음. 3) SOLID의 필요성 이미 존재하는 레거시 코드를 좋은 코드로 만드는 기술이자 원칙임: 기존 코드를 어떻게 개선할까에 대한 방향 제시 기술적 부채를 막는 실용적 방법: 빠른 개발속도 < 처음부터 차근차근 유지보수와 확장이 쉽게! 변화에 강하고 유연한 코드로 전환하는 힘 4) SOLID의 활용 리펙토링 스프링 프레임워크의 핵심: IoC/DI cf. IoC(제어의 역전)과 DI(의존성 주입)은 DIP(의존성 역전 원칙)와 OCP(개방-폐쇄 원칙)를 가장 잘 구현한 대표적 예시 유연한 아키텍처 설계 ex) MSA SOLID 원칙 1) S: 단일 책임의 원칙 클래스는 단 하나의 책임에만 집중 //before class ReportService { public void generateReport() {//보고서작성} public void sendEmail() {//이메일전송} } //after class ReportGenerator{ public void generateREport(){//보고서작성} } class EmailSender { public void sendEmail() {//이메일 작성} } : 하나의 클래스에 있던 함수들을 두개의 클래스로 분리 -> 유지 보수가 용이해짐 **2) O: 개방-폐쇄의 원칙** - 확장에 개방, 수정에 폐쇄 - 기존 코드를 변경하지 않고도 새로운 기능을 추가할 수 있어야 함 - 추상화에 의존O, 구체적 클래스에 의존X 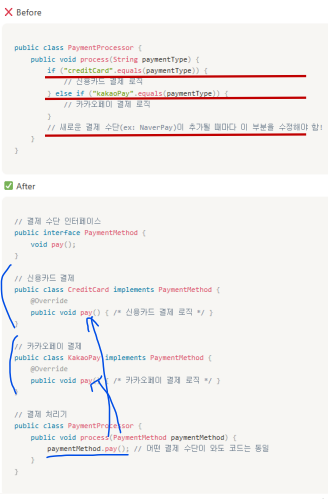 : 결제방식을 추가할 때마다 PaymentProcesssor라는 기존의 클래스를 수정할 필요 없이, 결제방식이라는 추상 인터페이스를 구현한 새로운 결제방식 클래스를 만들 수 있다 **3) L: 리스코프 치환의 원칙** - 하위 타입은 언제나 상위 타입으로 대체될 수 있어야 한다 - 자식 클래스는 부모 클래스가 사용되는 곳에 문제없이 들어갈 수 있어야 함 (IS-A관계) 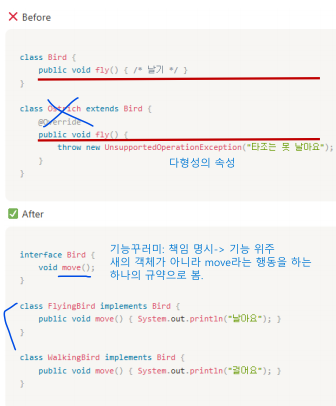 : 타조클래스가 새 클래스를 상속했을 때, 타조는 새의 특성인 fly를 하지 못한다는 문제점 발생.(자식 클래스가 부모 클래스에서 사용하지 못하는 부분이 생김!) -> 새를 Flyling Bird와 Walking Bird로 분리하여 자식클래스가 부모 클래수의 규약을 모두 지킬 수 있도록(IS-A 관계 명확히 따르도록) 수정. **4) I: 인터페이스 분리의 원칙** - 자신이 사용하지 않는 메소드에 의존해서는 안됨(책임 위주로 보기) - 하나의 거대한 인터페이스 < 여러 개의 구체적인 인터페이스 -> 인터페이스를 기능별로 분리! - 인터페이스 변경 시 영향받는 클래스 최소화(인터페이스의 기능 최소화) 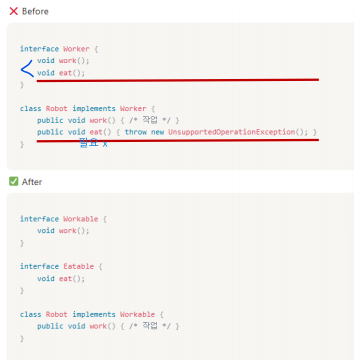 : 로봇은 eat()을 구현할 필요가 없으므로, 원래 하나의 인터페이스로 합쳐져있던 work()와 eat() 메소드를 각각의 인터페이스로 분리 **5) D: 의존성 역전의 원칙(DIP)** - 상위 모듈은 하위모듈에 의존해서는 안됨. 둘 다 추상화에 의존해야함! (하위모듈은 변하기 쉽기 때문에, 변하기 어렵고 빈도 낮은 인터페이스나 추상클래스에 의존하라는 의미) 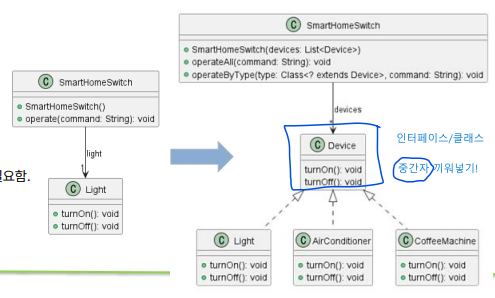 : 상위 모듈은 추상화계층의 계약만 알면 되고, 하위모듈은 그 계약을 충족하는 방식으로 구현하기만 하면 됨. 새로운 구현체(AirConditioner, CoffeeMachine)이 추가되더라도 상위모듈(SmartHomeSwitch)는 수정할 필요가 없음 ### 제어의 역전(IoC)와 의존성 주입(DI) **1) 제어의 역전(IoC)** - 프레임워크(전문가): 추상화에 의존할 때 구체적인 구현체를 넣어줌 -> 프레임워크를 통해 제어방법을 역전시키고 모든것을 관리함 - 구현방법: 의존성(DI)을 주입 **2) 의존성 주입(DI)** - DI: IoC를 구현하는 대표적 기술 - 클래스 내부에서 new를 통해 의존 객체를 직접 생성하는 것이 아니라, 외부(프레임워크)에서 의존 객체를 '주입'받는 방식 - 구현방법 - 생성자주입: 의존성 불변, 필수 의존성 명확, 테스트 용이 - Setter 주입 - 필드 주입
들어가며 요즘 AI 모델에 도구 실행이나 작업 위임 같은 기능을 붙여 주는 하네스에 관심이 생겨 여러 도구를 살펴보고 있다. 그런데 OpenCode는 쓰지 않고 있었다. 내가 쓰는 Claude 구독제를 OpenCode에 연결할 수 없었기 때문이다. 그러다 OpenCode 설치 없이 실행할 수 있고, 공식 문서에 Claude 구독 로그인도 지원한다고 적힌 OmO를 알게 됐다. 설치한 뒤에는 두 가지가 헷갈렸다. 평소에는 어떻게 사용하는지 , 그리고 여러 모델을 쓴다는 말이 요청마다 메인 모델을 자동으로 바꾼다는 뜻인지 였다. 공식 GitHub 문서를 읽어 보니 사용법은 작업 규모에 따라 나뉘고, 모델은 메인 에이전트·보조 에이전트·작업 카테고리마다 따로 배정된다. 이 글은 OmO의 설치와 사용법, 모델 배정과 변경 방법을 정리한 기록이다. 확인한 설치 버전은 OmO 5.1.9다. OmO는 무엇인가? OmO는 터미널에서 omo 명령으로 실행하는 독립형 AI 에이전트다. OpenCode 안에 설치하는 OmO 플러그인과 달리 OpenCode를 먼저 실행할 필요가 없고, 내부적으로는 senpi 엔진과 OmO 기능을 함께 사용한다. ( README ) 작업의 중심에는 메인 에이전트 가 있다. 메인 에이전트는 사용자와 대화하며 작업을 진행하고, 필요하면 코드 검색이나 구현의 일부를 다른 에이전트에게 맡긴다. 위임받은 에이전트는 메인과 다른 모델을 사용할 수 있다. 설치와 첫 실행 공식 설치 페이지에서 안내하는 macOS·Linux 설치 명령은 다음과 같다. ( 설치 안내 ) curl -fsSL https://get.omo.dev/install.sh | bash Bun을 사용한다면 패키지로도 설치할 수 있다. 패키지 이름은 omo-ai 이며, 이름이 비슷한 omo 는 다른 패키지이니 주의하자. bun add -g omo-ai 설치 여부와 버전은 omo --version 으로 확인한다. 그다음 작업할 프로젝트 폴더에서 omo 를 실행하고 원하는 작업을 말하면 된다. cd 내-프로젝트 omo 기존에 OpenCode용 OmO를 썼다면 omo setup 으로 API 키, MCP 서버, 스킬, 모델 선택 등을 가져올 수 있다. ( 이전 가이드 ) 공식 GitHub가 안내하는 사용법 처음부터 에이전트 이름이나 카테고리를 지정할 필요는 없다. 공식 가이드는 작업의 규모와 계획이 필요한지에 따라 사용법을 나눈다. ( 오케스트레이션 가이드 ) 상황 사용 방법 예시 오타나 한 파일의 간단한 수정 평소처럼 요청 버튼 글자를 '저장하기'에서 '저장'으로 바꿔줘 범위가 넓고 알아서 조사·구현·검증하길 원함 요청에 ulw 또는 ultrawork 추가 로그인 오류의 원인을 찾아 수정해줘. ulw 구현 전에 문서로 된 계획을 검토하고 싶음 /ulw-plan 으로 계획을 만든 뒤 /ulw-execute /ulw-plan 결제 흐름을 개선해줘 간단한 수정은 그냥 요청하면 된다. 공식 가이드는 이런 작업을 메인 에이전트가 직접 처리하는 흐름으로 설명한다. 복잡한 작업에 ulw 를 붙이면 메인 에이전트가 코드베이스를 조사하고, 작업을 나누어 위임한 뒤 결과를 검증한다. /ulw-plan 은 먼저 계획을 검토하고 싶을 때 쓴다. 계획 모드에서는 바로 구현하지 않고, 요청을 조사하고 필요한 결정을 확인한 뒤 계획을 작성한다. 실행은 별도의 /ulw-execute 로 시작한다. 그래서 수정 전에 범위를 문서로 확인하고 싶다면 ulw 보다 이 흐름이 맞다. 메인 모델은 작업마다 자동으로 바뀔까? 내 환경에는 메인 기본 모델로 GPT-6 Sol 이 저장돼 있었다. 따로 고른 기억이 없어서 처음에는 간단한 작업이면 GPT-6 Luna Fast 같은 가벼운 모델로 알아서 바뀌는 줄 알았다. 하지만 메인 에이전트는 현재 세션에서 선택된 모델로 작업한다. 대화 중 /model 로 모델을 바꿀 수는 있지만, 요청이 간단하다는 이유만으로 메인 모델이 바뀌지는 않는다. 다른 에이전트에게 일을 맡길 때만 그 역할에 설정된 모델 목록이 따로 적용된다. ( 모델 배정 가이드 ) 모델 배정은 다음 세 층으로 생각하면 이해하기 쉽다. 구분 언제 쓰나? 모델 설정 메인 모델 나와 대화하며 작업을 이끄는 세션 현재 세션의 모델 보조 에이전트 모델 코드 검색이나 계획 검토를 위임할 때 각 에이전트의 모델 목록 카테고리 모델 구현·문서 작성 등의 작업을 위임할 때 각 카테고리의 모델 목록 공식 문서에 나온 네 보조 에이전트 공식 문서에는 역할이 정해진 네 보조 에이전트가 나온다. 이들은 순서대로 실행되는 단계가 아니라, 메인 에이전트가 필요할 때 호출하는 읽기 전용 역할이다. 보조 에이전트 하는 일 기본 모델의 첫 후보 explore 프로젝트 코드 검색, 파일과 패턴 찾기 Kimi 고속 모델 librarian 공식 문서와 외부 오픈소스 코드 조사 Kimi 고속 모델 plan-consultant 계획을 쓰기 전 빠진 요구사항과 모호한 점 찾기 Claude Fable 5.1 plan-reviewer 작성한 계획의 명확성과 검증 가능성 검토 GPT-6 Astra 각 에이전트에는 대체 모델 목록도 있어서, 첫 후보를 쓸 수 없으면 다음 후보를 시도한다. 예를 들어 explore 와 librarian 은 Kimi 고속 모델 다음에 GPT-6 Luna Fast를 시도한다. plan-consultant 와 plan-reviewer 는 /ulw-plan 의 계획 흐름에서 쓰인다. 일반적인 수정 요청이나 ulw 요청마다 호출되는 것은 아니다. 구현 작업을 맡는 카테고리 카테고리( category )는 작업을 위임할 때 작업자의 역할과 모델을 정하는 분류다. 앞의 보조 에이전트가 조사와 검토를 맡는다면, 카테고리 작업자는 구현·테스트·문서 작성 같은 일을 맡는다. 단, architect 는 구조를 제안하는 역할이다. 카테고리 주로 맡는 일 기본 모델의 첫 후보 quick 간단한 수정, 오타 수정 GPT-6 Luna Fast deep-low 백엔드·알고리즘 등 깊은 구현 작업 GPT-6.1 Sol deep-high 핵심 결정을 더 깊이 검토해야 하는 작업 GPT-6 Astra ultrabrain 어려운 논리 중심 문제 GPT-6 Astra visual-engineering 프런트엔드, UI·UX, CSS Claude Fable 5.1 artistry 창의적인 문제 해결 Claude Fable 5.1 writing 문서와 기술 글 작성 Claude Opus 5.5 architect 큰 구조 설계 제안 Claude Fable 5.1 unspecified-low 다른 분류에 맞지 않는 가벼운 작업 Claude Sonnet 5.5 unspecified-high 다른 분류에 맞지 않는 무거운 작업 Claude Opus 5.5 표는 작성 시점의 GitHub dev 모델 배정 가이드 에 적힌 첫 후보를 요약한 것이다. 실제 모델은 연결한 계정에 따라 달라진다. 예를 들어 Claude를 연결하지 않았다면 Claude 모델이 첫 후보인 카테고리는 대체 후보로 넘어가고, 쓸 수 있는 후보가 없으면 선택지에서 빠질 수도 있다. quick 이 있다고 해서 "버튼 글자 하나 바꿔줘" 같은 요청이 항상 Luna로 넘어가는 것은 아니다. 메인 모델이 Sol이고 메인이 직접 수정했다면 Sol이 그 일을 한 것이다. 메인이 작업을 quick 으로 위임했을 때만 quick 의 모델이 적용된다. 보조 에이전트와 카테고리의 모델을 바꾸는 방법 기본 배정이 마음에 든다면 바꿀 필요는 없다. 바꾸고 싶다면 ~/.omo/omo.jsonc 에서 네 보조 에이전트는 agents , 작업 카테고리는 categories 에 지정한다. 아래는 형식을 보여주는 예시다. { "agents": { // 코드 검색은 빠른 모델로 "explore": { "model": "chatgpt-subscription/gpt-6-luna-fast", "reasoning": "low" }, // 계획 검토는 깊게 생각하는 모델로 "plan-reviewer": { "model": "chatgpt-subscription/gpt-6-astra", "reasoning": "xhigh" } }, "categories": { "quick": { "model": "chatgpt-subscription/gpt-6-luna-fast", "reasoning": "low" } } } 이 예시는 각 역할을 대체 후보 목록 없이 특정 모델 하나로 고정하는 형식을 보여준다. 모델 ID는 로그인한 계정에서 실제로 쓸 수 있는 값이어야 하니 /model 목록에서 확인하고 적자. 모든 역할을 적을 필요는 없다. explore 만 적으면 나머지 역할은 기존 설정을 유지한다. 우선순위가 있는 목록을 만들고 싶다면 model 대신 models 배열을 쓰면 된다. ( 설정 문서 ) 이 설정은 위임받은 작업의 모델만 바꾼다. 메인 에이전트의 모델은 /model 에서 고른다. 연결한 계정으로 어떤 카테고리를 쓸 수 있는지는 omo doctor 로 확인할 수 있다. 모델을 나눠 쓰면 토큰도 항상 절약될까? 내 생각에는 반드시 그렇지는 않다. 작업을 위임하면 메인 에이전트가 일을 전달하고 결과를 확인하는 과정이 추가된다. 여러 에이전트가 조사하고 검토하면 전체 토큰 사용량이 오히려 늘어날 수도 있다. 절약 여부는 작업 규모와 실제로 호출된 에이전트에 따라 달라진다고 보는 편이 맞다. 마치며 처음 OmO를 쓴다면 프로젝트에서 omo 를 실행하고 평소처럼 요청하면 된다. 일이 복잡해지면 ulw 를 붙이고, 실행 전에 계획을 검토하고 싶으면 /ulw-plan 과 /ulw-execute 를 쓴다. 모델 배정은 메인 모델, 네 보조 에이전트의 모델, 작업 카테고리의 모델을 구분하면 이해하기 쉽다. 메인은 현재 세션 모델로 일하고, 다른 역할에 일을 맡길 때만 그 역할의 모델 목록이 적용된다. 처음에는 기본값으로 써 보고, 바꾸고 싶은 역할이 생겼을 때 그 역할만 설정하자. 참고 자료 OmO GitHub README OmO 공식 설치 안내 오케스트레이션 가이드 에이전트·카테고리 모델 배정 가이드 OmO 설정 문서 OpenCode에서 OmO로 이전하기 senpi 공식 시작 가이드