문제 조건 문자열 문제 설명 문자열에 따라 다음과 같이 두 수의 크기를 비교하려고 합니다. 두 수가 n 과 m 이라면 ">", "=": n >= m "<", "=": n <= " m ">", "!": n > m "<", "!": n < m 두 문자열 ineq 와 eq 가 주어집니다. ineq 는 "<"와 ">" 중 하나고, eq 는 "="와 "!" 중 하나입니다. 그리고 두 정수 n 과 m 이 주어질 때, n 과 m 이 ineq 와 eq 의 조건에 맞으면 1을 아니면 0을 return하도록 solution 함수를 완성해주세요. 제한사항 $1 \leq$ n , m $\leq 100$ 입출력 예시 ineq eq n m result "<" "=" 20 50 1 ">" "!" 41 78 0 문제 풀이 기본 풀이 def solution(ineq, eq, n, m): if ineq == ">": if eq == "=": return 1 if n >= m else 0 else: return 1 if n > m else 0 else: if eq == "=": return 1 if n <= m else 0 else: return 1 if n < m else 0 Python의 eval() 함수 사용한 풀이 def solution(ineq, eq, n, m): if eq == "=": return int(eval(f"{n} {ineq}= {m}")) return int(eval(f"{n} {ineq} {m}")) 느낀점 eval() 문자열로 이루어진 파이썬 표현식(Expression)을 입력받아 실제로 실행한 후, 그 결과값을 반환하는 내장 함수 기본 사용법 및 예시 eval() 함수는 문자열 형태의 수학 계산식, 함수 호출, 데이터 조합 등을 실행할 수 있습니다. 산술 연산: eval("100 + 32") $\rightarrow$ 132 문자열 결합: eval('"BlockDMask" + "blog"') $\rightarrow$ "BlockDMaskblog" 함수 호출: eval("abs(-56)") $\rightarrow$ 56 리스트 길이 계산: eval("len([1, 2, 3, 4])") $\rightarrow$ 4 함수 문법 eval(expression, globals=None, locals=None) expression : 실행할 파이썬 표현식이 담긴 문자열 globals (선택) : 전역 네임스페이스를 지정하는 딕셔너리 locals (선택) : 지역 네임스페이스를 지정하는 딕셔너리
이번 포스팅에서는, 지난 몇 차례의 포스팅을 통해 구현한 통합 대시보드와 세부 대시보드 구현 과정을 돌아보며 계획 수립, 구현, 마무리 과정을 정리하려고 한다. 1. 대시보드 구현 과정 정리 지난 포스팅 통합 대시보드 구현 계획 수립 통합 대시보드 구현 세부 대시보드 구현(1): Nodes & Hosts 세부 대시보드 구현(2): K8s Workloads 세부 대시보드 구현(3): Kubelet & Storage, Spring Application, Telemetry+Usage 1.1 구현 계획 수립, 워크플로 정의 전체적인 워크플로는 이전 SI 개발 현업에서 경험한 개발 프로세스를 참고했다. 이전 경험 회고 유관부서로부터 1) 모니터링할 Pod Statistics 리스트를 받아 개발에 착수 . 2) SQL 쿼리 스크립트를 작성하고 성능을 튜닝 . 실개발 인원인 중국 개발 팀에 3) 쿼리 스크립트가 배포된 Testbed에 접속을 허가 . 해당 서버 상에서 4) Demo를 개발하고 UI를 구현 . 현재 프로젝트와의 공통점 비교 이전 SI 개발 프로젝트(2025) 현재 관측성 플랫폼 구축 프로젝트(2026) 1 Pod Statistics 리스트 A 수집 Metrics 리스트 2 SQL 쿼리 스크립트 B PromQL 3 Testbed/상용 인프라 환경 C 현재 구축한 클러스터 인프라 4 외주 개발 대시보드 UI D Grafana Cloud 대시보드 UI 위와 같은 공통점을 바탕으로 구현 계획 자체를 수립하는 과정은 어렵지 않았으나, 유관부서와의 협업 결과물을 개인 프로젝트에 대입하려 하니, 작업의 순서와 사용 툴, 작업 목적을 명확히 하는 과정이 필요했다. 대시보드 구현 계획 수립 (통합 대시보드/세부 대시보드 공통) 단계 수행 내용 활용 가능 툴 1 수집 Metrics 목록 확정, Metrics 리스트 파일 작성 MS Excel, AI Tool(Codex) 2 Metrics별 PromQL 작성 Grafana Explore 3 Metrics 계측 검증 및 결측 확인 Grafana Explore 4 대시보드/패널 규모 및 분류 기준 확정 Grafana Cloud Dashboard 5 대시보드 UI 구현 및 수집 검증 Grafana Cloud Dashboard (6) 선택적 관측 사항 보강 협업 툴(Jira)에 관련 Task 생성 혼자서 작업하는 환경이지만, 협업 상황에서의 스케줄 관리 등을 간접 경험할 겸.. 개발 과정을 기록해 온 Jira Backlog에 관련 Task를 추가했다. (완료 작업과 처음 백로그 구성 시 설정한 마감 기한이 약 3주 넘게 차이가 난다... 협업 환경에서는 스케줄 설정 시 개인 일정을 꼭 고려하자.. ) 1.2 수집 Metrics 리스트 생성 현재 클러스터에서 수집 중인 Metrics 중 대시보드에 시각화 할 Metrics를 정리한 리스트를 작성했다. Metrics 리스트를 작성하기 위해, 다음과 같은 과정으로 진행했다. 클러스터에서 수집하고 있는 Metrics 목록 확보 Metrics 분류 기준 수립 및 대시보드 구성 확정 Microsoft Excel 형식의 Metrics 리스트로 변환 OpenTelemetry Collector의 6개 Receiver를 통해 수집하고 있는 모든 Metrics를 아래와 같은 방식으로 JSON 형식으로 Export했다. 수집 Metrics 조회 (PromQL) { job=~"node-exporter|kubelet|cadvisor|kube-state-metrics|otel-collector|spring-app" } 조회 결과를 JSON 형식으로 Export (Grafana Cloud Web) Metrics 분류 기준 및 대시보드 구성 방안 수립 대시보드 구성은 통합 대시보드 1개 와 그 대시보드를 통해 파악한 문제점을 상세히 파악할 세부 대시보드 5개 로 분류했다. 이전 SI 개발 현업에서 개발한 모니터링 소프트웨어가 Overall한 모니터링을 위한 메인 페이지 와 세부 모니터링을 위한 복수의 탭 을 두었던 점을 참고했다. 통합 대시보드 (1개) 대시보드 모니터링 타깃 1 Platform Overview 통합 대시보드. 확인이 필요한 구성요소 탐지 및 세부 대시보드 이동 세부 대시보드 (5개) 대시보드 모니터링 타깃 2 Nodes & Hosts Host 리소스 부족 탐지 3 Kubernetes Workloads K8s 리소스/구성요소 상태 확인 4 Kubelet & Storage 실행 관리 + 볼륨 이상 탐지 5 Spring Application Spring App 요청 실패 탐지 6 Telemetry + Grafana Usage Scraped Samples, Collector 상태, Grafana Cloud 리소스 사용량 확인 메인 페이지 성격의 통합 대시보드(00-Platform Overview)와 5개의 세부 대시보드를 Link로 연결 하여 탭 버튼을 클릭하면 세부 대시보드로 이동하는 구조이다. Metrics 리스트 파일 생성 다음으로, AI Tool인 Codex 에 다음 프롬프트와 같이 명령하여 .xlsx 형식의 Metrics 리스트를 생성했다. # 프롬프트 * Metrics Snapshot JSON 파일을 읽고, 파일 내에 기록된 Metrics를 누락 없이 리스트에 반영할 것 * 제시한 대시보드 구분점을 정확히 반영하여 Metrics를 분류할 것 * Metrics가 수집된 Receiver와 데이터의 성격(Counter/Gauge 등)을 명시할 것 * 각 Metrics에 대한 간략한 설명을 첨부할 것 1.3 Metrics 상세 분석 및 PromQL 작성 생성한 Metrics 리스트를 바탕으로 대시보드 패널의 규모를 대략적으로 구상하고, 시각화를 위한 PromQL을 작성하기 위해 아래와 같은 과정으로 진행했다. Metrics 분석(Metrics 리스트 내 설명 기반, 필요 시 Deep-dive) 대시보드/패널 규모 산정 및 Metrics 선별 (필수 구현/필요 시 보강) 최종 선별한 Metrics Query를 위한 PromQL 작성 Metrics 분석 가장 많은 시간을 할애한 부분이다. 과거 SI 개발 프로젝트 수행 당시 느꼈던 어려움으로, "모니터링 소프트웨어를 개발하고 있는데, 무엇을 모니터링하는 건지 모르는 상황" 이 있다. Pod Statistics 지표들이 다소 Specific해서, 외주 개발진과 함께 어떤 시각화 타입이 효과적일지 논의하는 데 어려움을 느낀 경험이 있다. 따라서, 적어도 "무엇을 모니터링할 지" 와 "어떻게 시각화할 지" 두 가지에 대해서는 가시적인 성과보다 "내가 이해하고 있는가" 에 초점을 맞추고 진행했다. 공부 방법은 간단했다. 해당 Metrics를 그대로 포털에 검색하고 알아보는 방식이다. 인프라 구축 과정에서는 공식 문서 이외의 외부 링크를 참고하는 것을 지양했지만, Use Case에 대한 정보를 얻는 데에는 외부 링크가 더 효과적이었던 것 같다. 대시보드/패널 규모 산정 리스트의 Metrics를 모두 시각화하면 전체 대시보드의 규모가 방대해지는 문제가 있어, 우선 10~12개의 패널을 가진 소규모 대시보드 를 구성하고 필요 시 보강하는 방향으로 구성했다. 핵심적인 모니터링 방향성을 "안정적인 상태와 장애 상황을 명확히 구분하는 것" 으로 정하고, Metrics를 선별했다. 대부분의 모니터링 지표를 변화량 으로, 패널을 시계열 그래프 로 구성했다. 추후 목표가 클러스터에 의도적으로 장애를 일으키고, 대시보드를 통해 변화 감지(or 알람 발생) → 원인 분석 → 대응 → 확인 하는 장애 대응과 트러블슈팅을 경험하기 위함임을 고려했다. PromQL 작성 Codex를 활용해 PromQL을 작성하고, 포털에 검색하여 검증했다. 추가로, Metrics 가공에 사용된 여러 함수의 적절성을 검토하고 각 패널의 시각화 그래프의 종류를 선정했다. 이후, Grafana Cloud 웹에서 대시보드를 구성하고 각각의 PromQL을 적용해 패널을 구성했다. 2. Dashboard Outputs 구현 계획 수립 수집 Metrics 리스트 작성 Metrics 상세 분석 및 PromQL 작성 의 과정을 거쳐 구현한 대시보드는 아래와 같다. 2.1 Overall Dashboard 2.2 통합 대시보드 클러스터의 전반적인 상태를 확인할 수 있도록 구성한 통합 대시보드이다. 상단에 링크를 클릭하면 세부 대시보드로 이동한다. 2.3 세부 대시보드 1) Nodes & Hosts 모니터링 클러스터를 구성하는 4대의 VM과 호스트의 리소스 부족 등을 탐지 하기 위한 세부 대시보드이다. 2) Kubernetes Workloads 모니터링 클러스터를 구성하는 Kubernetes 리소스 및 컴포넌트의 상태 등을 확인 하기 위한 세부 대시보드이다. 3) Kubelet & Storage 모니터링 클러스터 내에서 작업의 실행 관리 및 스토리지/볼륨의 이상을 탐지 하기 위한 세부 대시보드이다. 4) Spring Application 모니터링 클러스터 내에서 동작하는 Spring Application의 요청 실패 등을 탐지 하기 위한 세부 대시보드이다. 5) Telemetry & Usage 모니터링 OpenTelemetry Collector의 수집 상태와 Sample Relabeling, Grafana Cloud 리소스 사용량을 확인 하기 위한 세부 대시보드이다. 3. 의의, 추후 개발 계획 이 프로젝트 목표는 1.3절에 작성한 바와 같이, "클러스터에 의도적으로 장애를 일으키고, 대시보드를 통해 변화 감지(or 알람 발생) → 원인 분석 → 대응 → 확인하는 장애 대응과 트러블슈팅을 경험" 이다. 3.1 얻은 것 Metrics 최적화 이전, 구현한 모니터링은 Spring Application에 국한 되어 있었다. 외부 개발자가 개발한 Spring Application 모니터링 대시보드를 import한 단일 대시보드 형태였고, Spring Application의 역할도 "테스트용 텔레메트리를 생성"하는 것에 지나지 않았다. 모니터링 범위를 기존의 Application only에서 Cluster-wide로 확장 하면서, 아래 3가지를 확보할 수 있었다. Metrics 최적화를 통해 Grafana Cloud Tenant Limit으로 인한 Metrics Drop 해소 및 Limit 내에서 모니터링 구현 Cluster 전반의 상태에 대한 관측성 확보 Customized 대시보드 구현으로 관측 데이터에 대한 이해 확보 3.2 얻어야 할 것 (추후 개발 계획) 추후 개발을 통해 확보해야 할 내용들도 존재한다. Spring Application 고도화 현재 "테스트용 텔레메트리를 생성"하는 역할에 국한된 Spring App을 고도화하여, 실질적인 Logs와 Traces 데이터, HTTP Requests를 생성하도록 보강한다. 또한, Spring App에 지속적인 트래픽을 발생시키고, 부하를 모니터링하며 핵심 모니터링 타깃인 Spring Application의 모니터링을 보강 개발을 통해 고도화할 계획이다. 관측 데이터 보강 Spring Application 보강 개발에 따라, 확보해야 할 Metrics를 추가로 수집하여 04-Spring Application 에 시각화할 계획이다. 또한, Spring Application의 PostgreSQL 데이터베이스 등 모니터링 타깃을 더 확장할 필요성도 있다. 장애 대응 및 트러블슈팅 Case Studies 위 두 가지 보강 개발이 진행되면, 프로젝트의 최종 목표를 수행할 수 있다. 장애를 유발하는 Case를 조사하고, 실제로 클러스터에 장애를 유발한다. 그 해결 과정을 통해 미처 확인하지 못한 클러스터의 세부적인 사항들과 통신 원리를 알아보고, 실제 장애 대응 프로세스를 따라 트러블슈팅을 진행할 수 있다. 다음 포스팅부터는 Spring Application을 고도화하고, 역할 확대에 따른 모니터링 범위 확장 과정을 기록해보려 한다.
📅 Date : 2026.09.26 🏷️ Tags : #Python #AI #MultiModal 🎯 이번 주 논문 소개 텍스트는 AR, 이미지는 diffusion으로 통합한 모델인 Show-o 모델에 대해 설명한다. 📌 Contents 선행 연구 서론 주요 방법론 실험 결과 결론 인사이트 도출 1️⃣ 선행 연구 ✨ 선행연구 Multimodal Understanding(멀티모달 이해) LLaVa, MiniGPT-4 등 LLM을 활용한 초기 연구들을 언급 이들은 CLIP과 같은 모달별 인코더의 특징을 LLM의 입력 공간으로 투영(Projecting)하여 비전-언어 이해 및 추론 능력을 확보하는 설계 방식을 채택 Visual Generation autoregressive model : 트랜스퍼머의 구조를 이용해 이미지 픽셀간의 의존성을 순차적으로 학습하는 방식 diffusion model : 연속적인 잠재공간에서 가우시안 노이즈를 예측하고 제거하는 방식(Stable Diffusion) 이 주류를 이루며, 이산적인 데이터 형태에서 노이즈를 제거하는 방식을 대안을 제시(MaskGIT, D3PM) Unified Vision-Language Foundation Model 이해와 생성을 동시에 수행하려는 최신 연구들을 소개 SEED-X나 DreamLLM 등은 연속적인 표현이나 토큰화 기법을 사용하여 통합 시스템을 구축 2️⃣ 서론 연구배경 : 기존 멀티모달은 주로 각 도메인을 독립적으로 취급하며, 이해와 생성을 각각 담당하는 개별 모델들을 포함하는 경우가 많다. 이해 분야 : LLaVA와 같은 MLLM이 시각적 질의응답 등에서 탁월한 성능 생성 분야 : DDPM 기반의 모델들이 텍스트-이미지/비디오 생성에서 혁신적인 성과 문제 제기 : 서로 다른 영역으로 발전해 온 멀티모달의 이해와 생성 기술을 하나의 모델로 처리할 수 있는가? 기존 연구의 한계 : 이미지/비디오 패치가 자기회귀적으로 모델링하는 것이 더 나은지 여부는 불분명함. 이미지를 자기회귀적으로 예측할 때의 명백하고 중요한 병목 현상 발생 연구 제안 : text → autoregressive 방식으로, 이미지→Discrete Diffusion 모델링 방식으로 처리하는 새로운 통합 패러다임인 Show-o 를 제안 3️⃣ 주요 방법론 ✨ 주요 방법 : tokenization 통합 공간에서의 학습 : Show-o는 사전 학습된 LLM을 기반으로 하므로, 텍스트와 이미지 데이터를 모두 이산적 공간에서 처리 ← 텍스트 토큰과 이미지 토큰을 모두 포함하는 Unified Vocabulary를 유지 텍스트 토크나이저 : 기존 사전 학습된 LLM의 토크나이저를 수정 없이 그대로 사용 이미지 토크나이저 : MAGVIT-v2 를 사용하여 이미지를 이산 토큰으로 변환 이해 성능을 위한 추가적인 입력 전략 : Multimodal Understanding 성능을 높이기 위해 기본 이산 토큰 방식 외에 두 가지 옵션을 추가로 탐구 옵션 (b) : MAGVIT-v2 인코더에서 추출한 연속적 이미지 표현 사용. 옵션 (c) : 사전 학습된 CLIP-ViT 인코더에서 추출한 연속적 이미지 표현 사용. ✨ 방법론 : Architecture Show-o는 기존의 사전 학습된 LLM(구조를 그대로 활용 학습 안정성을 높이기 위해 각 어텐션 레이어 앞에 QK-Norm 연산 만을 추가 임베딩 공간 확장: 이산 이미지 토큰을 처리하기 위해 기존 LLM의 임베딩 레이어에 8,192개의 새로운 학습 가능한 임베딩을 추가 → 텍스트와 이미지를 하나의 통합된 Vocabulary로 관리 Unified Prompting : 다양한 다중 모달 이해 및 생성 태스크를 하나의 시퀀스로 처리하기 위해 특수 토큰을 도입 Omni-Attention 메커니즘: 입력 시퀀스에 따라 Causal attention과 Full attention을 적응적으로 혼합하여 사용 텍스트 토큰: 순차적인 정보 처리를 위해 Causal Attention을 적용 이미지 토큰: 이미지 내 토큰 간의 포괄적인 상호작용을 위해 Full Attention을 적용 4️⃣ 실험 ✨ 실험 설정 학습 데이터셋 구성: 약 35M및 2.0B규모의 이미지-텍스트 쌍을 수집하여 학습에 활용 + 모델이 텍스트 추론 능력을 잃지 않도록 RefinedWeb 데이터셋을 추가로 활용 평가 지표 및 벤치마크 Understanding: POPE, MME, Flickr30k, VQAv2, GQA, MMMU 벤치마크를 사용 Generation: MSCOCO 데이터셋의 FID와 GenEval 벤치마크 ✨ 실험 결과 멀티모달 이해 능력으로는 1.3B 규모의 Show-o는 이해력에 특화된 LLaVA-v1.5와 대등한 성능 시각적 생성 능력으로는 MSCOCO에서 9.24의 FID를 기록하여 훨씬 큰 모델들과 비교해도 경쟁력 있는 성능을 보임. GenEval 벤치마크에서는 2B 크기의 SD3와 대등한 성능을 보이며, 1.3B 파라미터로도 생성 특화 모델 이상의 효율성을 발휘 ✨ Ablation Studies 데이터가 많을수록, 해상도가 높을수록 이해 성능이 일관되게 향상 CLIP-ViT를 사용한 연속형 표현이 MAGVIT-v2 기반의 이산 토큰보다 이해 성능 면에서 유리함 자귀회귀 방식의 모델들이 이미지 생성에 1,024단계가 필요할 때, Show-o는 50단계만으로도 상세하고 현실적인 이미지를 생성하여 약 20배 빠른 효율성 5️⃣ 결론 및 한계점 ✨ 결론 Show-o는 서로 다른 모달리티를 고유한 방식으로 처리할 수 있는 autoregressive 모델링과 diffusion 모델링을 최초로 통합 광범위한 실험 결과는 Show-o가 다양한 비전-언어 작업 전반에서 개별 전문가 모델과 비슷하거나 더 우수한 성능을 보임을 입증 6️⃣ 인사이트 도출 💡 “한줄요약 문구 작성” autoregressive 텍스트 추론 능력과 diffusion 모델의 효율적인 이미지 생성 능력을 단일 트랜스포머에 통합하는 Show-o 제안 📚 References Xie, J., Mao, W., Bai, Z., Zhang, D. J., Wang, W., Lin, K. Q., ... & Shou, M. Z. (2025, May). Show-o: One single transformer to unify multimodal understanding and generation. In International Conference on Learning Representations (Vol. 2025, pp. 28240-28264).
Kaggle 타이타닉 train.csv (891행, 12컬럼)로 승객의 생존 여부( Survived )를 맞히는 이진 분류를 해봤다. 모델은 LogisticRegression 하나만 썼고, 흐름은 EDA → 전처리 → 분리 → 스케일링 → 학습·튜닝 → 평가 순서다. 데이터 누수부터 짚고 가기 순서에서 제일 신경 쓴 건 분리를 스케일링보다 먼저 하는 거였다. StandardScaler 를 전체 데이터에 fit 하면 평균과 표준편차 안에 테스트 데이터 정보가 섞여 들어간다. 그러면 테스트 점수가 실제보다 좋게 나올 수 있다. 그래서 학습 데이터로만 fit_transform 하고, 테스트 데이터에는 transform 만 했다. 데이터 살펴보기 결측치는 세 컬럼에 있다. 컬럼 결측치 Age 177 Cabin 687 Embarked 2 Cabin 은 891개 중 687개가 비어 있어서 아예 버렸다. describe() 를 보면 Age 는 최소 0.42, 최대 80이고 Fare 는 최소 0, 중앙값 14.45인데 최대가 512.33이다. 박스플롯에서도 두 컬럼 모두 수염 밖으로 튀는 점들이 보인다. 그래도 이상치로 보고 지우지는 않았다. 0.42세는 돌이 안 된 아기일 뿐이고, 512파운드짜리 요금도 1등석 승객이 비싼 표를 산 거라 충분히 있을 법한 값이다. 타깃 비율은 사망 61.6%, 생존 38.4%다. 반반이 아니라서 뒤에서 데이터를 나눌 때 이 비율을 신경 써야 한다. 전처리 PassengerId , Name , Ticket , Cabin 을 빼고, 동승 가족 수를 합친 FamilySize 를 하나 만들었다. titanic_df = df.drop(["PassengerId", "Name", "Ticket", "Cabin"], axis=1) titanic_df["FamilySize"] = titanic_df["SibSp"] + titanic_df["Parch"] + 1 titanic_df["Age"] = titanic_df["Age"].fillna(titanic_df["Age"].mean()) titanic_df["Age"] = titanic_df["Age"].astype(int) titanic_df["Sex"] = titanic_df["Sex"].map({"male": 0, "female": 1}) titanic_df = pd.get_dummies(titanic_df, columns=["Embarked"], drop_first=True, dtype=int) 코드를 하나씩 보면 이렇다. Age 결측치는 평균 으로 채우고 정수로 바꿨다. 나이 분포가 오른쪽으로 꼬리가 있어서 사실 중앙값(28)이 더 안전한 선택이긴 하다. 평균은 29.7이라 이 데이터에선 차이가 크진 않다. Sex 는 map 으로 male → 0, female → 1로 바꿨다. 값이 두 개뿐이라 원-핫이 필요 없고, 그냥 0/1 라벨로 충분하다. Embarked 는 C, Q, S 세 값을 get_dummies(drop_first=True) 로 원-핫 인코딩해서 Embarked_Q , Embarked_S 두 컬럼이 됐다. 여기서 주의할 점이 있다. 결측치 2개를 따로 채우지 않았기 때문에, 그 두 행은 두 더미가 모두 0이 되면서 결과적으로 C(셰르부르) 승객과 똑같이 취급된다. 의도대로 하려면 get_dummies 전에 최빈값(S)으로 채워주는 게 맞다. 최종 피처는 Pclass , Sex , Age , SibSp , Parch , Fare , FamilySize , Embarked_Q , Embarked_S 이렇게 9개다. 표준화를 고른 이유 Fare 는 절반이 14.45 아래인데 최댓값이 512다. Min-Max 정규화를 쓰면 512가 1이 되고 나머지 대부분이 0 근처로 몰려버린다. 그래서 평균 0, 표준편차 1로 맞추는 StandardScaler 를 골랐다. 학습/테스트 분리 X = titanic_df.drop("Survived", axis=1) y = titanic_df["Survived"] X_train, X_test, y_train, y_test = train_test_split( X, y, test_size=0.2, stratify=y, random_state=2026 ) # (712, 9) (179, 9) scaler = StandardScaler() X_train_scaled = scaler.fit_transform(X_train) X_test_scaled = scaler.transform(X_test) stratify=y 를 준 건 생존 비율이 6:4로 기울어 있어서다. 그냥 무작위로 자르면 학습 세트와 테스트 세트의 생존 비율이 서로 달라질 수 있고, 그러면 학습한 분포와 평가하는 분포가 어긋난다. 실제로 테스트 179명은 사망 110명, 생존 69명으로 원래 비율이 거의 그대로 유지됐다. 로지스틱 회귀와 C 튜닝 기본 설정으로 먼저 돌려봤다. lr = LogisticRegression() lr.fit(X_train_scaled, y_train) y_pred = lr.predict(X_test_scaled) # train score: 0.8034 # test score: 0.7877 모델이 학습하면서 스스로 찾는 값(회귀 계수, 절편)이 파라미터고, 학습 전에 사람이 정해주는 값이 하이퍼파라미터다. 로지스틱 회귀에서 대표적인 하이퍼파라미터가 규제 강도를 정하는 C 다. 작을수록 규제가 세진다. for C in [0.01, 0.1, 1, 10, 100]: model = LogisticRegression(C=C, max_iter=1000, random_state=2026) model.fit(X_train_scaled, y_train) ... C train test 0.01 0.8104 0.7821 0.1 0.7992 0.7877 1 0.8034 0.7877 10 0.8034 0.7877 100 0.8034 0.7877 0.1 이상부터는 테스트 정확도가 전부 같다. 피처가 9개뿐이라 규제를 풀어도 과적합될 여지가 별로 없는 것 같다. 기본값 C=1 을 그대로 써도 된다는 결론이다. 다만 이렇게 테스트 점수를 보고 하이퍼파라미터를 고르면 테스트 세트가 사실상 검증용으로 쓰이게 된다. 제대로 하려면 학습 데이터 안에서 교차 검증( GridSearchCV 같은)으로 고르고, 테스트 세트는 마지막에 한 번만 보는 게 맞다. 평가 Accuracy : 0.8045 Precision: 0.7656 Recall : 0.7101 F1 Score : 0.7368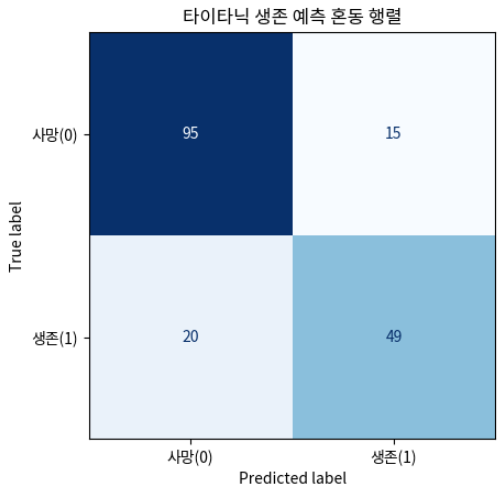 precision recall f1-score support 사망(0) 0.83 0.86 0.84 110 생존(1) 0.77 0.71 0.74 69 accuracy 0.80 179 macro avg 0.80 0.79 0.79 179 weighted avg 0.80 0.80 0.80 179 0.79 179 혼동 행렬을 풀어 쓰면, 실제 사망자 110명 중 92명은 맞혔고 18명은 생존으로 잘못 예측했다. 실제 생존자 69명 중에선 49명을 맞혔고 20명을 사망으로 예측했다. f1_score 는 기본적으로 양성 클래스(생존=1) 기준으로 계산된다. 정확도 78.8%보다 F1이 72.1%로 낮은 건, 수가 적은 생존 쪽이 사망 쪽(F1 0.83)보다 덜 맞았다는 뜻이다. 소수 클래스를 상대적으로 못 잡고 있는 셈이다. 어떤 오류가 더 치명적일까 구조 상황을 가정하면 실제 생존자를 사망으로 예측하는 쪽(FN, 20명) 이 더 위험하다. 살릴 수 있는 사람에게 구조 인력이 안 가게 되니까. 반대로 사망자를 생존으로 예측하면 인력이 헛걸음하는 정도로 끝난다. 이 관점이라면 생존 클래스의 재현율(현재 0.71)을 올리는 게 우선이다. 로지스틱 회귀는 predict_proba 로 확률을 주기 때문에, 0.5인 판정 기준을 낮춰서 재현율을 올리는 방법도 쓸 수 있다. 손볼 만한 부분 Embarked 결측치를 최빈값으로 채운 뒤 원-핫 인코딩하기 Age 를 중앙값으로 채우거나, 호칭(Mr, Mrs, Miss, Master)별 중앙값으로 채우기 FamilySize 는 SibSp + Parch + 1 이라 원본 두 컬럼과 정보가 겹친다. 하나만 남기거나 IsAlone 같은 다른 파생변수를 시도해볼 만하다 C는 교차 검증으로 고르기
몇 개월전 - 매번 여자친구가 우리 다음에 여기 가자. 저기도 가자. 여러 링크와 디엠을 보내지만 다음날이면 까먹는 나를 발견. 이건 나의 존폐에 문제가 생길 수 도 있겠단 생각에 앱을 만들기로 했다. 그거슨 '커플 데이트 리스트 공유 앱' 획기적이다.🐣 앱의 역할은 간단하다. 데이트 장소 저장, 그리고 연동된 상대와 공유. 데이트 일정을 캘린더에 등록/공유하고, 다녀오면 기록. 그런데 너무 많은 추가 기능들이 머릿속에 몰려왔고, 기능부터 수익 구조까지 점점 어느 순간 비대한 눈덩이가 돼있었다. 정말 방대한 방댕이가 되어버린 기획안. 👶"GPT야. 내가 기획한 커플 앱 기획안인데, 아기인 내가 구현 가능할까?" 🤖"겠냐?" 오키. 바로 수긍하고 일단 핵심 MVP 먼저 만들기로. 가제는 OurDate ('우리 여기가자!'를 앱 이름으로 할까 생각 중) 우선 4개의 기본 탭을 만들었다. OurDate ├── DateList ├── Calendar ├── Map └── Settings 이제 앞으로 이 탭들에 여러 기능들을 채워나갈 예정이다. 물론 나혼자서는 못한다. 절대. 난 아기니까.👶 나의 코덱스와 함께 채워나갈 예정이다.