프롤로그: 대학교에서 학점은행제에서 필요한 학점 때문에 수업듣는 산넘어는 고생길이 시작되는데.... ====== 산넘어: 안녕하세요. 다들 강의 잘 들으셨죠? 이번에 교수님이 기말고사 대체로 조별과제를 내 주셨는데 복불복으로 뽑는 바람에 다 초면인 분들이네요, 잘 부탁드려요. 이우전: 뉘예뉘예~ 나영속: 네, 한 번 잘 해보죠. 산넘어: 제 이름은 산 넘어고요. 저희가 담당하게 된 주제가 예상보다 더 많더라구요, 시험기간이므로 조별과제부터 일찍 끝내고 다른 시험도 잘 준비해보죠. 이우전: 네~ 나영속: 그럼 조도 짜여졌겠다, 친목도 다질겸 회식 한 번 해야 하지 않을까요? 다들 시간 어떠세요?? 이우전: 죄송하지만 전 이번 달 내내 방송 대본 짜야해서 시간 없을 듯 하네요~ 나영속: 아;; 그러시구나;;;; 그럼 다음에 시간날 때 1잔 어떠십니까?ᄒ 산넘어: 자 만나는 건 나중에 얘기하고 저희 분량 먼저 나눌까요? 총 3단원 84페이지니까 각각 1단원씩 28 페이지씩 공평하게 나누려는데 이견 있나요? 이우전: 아뇨~ 그렇게 해요~ 산넘어: 그럼 각자 분량 잘 맡아서 열심히 해가지고 저희 좋은 점수 받아봐요. 일단 다음 달까지 자신이 맡은 분량 정리해서 저희끼리 발표 준비해 오는 걸로 하고 조장은 제가 맡을게요, 다들 괜찮으시죠? 이우전: 네~ 뭐 알아서 하세요~ 그리고 죄송한데 제가 지금 업무 때문에 이제 톡 못할 것 같거든요? 다음 달에 다시 회의해요~ 1주 뒤 나영속: 저, 조장님. 다름이 아니라 할 말씀이 좀 있는데요.. 산넘어: 할 말씀이요? 나영속: 제가 맡은 파트 보니까 분량이 상당하더라구요. 좀 불공정하단 생각도 들고 사실 제가 이번이 막학기고 이직 준비까지 하고 있는데요? 산넘어: 파트는 단원 당 28페이지니까 다 공정하다 생각하는데요? 문제될 건 없다고 여겨집니다. 나영속: 제가 꼭 들어가고 싶은 회사가 있는데 거기서 요구하는 자격증 시험 땜에 조별과제랑 병행하기 좀 많이 어렵거든요?ᄒ;; 산넘어: 저도 막학기이고 영속님과 마찬가지로 일자리 구하는 상황인데요?;;; 나영속: 아 그래도 파이널 파트가 가장 어렵긴하잖아요, 저 다른 학과라 이 강의 너무 어렵다고요. 산넘어: 강의만 열심히 따라가면 다 이해되던데요?? 게다가 저도 처음 배우는 건데;;; 나영속: 아 레알 조별과제 이렇게 선 딱딱 긋는거 너무 정 없지 않나요? 좀 도와주십쇼~! 각박하게 그러지 마시고... 조장이시잖아요. 산넘어: ......... 하.. 일단 알았습니다. 조장 맡기로 했으니까 제가 약간 더 도와드릴게요. 나영속: 오 레알요? 감사합니다ᄏᄏ 덕택에 기분도 좋아졌는데 조장님 지금 만나서 막걸리 한 잔 하실래요? 이우전님도 꼭 불러가지고 파전에 막걸리 한 잔 하면서 머리에 알코올을 채워넣으면 머리가 맑아질테니 과제도 술술 풀릴 듯 한데ᄒ 산넘어: 아.. 근데 제가 헌혈을 하고 있어서 요새 술 마시면 안 돼요. 나영속: 아 너무 빼시네~ 술 못하시나 봐요~? 그럼 뭐 회식은 담에 하죠, 일단 제 분량 좀만 부탁할게요. 한 20페이지 까지만 해 주시면 될 것 같아요. 산넘어: 20페이지요?;; 이 정도면 거의 다 아니예요?;;;;; 나영속: 이 부분만 해결하면 나머지는 제가 알아서 할게요. 이왕 해주시는거 저희 쿨하게 가죠~! 산넘어: 아니 근데 이 정도면 저더러 거의 다 하란 뜻이잖아요;; 제 분량도 엄연히 있는 상태인데;; 나영속: 제 전공이 아니므로 많이 어려우니 그렇죠. 대신 도와주시면 다른 부분에서 제가 도와드릴 부분 생길 때 제가 더 맡아서 할게요. 산넘어: 하.. 일단 알았으니까 이번 달 자료조사 부분은 제가 더 해드릴테니 다음 회의 때는 좀만 더 신경 좀 써주세요. 나영속: 네~ᄒᄒ 중간회의 산넘어: 안녕하세요, 한 달간 다들 잘 지내셨나요? 이우전: 업무하느라 정신 없었네요. 나영속: 조장님~ 비도 오는데 이런 날은 소주에 두부김치 먹으면 딱인데 그쵸? 혹시 다들 오늘 시간 괜찮으세요? 모여서 이야기하는 시간도 필요하다고 보는데. 이우전: 저 오늘 끝나고 마사지 받는데요? 나영속: 아.. 그럼 어쩔 수 없죠.. 다음에 먹어요 저희.. 산넘어: 기억났는데 엑셀을 만들어야 되는데 혹시 컴퓨터 좀 익숙하신 분 계세요? 이우전: 전 컴맹이라 전혀 몰라요 나영속: 저도 컴퓨터는 영 젬병이라;; 그냥 조장님이 해주시면 안되나요? 산넘어: ........ 그럼 제가 엑셀 제작 할테니까 이우전님이 발표 좀 맡아주실 수 있나요? 이우전: 아이고.. 제가 지금 교정기를 해서 발음이 좀 어색하거든요. 이것 참 유감이네요.. 발표는 우리 영속님이 해주시면 안 되나요? 나영속: 우리 영속님?? 헤헷~ 물론이죠~ 그럼요 ! 발표 하난 기똥차게 할 자신 있습니다. 믿고 맡겨만 주시죠 !ᄒᄒ 이우전: 산조장님 제가 E메일 보낸거 체크하셨나요?? 제가 자료조사 한다고 온라인 다 뒤져가며 한땀한땀 꼼꼼하게 했으니까 이정도면 2인분 넘게 한듯 하네요~ᄏ 태클은 미리 사절합니다. 산넘어: 안그래도 이우전님이 주신 자료 체크를 좀 해봤는데 이거 온라인에서 그대로 긁어오신거 아니예요? 사이트랑 장작위키에 있는거 짜깁기 한 것 같은데;;; 이우전: 태클은 거절한다고 했을텐데요? 더구나 제가 온라인에서 하나하나 다 찾아보고 가져온거라 딱히 문제될 건 없어요ᅳᅳ 산넘어: 하아.. 그럼 일단 보내주신 자료 다시 정리해보죠. 다만 다음엔 바로 긁어오지 마시고 직접 생각 정리한 후에 타이핑 부탁드립니다. 이우전: 하 조장님 정말 깐깐하시네ᅳᅳ 아 알겠어요 담엔 그리 할테니까 이번은 좀 걍 넘어가시죠. 나영속: 저도 자료조사한게 있는데 2시간만 더 주시면 더 정리해서 조장님한테 전송해드릴게요. 산넘어: 영속님 열심히 하는 건 좋은데 다음엔 약속 시간 지켜주시면 안 되나요? 나영속: 아니 제가 더 열심히 해서 드리겠다는데 꼭 그렇게 말해야 속이 후련해요? 다 좋은 점수 받자고 좀 더 신경써서 보낸다잖아요. 산넘어: 제가 딴죽 걸려는건 아니고 저도 다른 과제가 있고 영속님이 부탁해서 분량도 거의 제가 다 맡아드렸잖아요. 그러니까 적어도 시간 정도는 지켜달란거죠. 나영속: 아 긁혀서 과제 할 마음 팍 식네ᅳᅳ 기분 전환도 할 겸 좀 쉴테니까 자료는 모레까지 보내드리죠ᅳᅳ 산넘어: 아뇨 저기 영속씨;;;; 저도 조별과제만 있는게 아니라 다른 과목도 있으니까 좀 부탁 드립니다. 나영속: 아니 제 기분이 이런데 과제 할 맛이 나겠어요? 인간 긁을땐 언제고ᅳᅳ 그거 스무 페이지 더 해주니까 긁을 자격 된다 이거에요?? 조별과제인데 니꺼 내꺼 구분을 왜 해요 좀 더 할 수도 있는거지 우리 한 패 아니에요? 산넘어: 아 알겠으니까 이제 니꺼 내꺼 구분 안 할테니 파이팅 합시다. 나영속: 그럼 파이팅 하잔 의미로 단합도 할 겸 식사 한 번 하시죠. 이우전님 혹시 마사지 끝나고 시간 괜찮으신지요? 조장님은 바쁘시면 안 오셔도 괜찮고요ᄏ 이우전: 저 남편이랑 외식 있어서 안되겠네요~ 나영속: 아... 그래요??;; 선약 있으셨구나... 알았어요... 조별과제 발표 D-1 이우전: 저기 조장님. 산넘어: 네? 이우전: 제가 이번에 여행을 계획했는데 저희 조별과제 발표날이랑 시간이 겹치더라구요. 산넘어: 네? 여행이요? 아니 그걸 이제 말하면 어쩌라고요? 명일이 발표날인데;; 이우전: 남편이랑 결혼기념일이라 지심도에 가기로 했는데 미리 말한다는걸 망각하고 있었네요;; 산넘어: 그럼 조절하셔야죠;; 이거 기말대체잖아요.. 이우전: 아니 그럼 유람선을 벌써 예약했는데 이제와서 어떡하라구요?? 발표 끝나고 항구 갈 때까지 유람선 못 떠나게 묶어라도 두란 의미에요? 전 그래도 자료조사 담당이니까 발표할 때 굳이 전 필요 없잖아요. 산넘어: 말이 자료조사지, 온라인에 있는거 그대로 퍼와놓고 그게 할 소리에요? 진짜 예의 없으시네? 발표날 안 오면 이름 다 뺍니다? 이우전: 아니 유람선이랑 민박집 다 예약해놨는데 죄다 취소 하라구요? 취소하면 손해 본 거 조장님이 물어줄 거예요? 산넘어: 아니 그걸 제가 왜 물어줘요? 이우전님 진짜 개념 없으시네? 이우전: 아니 발표 D-DAY에 잠수타면 매너가 아니니 D-1인 금일이라도 알려드렸잖아요ᅳᅳ 그리고 고액 장학금 때문에 해당 수업 잘 받아야 하는데 이 정도 귀띰했으면 조장님도 생각이 있는 휴먼일테니 알아 먹었을거라 생각하고 명일 잘 좀 부탁드립니다ᅳᅳ 나영속: 엥? 그럼 저도 명일 다른 수업 시험 대비나 할게요. 어차피 막학기라 점수 크게 상관없기도 하고.. 그냥 우전님 오랜만에 재회하고 싶었는데 유감이네요. 조장님이 발표 좀 잘해주세요~ 산넘어: ;;;;;;;;;; 발표 당일 산넘어: 참~ 감사합니다 여러분ᅳᅳ 덕택에 금일 아주 나홀로 원맨쑈 잘했네요 ᅳᅳ+ 이우전: 그래도 조장님 덕택에 지심도에서 잘 놀고있네요. 나영속: 조장님 고생 많았네요~ 그런 의미로 식사 한 번 할까요?? 산넘어: 식사는 나영속님 혼자 실컷하시죠ᅳᅳ 금일 교수님께 있는 진실 그대로 다 보고드렸네요. 나영속: 네? 그대로 보고하셨다고요? 그래서 교수님은 뭐라시는데요? 산넘어: 뭐라시긴 뭘 뭐라셔요? 완전 대격노하셨지. 이우전: 대..대격노요?? 산넘어: 화딱지 제대로 나셨다고요. 발표날 조원들은 어디가고 왜 혼자서 발표하냐 하시길래 한 명은 남편이랑 결혼기념일이라고 지심도 가고 한 명은 다른 수업이 더 중요하다며 다른 수업 시험 대비하러 갔다하니까 즉석에서 가차없이 F때리시던데요?ᄏ 이거 어쩌나요 이우전님? 장학금 꼭 받으셔야 한다면서요?ᄏ 나영속: F면.. 점수 못 받는거 아니에요?;;; 산넘어: 재수강 하셔야죠ᄏ 근데 영속님은 막학기라면서요? 점수 부족해서 등록금 1학기 또 내고 다시 다녀야되는 거 아니에요?ᄏᄏᄏ 나영속: 저기 산조장님 제가 착각했네요..... 이번에 반드시 학점 받아서 즉시 이직해야 된단 말이에요;; 그래도 저희 같은 조인데 교수님께 말씀 좀 잘해주시면 안되겠나요?;;; 이우전: 조장님.. 저도 이번 장학금 반드시 타야돼요;; 못해도 D라도 받아야 되는데;; 조장님.. 자비 좀 베풀어 주세요..ᅲ 산넘어: 저한테 이러지 마시고 교수님 대면하고 애원하세요들ᄏ 교수님이 용서할 것 같진 않지만~ 누군 놀 줄 몰라서 빡세게 한 줄 아나ᅳᅳ 앞으로 다신 만나지 맙시다 수고요ᄏ FIN
07 데이터 정제 - 빠진 데이터, 이상한 데이터 제거하기 결측치 정제하기 결측치란? 누락된 값, 비어 있는 값 결측치 찾기 df <- data.frame(sex=c("M","F",NA, "M","F"), score=c(5,4,3,4,NA)) df is.na(df) table(is.na(df)) table(is.na(df$sex)) mean(df$score) 결측치 제거하기 library(dplyr) df %>% filter(is.na(score)) #score가 NA인 data만 출력 df %>% filter(!is.na(score)) #결측치를 제외하고 행을 추출 df_nomiss <- df %>% filter(!is.na(score) & !is.na(sex)) df_nomiss df_nomiss2 <- na.omit(df) df_nomiss2 여러 변수 동시에 결측치가 없는 데이터를 추출하는 코드 df_nomiss <- df %>% filter(!is.na(score) & !is.na(sex)) 함수의 결측치 제외 기능 이용하기 수치 연산 함수들은 결측치를 제외하고 연산하도록 설정하는 na.rm 파라미터를 지원한다. 결측치를 제외하고 평균 산출 mean(df$score, na.rm = T) 결측치 대체하기 결측치를 다른 값을 대체하면 데이터가 손실되어 분석 결과가 왜곡되는 문제를 보완할 수 있다. mean(exam$math, na.rm = T) ## 55.23529 math가 NA면 55로 대체 exam$math <- ifelse(is.na(exam$math),55,exam$math) mean(exam$math) ## 55.2 이상치 정제하기 이상치란? 정상 범주에서 크게 벗어난 값 존재할 수 없는 값 제거하기 outlier <- data.frame(sex = c(1,2,1,3,2,1), score = c(5,4,3,4,2,6)) table(outlier$sex) ## 1 2 3 3 2 1 1이 3개, 2가 2개, 3이 1개 있다 ~ sex가 3이면 NA 할당 outlier$sex <- ifelse(outlier$sex == 3, NA, outlier$sex) 이해 어려웠던 코드 filter를 이용해 결측치를 제외한 후 성별에 따른 score 평균 구하기 outlier %>% filter(!is.na(sex) & !is.na(score)) %>% group_by(sex) %>% summarise(mean_score = mean(score)) %>%는 앞의 데이터를 뒤의 함수에 전달하는 파이프 sex를 기준으로 그룹을 나눠라.. 1그룹, 2그룹 이렇게 극단적인 값 제거하기 어디까지 정상 범위로 볼 것인가? boxplot(mpg$hwy) 아래쪽 극단치 경계, 1사분위수, 중앙값, 3사분위수, 위쪽 극단치 경계 -> 12~37을 벗어나면 극단치로 분류된다 결측 처리하기 mpg$hwy <- ifelse(mpg$hwy < 12 | mpg$hwy > 37, NA, mpg$hwy) table(is.na(mpg$hwy)) 극단치가 결측 처리된 데이터를 얻고 분석 수행 mpg %>% group_by(drv) %>% summarise(mean_hwy = mean(hwy, na.rm = T)) mpg 데이터를 가지고 다음 작업을 해라 -> drv 기준으로 그룹을 나눠 NA가 있으면 제거하고 평균을 계산해라 08 그래프 만들기 산점도 - 변수 간 관계 표현하기 산점도란? 데이터를 x축과 y축에 점으로 표현한 그래프 ggplot2 레이어 구조 (배경 설정 -> 그래프 추가 -> 설정추가) 배경설정하기 ggplot(data=mpg, aes(x=displ, y=hwy)) #mpg 데이터의 displ 변수를 x축에, hwy 변수를 y축에 놓고 배경을 설정한다 그래프 추가하기 geom_point() ggplot(data=mpg, aes(x=displ, y=hwy)) + geom_point() 축 범위를 조정하는 설정 추가하기 xlim() ylim() ggplot(data=mpg, aes(x=displ, y=hwy)) + geom_point() + xlim(3,6) #x축 범위를 3~6까지만 표현되도록 설정 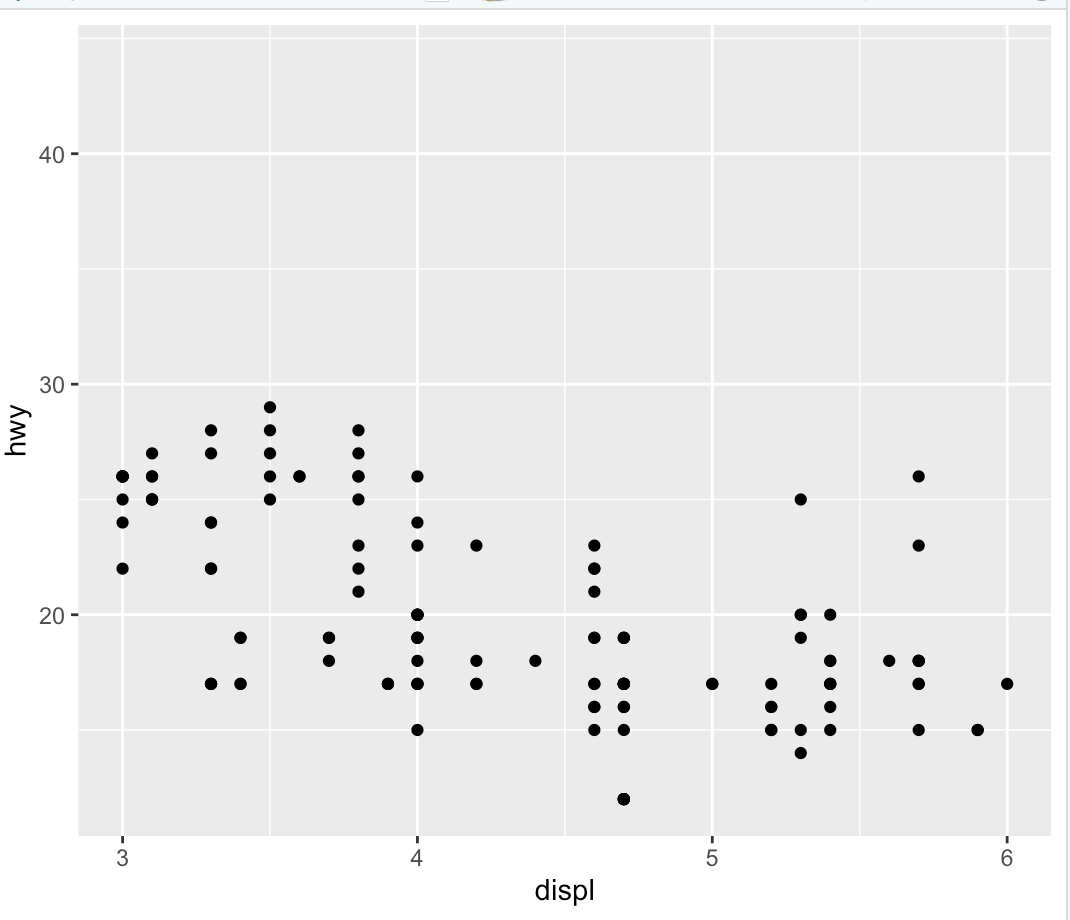 ### 막대 그래프 - 집단 간 차이 표현하기 #### 평균 막대 그래프 만들기 1. 집단별 평균표 만들기 library(dplyr) df_mpg <- mpg%>% group_by(drv) %>% summarise(mean_hwy = mean(hwy)) df_mpg 2. 그래프 생성하기 ggplot(data=df_mpg, aes(x=drv, y=mean_hwy)) +geom_col() 3. 크기 순으로 정렬하기 ggplot(data=df_mpg, aes(x=reorder(drv, -mean_hwy), y=mean_hwy)) +geom_col() 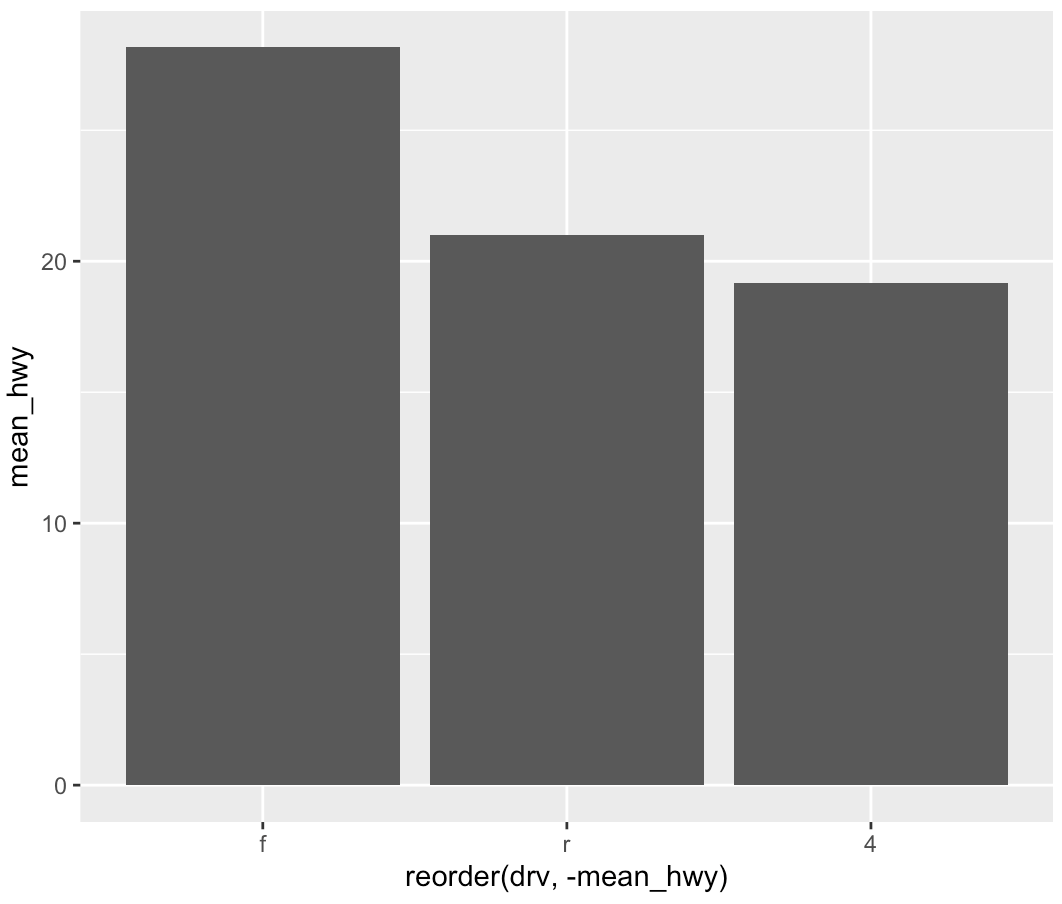 ### 선 그래프 - 시간에 따라 달라지는 데이터 표현하기 geom_line() 추가하기 ggplot(data=economics, aes(x=date, y=unemploy))+geom_line() > geom_col() 막대그래프 - 요약표 geom_bar() 막대그래프 - 원자료 geom_line() 선 그래프 geom_boxplot() 상자 그림
문제 소개 프로그래머스 Lv.1 · 예산 부서마다 물품 구매에 필요한 신청 금액이 배열 d 로 주어지고, 회사의 전체 예산은 budget 이다. 각 부서에는 신청한 금액을 전부 주거나 아예 주지 않아야 하며, 일부만 지원할 수는 없다. 예산 안에서 최대 몇 개 부서를 지원할 수 있는지 구하는 문제다. 부서 수는 최대 100개, 신청 금액은 최대 100,000, 예산은 최대 10,000,000이다. 접근 방법 지원하는 부서의 개수만 최대로 만들면 되므로, 금액이 작은 부서부터 지원하는 것이 가장 유리하다. 같은 예산이라면 적은 금액을 쓸수록 남는 돈으로 더 많은 부서를 지원할 수 있기 때문이다. d 를 오름차순으로 정렬한다. 앞에서부터 차례로 보면서, 신청 금액이 남은 예산 이하이면 예산에서 빼고 지원 개수를 1 늘린다. 끝까지 돈 뒤 개수를 반환한다. 정렬해 두었기 때문에 한 번 예산이 모자란 순간부터는 뒤에 있는 금액도 전부 모자란다. 그래서 조건이 처음 실패할 때 break 로 반복을 끝내도 결과는 같다. 풀이 코드 import java.util.Arrays; class Solution { public int solution(int[] d, int budget) { int answer = 0; Arrays.sort(d); for (int i = 0; i < d.length; i++) { if(d[i] <= budget) { budget -= d[i]; answer++; } } return answer; } } 시간 복잡도 O(n log n). 정렬에 O(n log n)이 들고, 이후 배열을 한 번 순회하는 데 O(n)이 든다. 배운 점 배열을 정렬해 두면 이 문제를 간단하게 풀 수 있다는 것을 알게 됐다. 작은 금액부터 차례로 고르기만 하면 되기 때문이다.
들어가며 LLM을 활용한 AI 에이전트 개발 입문」 수업 · 교재 『Do it! LLM을 활용한 AI 에이전트 개발 입문 5장~6장 실습 기록 이번 글은 5장과 6장을 묶어 정리합니다. 5장은 녹음 파일로 회의록을 만드는 AI 서기 , 6장은 이미지를 분석해 퀴즈와 듣기 문제를 만드는 AI 이미지 분석가 입니다. 5장은 소리를 글자로, 6장 마지막은 글자를 소리로 바꾸는 흐름이라 이어서 보면 재미있습니다. 일부 결과 화면은 교재 출력을 바탕으로 재구성했습니다. 전체 진행 순서 5장 AI 서기 openai_api_whisper.ipynb : 위스퍼 API로 음성 → 텍스트 huggingface_whisper.ipynb : 위스퍼 모델을 로컬에서 실행, 시간대별 문장을 CSV로 저장 speaker_diarization.ipynb : pyannote로 화자 분리 whisper_stt.py : 받아쓰기와 화자 분리를 합치는 파일 summarize_and_correct.ipynb : GPT로 요약·교정, 마크다운·워드 출력 6장 AI 이미지 분석가 image_explanation.ipynb : GPT 비전으로 이미지 설명, 한계 확인 image_quiz.py : 이미지 퀴즈와 영어 듣기 문제 출제 tts.ipynb : 영어 문제를 TTS로 MP3 만들기 project_agent_20260305/ ├── chap05/ │ ├── audio/ │ │ ├── lsy_audio_2023_58s.mp3 ← 1분짜리 강의 녹음 │ │ └── 싼기타_비싼기타.mp3 ← 두 사람의 토론 녹음 │ ├── openai_api_whisper.ipynb │ ├── huggingface_whisper.ipynb │ ├── speaker_diarization.ipynb │ ├── whisper_stt.py │ └── sec04/summarize_and_correct.ipynb ├── chap06/ │ ├── data/ ← 분석할 이미지, 퀴즈 결과 파일 │ ├── image_explanation.ipynb │ ├── image_quiz.py │ └── tts.ipynb └── venv/ 1. 위스퍼 API로 음성을 텍스트로 — openai_api_whisper.ipynb 실습 음성( lsy_audio_2023_58s.mp3 )은 교재 깃허브에서 받아 chap05/audio 에 넣었습니다. 이번 장부터는 셀 단위로 실행하고 결과를 바로 볼 수 있는 주피터 노트북 을 씁니다. VS Code에서 .ipynb 파일을 만들고 Select Kernel 에서 venv 를 고르면 되고, 처음 실행할 때 나오는 ipykernel 설치 안내는 [Install]을 누르면 됩니다. 클라이언트 준비 from openai import OpenAI from dotenv import load_dotenv import os load_dotenv() api_key = os.getenv('OPENAI_API_KEY') client = OpenAI(api_key=api_key) .env 의 API 키로 OpenAI 클라이언트를 만듭니다. 노트북은 실행한 셀의 변수가 남아 있어서, 한 번만 실행해 두면 아래 셀에서 client 를 계속 쓸 수 있습니다. MP3를 텍스트로 audio_file_path = './audio/lsy_audio_2023_58s.mp3' # MP3 파일 경로 입력 with open(audio_file_path, 'rb') as audio_file: transcription = client.audio.transcriptions.create( model="whisper-1", file=audio_file ) transcription 음성 파일은 바이너리라 'rb' 모드로 열고, client.audio.transcriptions.create() 에 whisper-1 모델과 파일을 넘기면 받아쓰기 결과가 옵니다. 결과가 한 줄로 길게 나와서 textwrap 으로 60자씩 줄바꿈해 출력하도록 바꿨습니다. from openai import OpenAI from dotenv import load_dotenv import os import textwrap load_dotenv() api_key = os.getenv("OPENAI_API_KEY") client = OpenAI(api_key=api_key) audio_file_path = './audio/lsy_audio_2023_58s.mp3' with open(audio_file_path, 'rb') as audio_file: transcript = client.audio.transcriptions.create( file=audio_file, model="whisper-1" ) # 결과 출력 # print(transcript.text) # 결과 출력 (문단 형태) text = transcript.text formatted_text = "\n\n".join( textwrap.fill(paragraph, width=60) for paragraph in text.split("\n\n") ) print(formatted_text) transcript.text 로 글자만 꺼내고, textwrap.fill(width=60) 으로 줄을 맞춥니다. 1분짜리 음성이 몇 초 만에 거의 정확한 문장으로 나왔습니다. 번역하며 받아쓰기 import textwrap # Open audio file and request transcription (translation to English) with open(audio_file_path, 'rb') as audio_file: transcription = client.audio.translations.create( file=audio_file, model="whisper-1" ) # Extract text from transcription result text = transcription.text # (Fixed: transcript → transcription) # Format text into paragraphs with max 60 characters per line formatted_text = "\n\n".join( textwrap.fill(paragraph, width=60) for paragraph in text.split("\n\n") ) # Print formatted result print(formatted_text) transcriptions 를 translations 로 바꾸면 한국어 음성이 영어 텍스트로 나옵니다. 주석의 (Fixed: ...) 는 변수 이름을 잘못 써서 NameError 가 났던 걸 고친 흔적입니다. 참고 translations 는 영어로 번역하는 것만 지원합니다. 2. 위스퍼를 로컬에서 실행 — huggingface_whisper.ipynb API는 쓸 때마다 요금이 나가서, 이번에는 허깅페이스에서 openai/whisper-large-v3-turbo 모델을 내려받아 내 컴퓨터에서 돌려 봅니다. 패키지 설치 %pip install --upgrade pip %pip install --upgrade transformers datasets[audio] accelerate %pip 은 노트북의 현재 커널(venv)에 설치하는 명령입니다. 모델 실행용 transformers , 오디오 처리용 datasets[audio] , 메모리 최적화용 accelerate 를 설치합니다. 이 상태로 예제를 실행하면 FFMPEG가 없다는 오류가 납니다. FFMPEG 경로 등록 https://www.gyan.dev/ffmpeg/builds 에서 ffmpeg-git-full.7z 를 받아 압축을 풀고, bin 폴더를 PATH에 추가합니다. import os os.environ["PATH"] += os.pathsep + r"C:\github\gpt_agent_2025_book\ffmpeg-2025-01-22-full_build\bin" 지금 커널에서만 유효해서 커널을 재시작하면 다시 실행해야 합니다. 경로는 본인이 압축을 푼 위치로 바꿔 주세요. 모델 실행 import torch from transformers import AutoModelForSpeechSeq2Seq, AutoProcessor, pipeline # from datasets import load_dataset device = "cuda:0" if torch.cuda.is_available() else "cpu" torch_dtype = torch.float16 if torch.cuda.is_available() else torch.float32 model_id = "openai/whisper-large-v3-turbo" model = AutoModelForSpeechSeq2Seq.from_pretrained( model_id, torch_dtype=torch_dtype, low_cpu_mem_usage=True, use_safetensors=True ) model.to(device) processor = AutoProcessor.from_pretrained(model_id) pipe = pipeline( "automatic-speech-recognition", model=model, tokenizer=processor.tokenizer, feature_extractor=processor.feature_extractor, torch_dtype=torch_dtype, device=device, return_timestamps=True, chunk_length_s=10, stride_length_s=2, ) # dataset = load_dataset("distil-whisper/librispeech_long", "clean", split="validation") # sample = dataset[0]["audio"] sample = "./audio/lsy_audio_2023_58s.mp3" result = pipe(sample) # print(result["text"]) print(result) 허깅페이스 예제에서 바꾼 부분은 파이프라인 옵션 세 개입니다. return_timestamps=True : 문장마다 시작·끝 시간을 함께 받습니다. 뒤에서 화자 분리와 맞출 때 필요합니다. chunk_length_s=10 : 음성을 10초씩 잘라 처리합니다. stride_length_s=2 : 조각이 2초씩 겹치게 해서 경계에서 단어가 잘리는 걸 줄입니다. GPU가 있으면 cuda , 없으면 cpu 로 돌아갑니다. 실행하니 이번에는 No module named 'torch' 오류가 나서, pytorch.org에서 안내하는 명령으로 파이토치를 설치했습니다. (venv) > pip3 install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu121 GPU가 없다면 사이트에서 CPU 를 골라 나오는 명령을 쓰면 됩니다. 설치 후 실행하면 전체 텍스트와 시간대별 조각( chunks )이 함께 나옵니다. chunks를 CSV로 저장 # chunks를 CSV 파일로 저장 start_end_text = [] for chunk in result["chunks"]: start = chunk["timestamp"][0] end = chunk["timestamp"][1] text = chunk["text"] start_end_text.append([start, end, text]) import pandas as pd df = pd.DataFrame(start_end_text, columns=["start", "end", "text"]) df.to_csv("lsy_audio_2023_58.csv", index=False, sep="|") display(df) 조각마다 [시작, 끝, 문장] 을 모아 데이터프레임으로 만들고 저장합니다. 문장에 쉼표가 들어갈 수 있어서 구분자는 | 를 썼습니다. 3. 화자 분리 — speaker_diarization.ipynb 받아쓰기만으로는 누가 말했는지 알 수 없어서, pyannote/speaker-diarization-3.1 모델로 화자를 나눕니다. 약관 동의가 필요한 모델이라 허깅페이스에서 액세스 토큰 을 만들고 모델 페이지에서 동의해야 합니다. 설치 %pip install pyannote.audio %pip install numpy==1.26 pyannote가 numpy 2.x와 맞지 않아서 numpy==1.26 으로 고정했습니다. 파이프라인 불러오기 # instantiate the pipeline from pyannote.audio import Pipeline pipeline = Pipeline.from_pretrained( "pyannote/speaker-diarization-3.1", use_auth_token="HUGGINGFACE_ACCESS_TOKEN_GOES_HERE" ) # CUDA를 사용할 수 있다면 CUDA를 사용하도록 설정 if torch.cuda.is_available(): pipeline.to(torch.device("cuda")) print('cuda is available') else: print('cuda is not available') use_auth_token 에 발급한 토큰을 넣습니다. 이 셀은 torch 를 쓰는데 import가 없으니, 새로 시작했다면 import torch 를 먼저 해 주세요. 실행하니 아래 오류가 났습니다. Could not download 'pyannote/segmentation-3.0' model. It might be because the model is private or gated so make sure to authenticate. ... AttributeError: 'NoneType' object has no attribute 'eval' 3.1 모델이 내부에서 쓰는 pyannote/segmentation-3.0 모델에도 따로 동의해야 했습니다. 해당 페이지에서 [Agree and access repository]를 누르면 해결됩니다. 주의 토큰은 비밀번호와 같아서, 깃허브에 올릴 때는 .env 로 빼 두는 게 안전합니다. 화자 분리 실행 # run the pipeline on an audio file diarization = pipeline("./audio/싼기타_비싼기타.mp3") # dump the diarization output to disk using RTTM format with open("./audio/싼기타_비싼기타.rttm", "w", encoding='utf-8') as rttm: diarization.write_rttm(rttm) 토론 음성 싼기타_비싼기타.mp3 로 실행하고 결과를 RTTM 파일로 저장합니다. 한 줄은 "몇 초부터 몇 초 동안 누가 말했는지"입니다. 네 번째 값이 시작 시간, 다섯 번째 값이 길이 입니다. 판다스로 정리 import pandas as pd rttm_path = "./audio/싼기타_비싼기타.rttm" df_rttm = pd.read_csv( rttm_path, # rttm 파일 경로 sep=' ', # 구분자는 띄어쓰기 header=None, # 헤더는 없음 names=['type', 'file', 'chnl', 'start', 'duration', 'C1', 'C2', 'speaker_id', 'C3', 'C4'] ) display(df_rttm) 띄어쓰기로 구분된 RTTM을 읽고, 열 이름을 직접 붙였습니다. # start + duration을 end로 변환 df_rttm['end'] = df_rttm['start'] + df_rttm['duration'] display(df_rttm) 끝 시간이 없으니 시작 + 길이로 만듭니다. df_rttm["number"] = None # number 열 만들고 None으로 초기화 df_rttm.at[0, "number"] = 0 display(df_rttm) for i in range(1, len(df_rttm)): if df_rttm.at[i, "speaker_id"] != df_rttm.at[i-1, "speaker_id"]: df_rttm.at[i, "number"] = df_rttm.at[i-1, "number"] + 1 else: df_rttm.at[i, "number"] = df_rttm.at[i-1, "number"] display(df_rttm.head(10)) 같은 사람이 이어서 말한 줄은 같은 번호, 화자가 바뀌면 번호를 1 올립니다. 숨 쉬는 틈마다 쪼개진 줄을 발언 차례 단위로 묶기 위한 준비입니다. df_rttm_grouped = df_rttm.groupby("number").agg( start=pd.NamedAgg(column='start', aggfunc='min'), end=pd.NamedAgg(column='end', aggfunc='max'), speaker_id=pd.NamedAgg(column='speaker_id', aggfunc='first') ) display(df_rttm_grouped) 번호별로 묶어서 시작은 최솟값, 끝은 최댓값, 화자는 첫 값을 씁니다. df_rttm_grouped["duration"] = df_rttm_grouped["end"] - df_rttm_grouped["start"] df_rttm_grouped = df_rttm_grouped.reset_index(drop=True) display(df_rttm_grouped) df_rttm_grouped.to_csv( "./audio/싼기타_비싼기타_rttm.csv", sep=',', index=False ) 발화 시간을 다시 계산하고 인덱스를 정리해 CSV로 저장합니다. 4. 받아쓰기 + 화자 분리 합치기 — whisper_stt.py 노트북에서 확인한 기능을 함수로 묶은 최종 파일입니다. 전체 코드 import os import torch import pandas as pd from transformers import AutoModelForSpeechSeq2Seq, AutoProcessor, pipeline from pyannote.audio import Pipeline os.environ["PATH"] += os.pathsep + r"C:\github\gpt_agent_2025_book\ffmpeg-2025-01-22-full_build\bin" # 자신이 설치한 위치로 경로 수정 def whisper_stt( audio_file_path: str, output_file_path: str = "./output.csv" ): device = "cuda:0" if torch.cuda.is_available() else "cpu" torch_dtype = torch.float16 if torch.cuda.is_available() else torch.float32 model_id = "openai/whisper-large-v3-turbo" model = AutoModelForSpeechSeq2Seq.from_pretrained( model_id, torch_dtype=torch_dtype, low_cpu_mem_usage=True, use_safetensors=True ) model.to(device) processor = AutoProcessor.from_pretrained(model_id) pipe = pipeline( "automatic-speech-recognition", model=model, tokenizer=processor.tokenizer, feature_extractor=processor.feature_extractor, torch_dtype=torch_dtype, device=device, return_timestamps=True, # 청크별로 타임스탬프를 반환 chunk_length_s=10, # 입력 오디오를 10초씩 나누기 stride_length_s=2, # 청크가 2초씩 겹치도록 나누기 ) result = pipe(audio_file_path) df = whisper_to_dataframe(result, output_file_path) return result, df def whisper_to_dataframe(result, output_file_path): s
Buy Instagram Accounts With Real Followers Safely Seeking to grow your online presence on Instagram but struggling to attract a substantial following? In today's dynamic digital landscape, the competition for attention is fierce, making it challenging to stand out amidst the crowd. Fear not, as this article delves into the realm of purchasing Instagram accounts with real followers safely, offering you a strategic solution to bolster your social media influence. Embark on a journey that will equip you with the knowledge and tools needed to navigate the process of acquiring authentic Instagram accounts seamlessly. Discover invaluable insights on how to identify trustworthy sellers, ensure genuine followers, and effectively leverage your newfound platform for maximum impact. Elevate your social media game and unlock the potential for exponential growth – let's embark on this transformative adventure together! If you want to more information just contact now. 24 Hours Reply/Contact ✅Telegram: @smmusareview ✅WhatsApp: +44 7478079809 ✅E-mail: smmusareview24h@gmail.com ✅Website: https://smmusareview.com/product/buy-instagram-accounts/ Why Buy Instagram Accounts? Buying Instagram accounts with real followers can provide a valuable head start in establishing a strong online presence. It saves time and effort that would be spent on building a following from scratch, allowing individuals and businesses to dive straight into engaging with their audience and showcasing their content. Furthermore, purchasing an account with an existing follower base can offer instant credibility and social proof. This can attract new followers organically, as people are more likely to follow an account that already has a significant following. Ultimately, buying Instagram accounts can jumpstart your journey towards success on the platform. How to Find Trustworthy Sellers When looking for trustworthy sellers to buy Instagram accounts with real followers, it is crucial to do thorough research. Start by checking reviews and testimonials from other buyers to gauge the seller's reputation. Look for sellers who have a proven track record of delivering authentic accounts that meet your specific criteria. Additionally, consider reaching out to the seller directly to ask questions about their process and how they ensure the authenticity of their accounts. A reliable seller will be transparent about their methods and provide you with confidence in your purchase. By taking these steps, you can find a trustworthy seller who will help you acquire an Instagram account with real followers safely and securely. Ensuring Real Followers When purchasing an Instagram account with real followers, it is crucial to verify the authenticity of the audience. Look for engagement metrics such as likes, comments, and shares to ensure that the followers are active and genuinely interested in the content. Avoid accounts with suspiciously high follower counts but low engagement, as they may be filled with fake or inactive profiles. One effective way to ensure real followers is to request a detailed analytics report from the seller. This report should include demographic information, engagement rates, and growth trends over time. By thoroughly examining these metrics, you can validate the quality of the followers and make an informed decision about the account's authenticity. Safely Completing the Purchase When it comes to completing the purchase of an Instagram account, it is crucial to prioritize safety and security. Look for sellers who offer secure payment methods, such as escrow services, to protect both buyer and seller in the transaction. Ensure that all terms and conditions are clearly outlined and agreed upon before finalizing the purchase. Additionally, always verify the authenticity of the account and its followers before making any payments. Request insights or analytics data to confirm the engagement rate and demographics of the followers. By taking these precautions, you can safely complete your purchase and confidently move forward with growing your Instagram presence. What to Look for in an Account When considering buying an Instagram account with real followers, it's crucial to examine the account's engagement rate. Look for accounts with active followers who regularly like, comment, and share content. Authentic engagement is a key indicator of a genuine following and can ensure the success of your future posts. Additionally, pay attention to the account's niche relevance. A targeted audience that aligns with your brand or content is more likely to result in meaningful connections and interactions. Verify that the account's followers are genuinely interested in the content being shared, as this will lead to higher engagement rates and organic growth over time. Tips for Growing Your Followers Creating engaging content is vital to attracting and retaining followers on Instagram. Post high-quality photos and videos that resonate with your target audience. Use relevant hashtags to increase visibility, and interact with your followers by responding to comments and messages. Collaborating with other accounts in your niche can help expose your profile to a wider audience. Host giveaways or contests to encourage user engagement and attract new followers. Consistency is key, so establish a posting schedule that keeps your content fresh and ensures steady growth of your follower base. Avoiding Common Pitfalls When purchasing Instagram accounts, it's crucial to avoid common pitfalls that could lead to wasted money and disappointment. One common pitfall is falling for inflated follower numbers without considering their authenticity. Always verify the engagement rate of the followers to ensure they are real and active. Another pitfall to watch out for is neglecting to check for account history and previous ownership. Buying an account with a questionable past could result in penalties from Instagram or a decline in credibility with your new audience. Stay vigilant and thoroughly research the account's background before making a purchase. Leveraging Your New Account Now that you have acquired an Instagram account with genuine followers, it's time to leverage this newfound asset to its full potential. Start by crafting engaging and visually appealing content that resonates with your audience. Consistency is key - post regularly and utilize relevant hashtags to increase visibility. Engage with your followers by responding to comments, hosting interactive Q&A sessions, and running exciting giveaways. Collaborate with influencers in your niche to further expand your reach and credibility. Remember, building a successful online presence takes time and effort, but with dedication and strategic planning, the possibilities for growth are limitless. Conclusion As we wrap up our discussion on buying Instagram accounts with real followers safely, it is essential to remember that building a strong and engaged audience takes time and effort. By carefully selecting a reputable seller, verifying the authenticity of the followers, and taking proactive steps to grow your account organically, you can set yourself up for success in the competitive world of social media marketing. Remember, authenticity and quality engagement will always prevail over shortcuts and quick fixes.
Hyderabad isn't just a city of minarets, biryani, and bustling tech parks. Beneath its modern skyline lies a quieter, centuries-old tradition of healing that predates the IT boom by hundreds of years. The city has long been a refuge for traditional systems of medicine, and among them, Unani medicine has carved a particularly distinct niche. But what makes this ancient system so enduring, especially in a city like Hyderabad? And how does a modern Unani Clinic in Hyderabad like Dr. Rahman Unani Clinic fit into a healthcare landscape dominated by quick fixes and over-the-counter solutions? The answers lie in a philosophy of wellness that treats the person, not just the symptom—and a local legacy of practitioners who have kept that flame alive. A Market Moving Toward Holistic Health To understand why Unani medicine is experiencing a quiet resurgence, it helps to look at the numbers. The broader AYUSH sector in India (Ayurveda, Yoga, Unani, Siddha, and Homeopathy) is not a fringe movement anymore; it is a rapidly expanding industry. Market forecasts project the Indian AYUSH and alternative medicine sector to grow from $24.87 billion in 2025 to $36.62 billion by 2031, representing a steady CAGR of 6.66% . This growth isn't arbitrary. It reflects a fundamental shift in consumer behavior. Elevated income levels, combined with a heightened awareness of preventive health, are driving demand for more personalized and natural approaches to wellness . People are increasingly seeking healthcare that addresses chronic conditions, stress management, and immunity—areas where traditional systems like Unani have historically excelled. What makes this trend particularly relevant to Hyderabad is that Unani medicine, while niche, leverages concentrated regional loyalty and is uniquely positioned to benefit from modern accessibility platforms like teleconsultation, which help it transcend geographic confines . In other words, the audience for traditional healing is not shrinking. It is evolving. What Makes Unani Different: A Framework of Balance For those unfamiliar with the system, Unani medicine can seem deceptively simple. It is often reduced to "herbal remedies," but that description barely scratches the surface. Originating from Greece and refined by Arab and Persian scholars, Unani is a comprehensive medical system built on the Hippocratic theory of the four humors: blood, phlegm, yellow bile, and black bile . Health, in this framework, is the result of a harmonious balance between these humors. Disease emerges when that balance is disturbed by factors ranging from diet and environment to emotional stress. What this means in practice is that Unani practitioners do not simply prescribe a generic remedy for a headache or a skin condition. They assess the patient's individual temperament (Mizaj), lifestyle, and underlying imbalances before determining a course of treatment. The system incorporates dietary therapy, regimenal therapy (Ilaj bit-Tadbeer), pharmacotherapy, and in some cases, surgery . This holistic framework is not a marketing gimmick. It is the foundational logic of a system that has been clinically studied and refined over centuries. The Central Council for Research in Unani Medicine (CCRUM), a government body, continues to conduct rigorous clinical trials on Unani formulations for conditions ranging from bronchial asthma to osteoarthritis, validating the system's therapeutic potential through modern scientific methods . Why Hyderabad Has Always Been a Unani Stronghold Hyderabad's connection to Unani medicine is not incidental. During the British colonial period, when Unani medicine suffered a significant setback across much of India, it survived largely due to the patronage of the Nizam of Hyderabad and a handful of prominent families . That legacy persists. The city is home to the National Research Institute of Unani Medicine for Skin Disorders (NRIUMSD), a premier institution that has earned national acclaim for its effective treatment of conditions including vitiligo, psoriasis, eczema, and rheumatoid arthritis . This is not a small achievement; it reflects decades of institutional research and a deep pool of local expertise. For residents of Hyderabad, this means access to a level of Unani care that is genuinely difficult to replicate elsewhere. The city's practitioners are inheritors of a tradition that has been continuously practiced, taught, and scientifically documented for generations. What Comprehensive Care Looks Like at Dr. Rahman Unani Clinic This is where the conversation moves from history and market trends to the practical reality of what a patient can expect. At Dr. Rahman Unani Clinic, comprehensive care is not a slogan; it is a structured approach that addresses the full scope of a patient's health. Personalized Temperament Assessment Every patient begins with a detailed evaluation. The practitioner assesses the patient's Mizaj (temperament), medical history, and current imbalances. This is not a five-minute consultation designed to rush to a prescription. It is a diagnostic process that treats the patient as an individual rather than a case file. Treatment Rooted in Pharmacopoeial Standards Unani drugs are regulated under the Drugs and Cosmetics Act, 1940, and must comply with Good Manufacturing Practices and quality standards set by the Pharmacopoeia Commission for Indian Medicine & Homoeopathy . At Dr. Rahman Unani Clinic, this regulatory framework is not an afterthought; it is a baseline. Patients receive formulations that are prepared according to established standards, with transparency about ingredients and expected outcomes. Management of Chronic and Lifestyle Conditions The clinic's focus extends to conditions where conventional medicine often offers only symptomatic relief: chronic skin disorders, digestive issues, joint pain, respiratory conditions, and stress-related ailments. The Unani approach here is not about quick suppression of symptoms but about addressing the underlying humoral imbalance that gives rise to them. Integrative, Not Isolated One of the most persistent misconceptions about traditional medicine is that it operates in opposition to modern healthcare. The reality, especially in a city like Hyderabad, is more nuanced. Unani practitioners increasingly encourage the use of modern diagnostic equipment and collaborate with allopathic physicians when necessary . Comprehensive care means knowing the boundaries of one's system and referring appropriately. A Comparison: Unani and Conventional Approaches Aspect Unani Approach Conventional Approach Diagnostic Focus Temperament (Mizaj), humor balance, lifestyle factors Symptoms, lab results, imaging Treatment Goal Restore balance; radical cure where possible Manage symptoms; suppress pathology Time Horizon Longer consultation; gradual, sustained improvement Rapid intervention; immediate relief Patient Role Active participant in diet, regimen, and lifestyle changes Often passive recipient of prescriptions Chronic Conditions Emphasis on root causes and constitution Emphasis on management and medication This comparison is not meant to declare one system superior. It is meant to clarify that Unani offers a different entry point into health—one that many patients find more aligned with their understanding of wellness. What to Expect on Your First Visit If you are considering visiting a Unani Clinic in Hyderabad for the first time, here is what a thorough consultation typically involves: • Detailed History: Expect questions not just about your current symptoms but about your sleep, digestion, stress levels, and dietary habits. • Pulse and Physical Examination: Traditional diagnostic methods are used alongside modern assessments. • Personalized Prescription: You may receive herbal formulations, dietary recommendations, and regimenal advice tailored to your specific imbalance. • Follow-Up Structure: Unani treatment is rarely a one-visit affair. Improvement is tracked over time, and the treatment plan is adjusted accordingly. Conclusion: Wellness That Respects Both Tradition and Science The resurgence of Unani medicine is not nostalgia. It is a response to a genuine gap in modern healthcare—a gap that favors quick fixes over sustainable wellness, and standardization over personalization. Dr. Rahman Unani Clinic operates at the intersection of these two worlds. It honors a medical tradition that has served Hyderabad for centuries while adhering to the regulatory and quality standards that modern patients rightly expect. Whether you are seeking relief from a chronic condition that has resisted other treatments or simply looking for a more holistic approach to your health, the clinic offers a path that is both grounded and forward-looking.
컴퓨터 구조 12 — I/O(Input/Output)란 무엇인가 ※ 업로드한 Chapter 5에서는 I/O 시스템, Interrupt, DMA 등을 별도의 주제로 다루지 않는다. 자료에서 Input/Output은 FPGA의 IOE(Input/Output Element) 가 외부와 연결되는 요소라는 정도로만 등장한다. 따라서 이번 글은 지금까지 공부한 CPU, Memory, Bus와 연결하기 위해 일반적인 컴퓨터 구조의 I/O 기본 이론 을 기준으로 정리한다. 1. I/O란? 지금까지 컴퓨터 내부의 핵심 구조를 공부했다. CPU ↕ Memory 그리고 이 구성요소들이 Bus 를 통해 정보를 주고받는다고 배웠다. 하지만 컴퓨터는 CPU와 Memory만으로 구성되지 않는다. 컴퓨터는 외부에서 데이터를 받아들이고 결과를 외부로 내보내야 한다. 이러한 동작을 I/O(Input/Output, 입출력) 라고 한다. Input → 외부에서 컴퓨터로 Data가 들어옴 Output → 컴퓨터에서 외부로 Data가 나감 전체적으로 보면 다음과 같다. 외부 ↕ I/O ↕ Computer 2. I/O는 왜 필요한가? CPU는 데이터를 처리할 수 있고 Memory는 데이터를 저장할 수 있다. 하지만 외부와 정보를 주고받을 방법이 없다면 컴퓨터가 처리할 데이터를 받아오거나 처리 결과를 전달할 수 없다. 따라서 컴퓨터에는 외부 장치와 통신하기 위한 구조가 필요하다. 외부 장치 ↓ Input ↓ Computer ↓ Processing ↓ Output ↓ 외부 장치 I/O는 컴퓨터 내부와 외부를 연결하는 역할을 한다. 3. Input과 Output I/O는 크게 두 방향으로 나눌 수 있다. I/O ├── Input └── Output Input Input(입력) 은 외부의 정보가 컴퓨터 내부로 들어오는 것이다. 외부 ↓ Data ↓ Computer Output Output(출력) 은 컴퓨터가 처리한 정보가 외부로 전달되는 것이다. Computer ↓ Data ↓ 외부 따라서 I/O의 핵심은 데이터가 컴퓨터 내부와 외부 사이를 이동하는 것 이다. 4. I/O Device 컴퓨터와 데이터를 주고받는 장치를 I/O Device(입출력 장치) 라고 한다. 전체 구조는 다음과 같이 볼 수 있다. Computer │ ├── CPU ├── Memory └── I/O Device I/O Device는 종류와 동작 방식이 매우 다양하다. 중요한 것은 각각의 장치를 외우는 것이 아니라 다음 관계를 이해하는 것이다. CPU / Memory ↕ I/O System ↕ 외부 장치 즉 I/O Device는 컴퓨터가 외부와 정보를 주고받을 수 있도록 한다. 5. CPU가 I/O 장치를 직접 제어할까? CPU와 I/O Device는 동작 특성이 다르다. CPU → 매우 빠르게 명령어 처리 I/O Device → 장치마다 동작 방식과 속도가 다름 따라서 CPU가 각 장치의 세부적인 동작을 모두 직접 처리하는 방식은 비효율적이다. 그래서 일반적으로 CPU와 실제 I/O Device 사이에 장치를 관리하는 하드웨어가 존재한다. 이를 I/O Controller(입출력 제어기) 라고 한다. CPU ↕ I/O Controller ↕ I/O Device 6. I/O Controller I/O Controller 는 CPU와 I/O Device 사이에서 통신을 관리하는 장치이다. 기본적인 역할은 다음과 같다. CPU ↓ I/O 명령 ↓ I/O Controller ↓ 실제 Device 제어 반대로 장치에서 들어온 데이터도 Controller를 통해 CPU나 Memory 쪽으로 전달될 수 있다. I/O Device ↓ I/O Controller ↓ CPU / Memory 따라서 I/O Controller는 CPU ↕ I/O Device 사이의 중간 연결 역할을 한다. 7. CPU, Memory, I/O의 연결 앞에서 Bus를 공부하면서 다음 세 가지를 배웠다. Data Bus Address Bus Control Bus I/O 역시 컴퓨터 시스템의 통신 구조를 통해 CPU 및 Memory와 연결된다. 큰 그림을 보면 다음과 같다. CPU ↕ Bus ↙ ↘ Memory I/O Controller ↕ I/O Device 따라서 Bus는 단순히 CPU와 Memory만 연결하는 것이 아니라 시스템의 여러 구성요소가 통신할 수 있도록 한다. 8. CPU는 I/O의 완료를 어떻게 알까? CPU가 I/O 작업을 요청했다고 생각해보자. CPU ↓ I/O 작업 요청 ↓ I/O Device 작업 문제는 I/O Device가 CPU보다 느릴 수 있다는 것이다. CPU가 장치의 작업이 끝날 때까지 계속 기다리면 CPU 시간을 효율적으로 사용하기 어렵다. 이 문제를 처리하는 대표적인 방식에는 다음과 같은 것들이 있다. I/O 처리 방식 ├── Programmed I/O ├── Interrupt └── DMA 현재 단계에서는 각각의 기본 원리만 이해하면 된다. 9. Programmed I/O Programmed I/O 는 CPU가 I/O 장치의 상태를 직접 확인하면서 작업을 처리하는 방식이다. 쉽게 표현하면 다음과 같다. CPU ↓ I/O 작업 요청 ↓ 장치 상태 확인 ↓ 아직 완료되지 않음 ↓ 다시 확인 ↓ ... ↓ 작업 완료 CPU가 장치의 상태를 반복해서 확인하는 방식을 Polling(폴링) 이라고 한다. Polling → CPU가 장치 상태를 반복해서 확인 구조가 단순하지만 문제가 있다. CPU ↓ 계속 상태 확인 ↓ 기다리는 데 CPU 시간 사용 즉 CPU가 다른 작업을 수행할 수 있는 시간을 I/O 장치를 기다리는 데 사용할 수 있다. 10. Interrupt 이 문제를 줄일 수 있는 중요한 개념이 Interrupt(인터럽트) 이다. Interrupt 방식에서는 CPU가 장치의 상태를 계속 확인하지 않는다. CPU ↓ I/O 작업 요청 ↓ CPU는 다른 작업 수행 I/O 작업이 끝나거나 CPU의 처리가 필요한 상황이 발생하면 장치 측에서 CPU에게 신호를 보낸다. I/O Device ↓ 작업 완료 ↓ Interrupt 발생 ↓ CPU 즉 Interrupt는 CPU야, 처리해야 할 일이 생겼어. 라는 것을 알려주는 신호라고 이해하면 된다. 11. Polling과 Interrupt의 차이 둘의 가장 중요한 차이는 누가 상태를 확인하느냐 이다. 방식 기본 원리 Polling CPU가 장치 상태를 계속 확인 Interrupt 장치가 필요할 때 CPU에게 알림 흐름으로 비교하면 다음과 같다. Polling CPU ↓ 완료됐나? ↓ 아니오 ↓ 다시 확인 ↓ 완료됐나? Interrupt CPU ↓ I/O 요청 ↓ 다른 작업 수행 I/O Device ↓ 작업 완료 ↓ Interrupt ↓ CPU 따라서 Interrupt를 사용하면 CPU가 장치 상태만 계속 확인할 필요가 줄어든다. 12. Interrupt가 발생하면? Interrupt가 발생하면 CPU는 현재 실행 흐름에서 I/O와 관련된 처리를 해야 한다. 개념적으로 보면 다음과 같다. CPU ↓ 현재 프로그램 실행 ↓ Interrupt 발생 ↓ 현재 실행 상태 보존 ↓ Interrupt 처리 ↓ 원래 실행하던 작업으로 복귀 현재 단계에서는 Interrupt 처리의 세부적인 레지스터나 운영체제 동작까지 들어갈 필요는 없다. 핵심은 다음과 같다. Interrupt → 외부 또는 내부 사건이 발생했음을 CPU에게 알림 13. DMA가 필요한 이유 I/O 장치와 Memory 사이에서 많은 양의 데이터를 이동한다고 생각해보자. CPU가 모든 데이터를 하나씩 직접 옮긴다면 CPU가 데이터 이동에 계속 관여해야 한다. I/O Device ↓ CPU ↓ Memory 이렇게 되면 CPU가 실제 명령어 처리보다 데이터 이동 작업에 많은 시간을 사용할 수 있다. 이를 줄이기 위한 방식이 DMA(Direct Memory Access) 이다. 14. DMA란? DMA(Direct Memory Access) 는 I/O 장치와 Memory 사이의 데이터 전송에서 CPU의 지속적인 개입을 줄이는 방식이다. 기본적인 구조를 보면 다음과 같다. CPU ↓ DMA 작업 설정 I/O Device ↔ DMA Controller ↔ Memory 즉 데이터 전송이 이루어지는 동안 CPU가 모든 데이터 이동을 직접 처리할 필요가 없다. CPU → 전송에 필요한 정보 설정 DMA → 실제 데이터 전송 담당 그리고 전송이 끝나면 CPU에게 완료 사실을 알릴 수 있다. DMA 작업 완료 ↓ Interrupt ↓ CPU 15. Programmed I/O와 DMA의 차이 개념적으로 비교하면 다음과 같다. Programmed I/O I/O Device ↕ CPU ↕ Memory CPU가 데이터 이동 과정에 적극적으로 관여한다. 반면 DMA는 다음과 같다. CPU ↓ 전송 설정 I/O Device ↔ DMA ↔ Memory CPU가 데이터 하나하나를 직접 이동시키는 부담을 줄일 수 있다. 16. 세 가지 I/O 처리 방식을 연결하면 I/O를 처리하는 기본적인 발전 방향을 개념적으로 보면 다음과 같이 이해할 수 있다. Programmed I/O ↓ CPU가 장치를 직접 확인하고 처리 Interrupt ↓ 장치가 필요할 때 CPU에게 알림 DMA ↓ 대량 데이터 이동에서 CPU 개입 감소 현재는 어떤 방식이 무조건 가장 좋다고 외우는 것이 아니라 각각 CPU가 얼마나 직접 관여하는가 를 이해하면 된다. 17. Interrupt와 DMA의 관계 Interrupt와 DMA는 서로 완전히 별개의 개념으로만 볼 필요는 없다. DMA를 통해 데이터 전송이 이루어진 뒤 완료 사실을 Interrupt로 CPU에게 알릴 수 있다. CPU ↓ DMA 전송 설정 ↓ DMA가 Data 이동 ↓ 전송 완료 ↓ Interrupt ↓ CPU 이렇게 여러 하드웨어 기능이 함께 동작할 수 있다. 18. I/O와 Memory의 관계 I/O를 통해 들어온 데이터는 결국 CPU가 처리하거나 Memory에 저장할 수 있다. I/O Device ↓ I/O Controller ↓ Memory ↓ CPU 반대로 Memory에 있는 데이터를 외부 장치로 보낼 수도 있다. CPU / Memory ↓ I/O Controller ↓ I/O Device 따라서 I/O는 CPU만의 개념이 아니라 Memory와도 밀접하게 연결된다. 19. 지금까지 배운 컴퓨터 전체 구조 이제 처음에 배웠던 컴퓨터의 기본 구성요소를 훨씬 구체적으로 연결할 수 있다. Computer CPU ┌──────────┼──────────┐ │ │ │ Control Unit Register ALU │ ↓ Bus ┌────┴─────┐ ↓ ↓ Memory I/O Controller ↓ I/O Device Memory 쪽에는 지금까지 배운 계층 구조가 존재한다. CPU ↓ Register ↓ Cache ↓ Main Memory ↓ Storage 그리고 외부와의 통신은 다음과 같이 연결된다. CPU / Memory ↓ Bus ↓ I/O Controller ↓ I/O Device ↓ External World 반드시 기억할 것 I/O(Input/Output) 는 컴퓨터와 외부 사이에서 데이터를 주고받는 것이다. Input → 외부에서 Computer로 Data Output → Computer에서 외부로 Data CPU와 I/O Device 사이에는 일반적으로 I/O Controller가 존재한다. CPU ↕ I/O Controller ↕ I/O Device I/O 처리의 대표적인 개념은 다음과 같다. Programmed I/O → CPU가 장치 상태를 직접 확인 Interrupt → 장치가 필요할 때 CPU에게 알림 DMA → I/O와 Memory 사이의 Data 전송에서 CPU 개입 감소 Polling과 Interrupt의 차이도 중요하다. Polling → CPU가 계속 확인 Interrupt → 장치가 CPU에게 알림 DMA의 핵심은 다음과 같다. CPU → 전송 설정 DMA → 실제 Data 전송 전송 완료 ↓ CPU에 알림 전체 구조는 다음과 같이 연결된다. CPU ↕ Bus ↙ ↘ Memory I/O Controller ↕ I/O Device 현재 단계에서 가장 중요한 것은 다음 한 줄이다. I/O는 컴퓨터가 외부 장치와 데이터를 주고받는 구조이며, Interrupt와 DMA 등을 이용해 CPU의 I/O 처리 부담을 줄일 수 있다. 다음 공부 다음에는 컴퓨터 구조 13 — Pipelining(파이프라이닝)이란 무엇인가 를 공부한다. 지금까지는 CPU가 명령어 하나를 다음 과정으로 처리한다고 배웠다. Fetch ↓ Decode ↓ Execute 다음부터는 CPU가 여러 명령어의 처리 단계를 겹쳐서 진행하여 처리량을 높이는 방법 을 공부한다. 다음 내용: Pipelining이란 무엇인가 ↓ 왜 Pipelining이 필요한가 ↓ Instruction을 단계로 나누는 이유 ↓ 여러 Instruction을 겹쳐 처리 ↓ Latency와 Throughput ↓ Pipeline Stage ↓ Pipeline이 성능을 높이는 원리 Pipelining을 공부한 뒤에는 이어서 Hazard 를 공부한다. 13. Pipelining ↓ 14. Hazard ↓ 15. 병렬 처리 기초
들어가며: 교수님의 한마디에서 시작된 질문 자료구조 수업에서 교수님이 이런 말씀을 하셨다. "C언어는 배열의 의미를 제대로 보여주지만, 파이썬 같은 언어에서는 그 의미가 퇴색됐다." 처음엔 무슨 뜻인지 와닿지 않았다. 파이썬 리스트도 인덱스로 접근하고, 순서도 있고, 배열이라고 부르지 않나? 이 질문을 파고들다 보니 배열 하나에서 시작해 타입이 메모리에 어떻게 놓이는지, 메모리는 누가 언제 해제하는지, 컴파일러는 무엇을 하는지, 그리고 C·파이썬·Rust가 각각 어떤 선택을 했는지까지 전부 연결되어 있다는 걸 알게 됐다. 이 글은 그 흐름을 처음부터 끝까지 정리한 기록이다. 배열의 진짜 의미: 연속 메모리와 주소 산술 자료구조에서 배열(array)은 "여러 값을 순서대로 담는 통"이 아니라, 아주 구체적인 메모리 구조를 가리키는 말이다. 세 가지 조건으로 정의된다. 같은 타입 의 원소들이 메모리에 연속적으로(contiguous) 붙어서 놓이고 그래서 i번째 원소의 주소를 계산으로 바로 구할 수 있다 $$ \text{주소}(i) = \text{시작주소} + i \times \text{원소크기} $$ 3번이 배열의 존재 이유다. 1000만 개짜리 배열에서 7,342,118번째 원소를 꺼낼 때, 앞에서부터 세지 않고 곱셈 한 번 덧셈 한 번으로 그 자리로 점프한다. 이것이 "인덱스 접근이 O(1)"이라는 말의 실제 내용이다. 여기서 중요한 건 공식이 성립하려면 원소 하나의 크기가 고정 되어 있어야 한다는 점이다. 값은 바뀌어도 되지만, 각 칸이 차지하는 바이트 수는 같아야 한다. 크기가 제각각이면 곱셈으로 위치를 구할 수 없다. C 배열: 주소 산술 그 자체 C 배열은 위 정의를 숨기지 않고 그대로 드러낸다. int a[5] = {10, 20, 30, 40, 50}; 메모리에 int 크기(4바이트) × 5 = 20바이트가 정확히 연달아 잡힌다. 그리고 C에서 a[3] 은 문법적으로 *(a + 3) 과 완전히 동일하다. "시작주소에서 3칸 뒤를 읽어라"는 뜻이다. 덧셈은 교환법칙이 성립하므로 3[a] 라고 써도 컴파일된다. C의 배열은 주소 산술 그 자체다. 그래서 C 배열은 다음 특징을 갖는다. 크기가 고정된다. 뒤에 다른 데이터가 붙어 있으니 중간에 늘릴 수 없다. 모든 원소가 같은 타입이어야 한다. 크기가 달라지면 곱셈 공식이 깨진다. 범위를 넘어 읽으면 그냥 옆 메모리를 읽어버린다. 검사 없이 계산만 하기 때문이다. 이 불편함들은 전부 "배열이 무엇인가"를 그대로 드러내는 흔적이다. 참고로 배열이 스택에 있느냐 힙에 있느냐는 중요하지 않다. malloc(5 * sizeof(int)) 로 힙에 잡아도 완전한 배열이다. 핵심은 연속된 공간에 값 자체 가 들어 있다는 것이다. 파이썬 리스트: 값의 배열이 아니라 주소의 배열 a = [10, "hello", 3.14, [1, 2]] a.append(99) 타입이 섞이고 크기도 자유롭게 늘어난다. 자료구조 정의로 보면 이건 배열이 아니다. 그러면 내부는 어떻게 생겼을까? CPython의 리스트는 포인터들의 배열 이다. 메모리에 연속으로 놓인 건 값이 아니라 "값이 있는 곳의 주소"들이고, 실제 10, "hello", 3.14는 각각 힙 어딘가에 따로 떨어진 객체로 존재한다. C 배열: [10][20][30] ← 연속 공간에 값 자체 파이썬 리스트: [주소][주소][주소] ← 연속 공간에 주소 │ │ │ ▼ ▼ ▼ (10) ("hi") (3.14) ← 각자 흩어진 객체 포인터는 전부 8바이트로 크기가 같으니 주소 산술이 가능하고, 그래서 a[i] 는 여전히 O(1)이다. 다만 C는 계산한 칸에 도착하면 끝이고, 파이썬은 도착한 칸에서 주소를 꺼내 한 번 더 따라가야 값이 나온다. 이 한 겹의 차이가 교수님이 "퇴색됐다"고 표현한 지점이다. 파이썬은 배열의 편리한 결과(인덱스 접근)만 남기고, 배열을 배열이게 하는 구조적 제약(연속성, 동일 타입, 고정 크기)은 추상화 뒤로 치워버렸다. 사용자 입장에서는: 원소가 메모리에 붙어 있는지 알 수도 없고 신경 쓸 필요도 없다 타입 제약이 없다 크기 제약이 없다 (내부적으로 꽉 차면 더 큰 배열을 새로 잡고 복사하는 동적 배열 방식) 범위 밖 접근은 에러로 막아준다 흔히 하는 오해 하나를 짚고 가자. "파이썬 리스트도 값들이 연속되어 있는 건 맞다"는 말은 틀렸다. 연속인 건 포인터이고, 값은 흩어져 있다. 이 차이는 성능에서 눈에 띄게 갈린다. C 배열을 순회하면 CPU 캐시가 다음 값들을 미리 끌어오지만, 파이썬 리스트는 포인터를 읽고 그 주소로 점프하는 간접 참조가 매번 붙는다. NumPy가 빠른 이유는 이 간접 참조를 없애고 값 자체를 연속으로 깔기 때문이다. 왜 파이썬은 이맇게 했나: 모든 것이 객체 단편화 때문은 아니다. 오히려 포인터 방식이 단편화를 더 만든다. 진짜 이유는 파이썬 언어의 설계 자체에서 나온다. 파이썬에는 "그냥 값"이 없다. C에서 10 은 4바이트 그 자체지만, 파이썬에서 10 은 객체다. [참조 카운트][타입 정보 포인터][실제 값 10] ← 약 28바이트 문자열은 길이, 해시값, 인코딩 정보까지 붙어서 더 크고, 리스트는 또 다르다. 즉 파이썬의 모든 값은 크기가 제각각인 객체 다. 크기가 제각각인 걸 연속으로 깔면 주소 산술 공식이 깨진다. 그래서 크기가 똑같은 포인터만 깔고 객체는 밖에 둔다. 파이썬 변수는 전부 참조다. x = 6 은 "상자 x에 6을 넣는다"가 아니라 두 단계다. 6 이라는 int 객체가 메모리에 존재하게 됨 x 라는 이름이 그 객체의 주소를 가리키게 됨 x = [1, 2, 3] y = x y.append(4) print(x) # [1, 2, 3, 4] y = x 는 복사가 아니라 같은 객체를 둘이 가리키는 것이다. 이게 가능하려면 객체가 한 곳에 고정되어 있어야 하고, 변수든 리스트 칸이든 전부 주소만 들고 있어야 한다. id(x) 로 확인하면 x 와 y 의 주소가 같다. 안쪽 값이 크기를 바꿀 수 있다. a[0] = "hello world, this is long" 처럼 원소를 더 큰 것으로 바꿀 때, C 배열이었다면 옆 칸을 덮어버린다. 포인터 방식이면 새 객체를 만들고 주소만 갈아끼우면 끝이다. 연속 값 배열이 편한 건 C처럼 타입이 정해져 있고, 값이 고정 크기이고, 변수가 값을 직접 담는 언어에서의 이야기다. 파이썬은 그 세 전제를 전부 버린 언어라서 포인터 배열이 유일하게 말이 되는 선택이다. 속도를 내준 대가로 유연함을 산 것이다. C와 파이썬의 타입: 컴파일 때 사라지는가, 실행 내내 남는가 C: 메모리에는 값만 있고 타입은 없다. int a = 10; 에서 메모리에 들어가는 건 10을 나타내는 4바이트뿐이다. "이게 int다"라는 정보는 어디에도 저장되지 않는다. 타입은 컴파일러가 코드를 읽을 때만 알고 있다가, "이 4바이트는 정수로 읽어라"는 명령어를 생성하는 데 쓰고 버린다. 실행 중에는 타입이라는 개념 자체가 없다. float f = 3.14; int *p = (int*)&f; printf("%d", *p); // 같은 4바이트를 정수로 우겨서 읽음 → 이상한 숫자 메모리는 그냥 바이트 덩어리고, 어떻게 해석할지는 전적으로 코드가 정한다. 파이썬: 값이 자기 타입을 들고 다닌다. a = 10 에서 메모리에 들어가는 건 [참조카운트][타입: int][값 10] 묶음이다. "내가 int다"라는 정보가 값 옆에 같이 저장되어 있다. 그래서 실행 중에 type(a) 를 물어볼 수 있고, a + "x" 를 하면 런타임에 타입을 확인해서 에러를 낼 수 있다. C 파이썬 메모리에 저장되는 것 값(바이트)만 값 + 타입 + 참조카운트 등 메타데이터 타입은 어디 있나 컴파일러 머릿속에만, 실행 시 소멸 객체 안에, 실행 내내 유지 변수가 담는 것 값 자체 객체의 주소 "변수가 담는 것" 행이 배열 차이의 원인이다. C 변수는 값을 직접 담으니 배열도 값을 직접 깔고, 파이썬 변수는 주소를 담으니 배열도 주소를 깐다. 그리고 "타입이 객체 안에 있다"는 게 메타데이터 때문에 객체 크기가 제각각이 되는 이유다. 파이썬의 메모리 해제: 참조카운트와 순환참조 GC 객체마다 붙어 있는 참조카운트는 그 객체를 가리키는 것의 개수다. 변수뿐 아니라 리스트 칸, 딕셔너리 값, 함수 인자 등 모든 참조 를 센다. a = [1, 2, 3] # 리스트 객체 생성, 참조카운트 1 b = a # 2 c = [a] # 3 (c의 0번 칸이 가리킴) del b # 2 a = None # 1 (a가 다른 걸 가리키게 됨) c.clear() # 0 → 이 순간 즉시 해제 C의 free 와 다른 점은 0이 되는 즉시 해제된다는 것이다. 따로 "지금 치워"라고 할 필요도 없고, 언제 치워질지 모르는 것도 아니다. sys.getrefcount(x) 로 직접 확인할 수 있는데, 호출 시 인자로 넘기면서 +1이 되므로 실제보다 1 크게 나온다. 한 가지 구멍이 있다. 서로를 가리키는 순환 참조 다. a = [] b = [] a.append(b) b.append(a) del a, b 변수는 다 사라졌는데 두 리스트가 서로를 가리키고 있어서 참조카운트가 각각 1에서 안 내려간다. 접근할 방법은 없는데 메모리는 안 풀린다. 그래서 파이썬은 참조카운트 외에 순환 참조만 잡아내는 가비지 컬렉터 를 보조로 돌린다. 기본은 참조카운트로 즉시 처리하고, 가끔 GC가 돌면서 고립된 덩어리를 찾아 치우는 2중 구조다. 이 참조카운트가 객체마다 붙어 있고 모든 대입마다 증감 연산이 일어난다는 것 자체가 파이썬이 지불하는 런타임 비용의 일부다. 파이썬이 얻은 것: 런타임 타입 정보가 열어주는 기능들 메타데이터 비용은 분명히 비효율이다. 그 대가로 얻는 것은 "타입을 안 써도 된다" 하나가 아니라, "모든 것이 객체"라는 단 하나의 규칙으로 언어 전체가 통일된다 는 것이다. 메모리 관리를 안 해도 된다. 참조카운트 덕분에 아무도 안 가리키는 순간 자동 해제된다. malloc / free 짝 맞추기, 해제 후 접근, 메모리 누수와 싸우는 일이 통째로 사라진다. 범위 밖 접근이 터지지 않는다. 객체가 자기 길이와 타입을 들고 있으니 a[100] 에서 에러를 낼 수 있다. C에서는 옆 메모리를 읽어버리고, 이것이 보안 취약점의 역사 그 자체다. 실행 중에 타입을 물어볼 수 있다. 이게 핵심이다. 아래에서 자세히 본다. 숫자, 문자열, 함수, 클래스, 모듈이 전부 같은 방식으로 다뤄진다. 함수를 리스트에 넣고, 클래스를 변수에 담아 넘기는 게 전부 "객체 주소 하나 복사"라서 특별한 문법이 필요 없다. 타입을 안 써도 된다. 4번의 당연한 결과다. 실행 중에 타입을 물어본다는 것 C에서는 프로그램이 실행되는 동안 "이 값이 무슨 타입이지?"라고 물어볼 방법이 없다. 타입은 컴파일 때 사라졌으니까. void print_it(void *p) { // p가 가리키는 게 int인지 float인지 알 방법이 전혀 없음 } 파이썬은 객체가 타입을 몸에 붙이고 다니니 물어볼 수 있다. def print_it(x): print(type(x)) # 실행 중에 알아냄 if isinstance(x, str): # "문자열이냐?" 물어보기 print("문자열이네") class Dog: def speak(self): return "멍" d = Dog() hasattr(d, "speak") # True — speak이 있냐? getattr(d, "speak")() # 이름을 문자열로 주고 꺼내서 호출 이 "물어볼 수 있음" 하나에서 파이썬 특유의 기능들이 따라 나온다. 덕 타이핑 : "타입이 뭐냐"가 아니라 "할 수 있냐"로 판단. animal.speak() 는 Dog든 Cat이든 speak만 있으면 된다. 데코레이터 : 함수도 객체니까 함수를 받아 다른 함수로 바꿔치기할 수 있다. f.__name__ 이 되는 것도 함수 객체가 이름을 메타데이터로 들고 있어서다. 동적 import : 모듈도 객체라 이름을 문자열로 받아 실행 중에 불러올 수 있다. 메타클래스 : 클래스조차 객체라서 실행 중에 만들거나 고칠 수 있다. 설계 철학: 사람 시간 > 컴퓨터 시간 파이썬이 나온 1991년에도 C보다 수십 배 느린 건 알았다. 그런데 대부분의 프로그램은 CPU가 병목이 아니다. 사람이 코드를 쓰고 읽고 고치는 시간이 병목이다. 파이썬은 "컴퓨터가 10배 더 일하게 하고 사람은 3배 덜 일하게 하자"에 베팅한 언어다. 그리고 정말 속도가 필요한 부분만 빠져나갈 구멍을 열어뒀다. NumPy, pandas, PyTorch는 핵심 연산을 C로 짜고 파이썬은 조립만 한다. "파이썬은 느린데 왜 AI는 다 파이썬이냐"의 답이 이것이다. 최근 언어들의 방향: 편의는 가져오고 비용은 안 내기 "그러면 최근 언어들은 대부분 파이썬처럼 객체 형태를 띠겠네?"라는 추측은 반대다. 파이썬(1991), 루비(1995), 자바스크립트(1995)가 "전부 객체 + 동적 타입" 세대이고, 전부 30년 된 언어다. 이 세대의 발견은 "타입 안 쓰고 메모리 안 만지면 개발이 훨씬 빠르다"였고, 그 대가로 속도를 냈다. 그 이후 세대는 파이썬의 편의성은 갖되 그 비용은 안 내는 방법 을 찾는 쪽으로 움직였다. 언어 접근 Go (2009) 정적 타입이지만 타입 추론으로 거의 안 씀. GC는 있음. 값은 C처럼 직접 저장. Rust (2010) 정적 타입 + 타입 추론. GC도 참조카운트도 없이 컴파일러가 소유권을 추적해 메모리를 자동 해제. 실행 속도는 C와 동급. Kotlin (2011) 정적 타입 + 추론. JVM 위에서 자바보다 간결하게. TypeScript (2012) 자바스크립트에 타입을 다시 붙인 언어. Swift (2014) 정적 타입. 참조카운트는 쓰지만 int 같은 기본값은 C처럼 직접 저장. 공통점은 하나다. 타입은 다시 가져오되 사람이 일일이 쓰진 않게(타입 추론), 메모리 관리는 자동으로 하되 런타임 비용은 줄이게. 파이썬이 런타임에 돈을 내고 샀던 안전성과 편의를 컴파일 타임에 사려는 시도다. TypeScript가 특히 상징적이다. 동적 타입 언어의 끝판왕인 자바스크립트를 쓰던 사람들이 "타입 없이 큰 프로그램 짜는 건 힘들다"며 타입을 되돌린 것이다. 파이썬 자체도 3.5부터 타입 힌트( def f(x: int) -> str )를 넣었다. 실행엔 영향 없지만 도구가 검사해준다. Rust: 타입 추론, 컴파일러가 타입을 기억하고 버리는 과정, 기계어로의 변환 타입 추론: 타입은 있지만 쓰지는 않는다 같은 코드를 세 언어로 놓고 보면 바로 보인다. int x = 6; // C: 타입을 사람이 씀 x = "hello"; // 컴파일 에러 x = 6 # 파이썬: 타입 없음 x = "hello" # 그냥 됨 — x는 이름표라 아무거나 가리킴 let x = 6; // Rust: 타입을 안 썼는데... x = "hello"; // 컴파일 에러 — "x는 i32인데 왜 문자열?" Rust 컴파일러는 let x = 6; 을 읽고 "오른쪽에 6이 있네, 정수니까 x는 i32로 확정"이라고 추론한다. 마치 사람이 let x: i32 = 6; 이라고 쓴 것처럼 취급한다. 타입은 분명히 있는데, 그걸 적는 일을 사람 대신 컴파일러가 한 것뿐이다. ( i32 는 32비트 정수, C의 int 에 해당한다. Rust는 i8 , i64 , u32 , f64 처럼 타입 이름에 크기를 그대로 적는다.) 타입이 정해지는 시점 누가 정하나 나중에 바꿀 수 있나 C 컴파일 때 사람이 적음 불가 Rust 컴파일 때 컴파일러가 추론 불가 파이썬 정해지지 않음 (객체가 각자 들고 있음) — 가능 (이름표만 옮기면 됨) 파이썬의 x 는 6 객체에 붙은 이름표라 "hello" 객체로 옮기는 게 자유다. Rust의 x 는 i32로 못 박힌 4바이트 상자다. C와 같은 상자인데, 라벨을 컴파일러가 알아서 써준 것이다. 컴파일러는 어디에 타입을 기억하는가 "기억한다"는 건 어딘가에 저장한다는 뜻인데, 그 데이터는 어디 있을까? 답은 컴파일러가 돌아가는 동안에만 컴파일러의 메모리에 있다가, 컴파일이 끝나면 버려진다 이다. 런타임이 아니라 컴파일러가 기억한다. 컴파일 중 : 컴파일러는 소스코드를 읽는 하나의 프로그램이다. 코드를 읽으면서 자기 메모리에 심볼 테이블이라는 표를 만든다. x | i32 | 4바이트 | 스택 오프셋 8 같은 줄이 추가된다. x = "hello" 가 오면 이 표를 보고 에러를 낸다. 기계어 생성 : 표를 참고해 "오프셋 8번 자리에 4바이트짜리 정수 6을 써라" 같은 명령어를 뽑는다. 타입 정보가 명령어 선택에 녹아 들어간다. 컴파일 종료 : 표는 버려진다. 남는 건 기계어 파일뿐이다. 실행 : 메모리에는 6을 나타내는 4바이트만 있다. "이게 i32다"라는 정보는 어디에도 없다. 기계어에는 변수도 타입도 없다 let x = 6; let y = x + 1; 이것이 컴파일되면 대략 이런 어셈블리가 된다. mov DWORD [rbp-4], 6 ; rbp-4 번지에 4바이트(DWORD)로 6을 써라 mov eax, DWORD [rbp-4] ; rbp-4 번지에서 4바이트 읽어서 eax에 담아라 add eax, 1 ; eax에 정수 1을 더해라 mov DWORD [rbp-8], eax ; 결과를 rbp-8 번지에 4바이트로 써라 x 는 없다. rbp-4 라는 주소 가 됐다. i32 도 없다. 대신 DWORD (4바이트)라는 크기 지정 과 add (정수 덧셈)라는 명령어 종류 에 녹아 있다. CPU에는 같은 덧셈이어도 add (정수), addss (32비트 실수), addsd (64비트 실수)처럼 명령어가 여러 개 있다. 컴파일러가 "x는 i32"를 보고 add 를 골랐다. "정수로 읽어라"는 정보가 메모리에 적힌 게 아니라, 컴파일러가 정수용 명령어를 골라 박아놓은 것 자체가 그 정보 다. CPU는 rbp-4 에 든 게 x인지 i32인지 전혀 모르고, 받은 명령어를 그대로 실행할 뿐이다. 파이썬은 이 선택을 미리 못 한다. x + 1 에서 x가 정수일지 문자열일지 실행해봐야 알기 때문이다. 그래서 실행 중에 객체의 타입 칸을 읽고 "정수네, 정수 덧셈 하자"를 매번 결정한다. C와 Rust는 그 결정을 컴파일 때 한 번 하고 끝낸다. 이것이 속도 차이의 가장 직접적인 원인이다. Rust와 C의 차이: 소유권, 범위 기반 해제, 빌림 메모리에 값이 놓이는 방식과 타입이 컴파일 때 사라지는 것, 이 둘은 Rust와 C가 정말로 같다. 그래서 Rust 실행 속도가 C와 거의 같다. 차이는 컴파일러가 코드를 얼마나 깐깐하게 검사하느냐 에서 갈린다. 메모리 해제: C는 사람이, Rust는 컴파일러가 int *p = malloc(100); free(p); *p = 5; // 해제한 메모리에 씀 — 컴파일러는 통과시킴, 실행하면 뭔 일이 날지 모름 let v = vec![1, 2, 3]; drop(v); v[0]; // 컴파일 에러: "v는 이미 사라졌는데?" "프로그램은 동작하다가 값이 필요 없어지기도 하고 계속 필요하기도 한데, 컴파일러가 어떻게 그걸 미리 알 수 있나?"라는 의문이 자연스럽다. 답은 실행을 예측하는 게 아니라 코드의 구조(중괄호)만 보고 정한다 는 것이다. 소유권(ownership) 규칙은 세 가지뿐이다. 모든 값에는 주인(owner)이 딱 하나 주인은 넘길 수 있다 (반환, 인자 전달, 다른 변수에 대입) 주인이 중괄호를 나가는 순간 해제 fn main() { let a = vec![1]; { let b = vec![2]; } // ← 여기서 b 해제 println!("{:?}", a); } // ← 여기서 a 해제 컴파일러는 "이 벡터가 언제까지 필요할까"를 고민하지 않는다. 주인 변수가 선언된 블록이 어디서 닫히는지만 본다. 그건 코드를 읽기만 하면 100% 확정된다. 그 자리에 free 에 해당하는 명령어를 자동으로 끼워 넣는다. 블록이 끝나도 값이 더 필요하면 주인을 넘긴다(move). fn make() -> Vec<i32> { let v = vec![1, 2, 3]; v // 반환 = 주인 자격을 호출한 쪽으로 넘김 } // v는 주인이 아니게 됐으므로 해제 안 함 fn eat(v: Vec<i32>) { } // 인자로 받음 = 주인이 됨, 함수 끝에서 해제 fn main() { let w = make(); // 이제 w가 주인 eat(w); // 주인 넘김 println!("{:?}", w); // 컴파일 에러: "w는 이미 넘겨줬잖아
Decorex International 2026 returns to London from 11–14 October 2026, bringing together designers, architects, specifiers, makers, brands and professiona ls from across the luxury interior design industry. With product showcases, design talks, workshops, craftsmanship demonstrations, and networking opportunities, Decorex London 2026 offers a valuable meeting point for professionals looking to source products, develop projects, and stay connected with the evolving interiors industry. Visit: https://www.synnoptechcad.com/exhibitions/decorex-international-london-2026/ Keywords: Decorex International, decorex international 2026, Decorex 2026, Decorex 2026 Dates, Decorex London, Decorex London 2026, Interior Design Show, Interior Design Show London, Decorex 2026 exhibitor list