Общие новости
Cloudflare Containers快照实践:持久状态不等于可信恢复
掘金
一个编码Agent安装了依赖、修到一半、等待人类回复,不应该为了省钱关掉计算后就从零开始。Cloudflare的新答案是文件系统快照:让Linux环境睡眠,保留可恢复的工作区。但工程上最重要的一句补充是:恢复出相同文件,
Балл: 57.36Уверенность: 54%
ПодробнееЗагружаем каталог…
НАВИГАТОР ПО ВОЗМОЖНОСТЯМ ИИ
Найдите свой ИИ-инструмент. Бесплатный доступ, пробные периоды и кредиты — в одном месте.
掘金
一个编码Agent安装了依赖、修到一半、等待人类回复,不应该为了省钱关掉计算后就从零开始。Cloudflare的新答案是文件系统快照:让Linux环境睡眠,保留可恢复的工作区。但工程上最重要的一句补充是:恢复出相同文件,
Балл: 57.36Уверенность: 54%
Подробнее人人都是产品经理
会员续费入口优化,看似简单的功能需求,实则暗藏业务判断的深水区。本文以一款付费模板工具为例,拆解如何从“没续费”的表象中定位真实卡点,通过冻结名单、明确观察窗口与主指标,构建可检验的续费过程。 运营提出一个需求:把会员续费入口做得明显一点,快到期时再提醒一次。 这件事很容易被拆成几项开发任务:增加按钮、配置提醒、接入支付、延长会员有效期。但这些功能都能正常运行以后,还会剩下一个问题:原来没有续费的人,会因此愿意续费吗? 产品经理的作用,往往就在这个问题里。团队需要有人判断,眼前的功能究竟在解决哪种业务问题,以及怎样知道它解决了问题。 下面用一款提供付费模板导出的工具作业务示例。为便于讨论,设定会员每期有效30天、由用户手动续费,不涉及自动扣款。情境和规则用于说明方法,不对应真实项目,也没有预设的转化结果。 一、先分清没续费的人,究竟卡在哪里 会员没有续费,原因可能很不一样。 有人用过模板,也准备继续用,只是没有注意到到期时间;有人主动找过续费入口,却没找到;有人已经下单,但支付没有完成;还有人这个月根本没用过付费权益,觉得不值得再买。 只看“续费人数不够”,这些人都会落在同一组里。但一个到期提醒,显然解决不了全部问题。 所以,在确定按钮放在哪里之前,要先把会员的使用记录、续费路径和用户反馈对起来。谁用过核心权益?谁进入过会员页?支付失败集中在哪个环节?用户不愿续费,是暂时没有任务,还是没有获得预期价值? 数据可以帮助定位行为,具体原因还需要结合用户反馈。没有点击续费入口,不能直接推断为“不知道入口在哪里”。 为了继续这个示例,假设本次核对已能复现两个问题:到期信息不够醒目,会员页的续费入口不容易找到;现有支付通道则可以使用。团队据此选择一个明确目标:帮助本周期已经使用过模板、仍待续费的临期会员,看清有效期和权益,并顺利完成手动续费。 这次先改善到期信息、权益说明和续费入口,不同时增加折扣、改会员价格或引入自动扣款。否则多项改动混在一起,后面很难判断究竟是哪一项起了作用。 用过模板,也不等于一定愿意续费。它只是本次选择人群的依据。没有使用过权益的会员,应另查激活和产品价值问题;不能把这部分人从报表里去掉,就宣布整个会员业务变好了。 目标定到这一步,团队才知道哪些功能值得进入本期,哪些问题暂时没有被解决。这个判断会同时改变设计、研发、运营和数据的工作。 二、同一批会员,究竟怎样算续费了 目标明确了,指标也要在开发前说清楚。 如果只记录新按钮的点击率,很容易得到一份好看的报告,却回答不了业务问题:原来从会员中心续费的人,可能只是改从新按钮进来了,总续费人数并没有变化。 先把观察对象固定下来。本例约定,在每位会员原定到期日前7天,记录其原始到期日,筛出本周期已经完成过付费模板导出、尚未提前续费的人,形成待观察名单。之后即使他续费、退款,或者没有再打开产品,也不把他从这份名单里移走。 这里用的是冻结名单之前发生的使用行为,不能等改版上线后,再挑出使用最积极的一批人计算结果。续费改变的是会员的新有效期,原始观察日期也不能跟着重算。 接着观察原定到期日前7天至后7天。这是本例约定的窗口,不是通用行业标准。主指标看这份名单中,有多少人在窗口内完成了支付,并且新一期权益确实生效;同一会员只计一次,从任何正常续费入口完成都要算。 因此,这个指标只表示“目标临期会员的续费完成率”,不能代表所有会员。它也不等于净收入或长期留存,后续退款和再次使用还需要继续观察。 新入口的曝光、点击、下单和支付,则用于解释主指标为什么发生变化。曝光后少有人点击,可以进一步看表达和使用场景;点击后大量中断,需要检查购买信息和操作过程;支付成功却没有取得权益,则是履约问题。 这些信号帮助排查,却不能替用户表态。按钮点击只说明一次行为,不能直接证明他理解了价值。 到这里,产品经理需要和数据、研发一起确认事件及状态来源。等功能上线后才想起补埋点,往往已经无法还原改动之前的情况。 三、一个续费入口,背后有两套状态 接下来才进入具体设计。 会员页需要让用户看清当前到期时间、这次购买的权益、价格,以及续费后的新有效期。到期提醒应把人带到正确的续费位置,已经完成续费的人也不应继续收到针对旧到期日的催续信息。 真正容易出错的,常常是这些页面背后的规则。 首先,会员有效期与续费订单是两套状态。一个仍然有效的会员,可以有一笔支付失败的续费订单。不能因为这笔新订单失败,就把他原本仍有效的权益收掉。 其次,支付完成和权益生效之间还有一步。如果钱已经付了,会员时间却没有延长,系统需要能够识别和跟进这个断点。页面不能只显示一句“支付成功”就让用户自己等,也不能引导他反复付款。 本例进一步约定:未到期时续费,新一期从原到期时间顺延;已经到期后续费,新一期从本次订单约定的支付成功时间起算。因为每期固定30天,购买页应明确展示计算后的新有效期,避免提前续费反而损失剩余时长。 这些属于业务规则,需要产品、业务与相关团队确认。研发负责选择可靠的实现方式:同一订单的支付通知到达多次,不能多发几期权益;用户反复点击,也不能在不知情的情况下生成重复购买。测试则需要准备对应的验证场景。 退款同样要与具体订单及其权益关联。退掉一笔续费订单,不等于可以直接删除用户全部会员权益。应按已确认的退款及权益规则处理,并让客服能查到订单和有效期变化的原因。 这些问题很难由任何一个岗位独自回答。设计需要知道该展示什么,研发需要知道哪些变化被允许,测试需要知道怎样才算正确,运营和客服需要知道如何触达用户、如何解释异常。 产品经理要做的是把这些判断放进同一份方案:未确定的规则由谁确认,哪些结论会影响其他团队,改了以后需要同步到哪里。把信息在群里转发一遍,还不算完成这件事。 这也是产品经理在开发中的重要作用:他要持续检查,各团队正在实现的局部功能,能否接成同一条完整的用户路径。 四、验收通过以后,再看业务问题有没有改善 上线前,先按确认过的目标和规则检查功能。 一个仍有效的会员提前续费,剩余时长要被保留;一个已经到期的会员完成购买,新一期权益要按约定生效;一次支付失败,不能破坏原有权益;重复通知、支付后发权延迟、退款处理,都要有明确结果和处理责任。 提醒是否仍按旧到期日发送,客服是否能定位相关订单,埋点是否覆盖了约定的观察人群,也属于上线准备。产品验收关注业务规则和路径,测试提供质量验证,研发与运维确认发布、监测和回退条件。 功能能够可靠运行以后,再看原先固定的那批会员。 有人看到了提醒但仍未续费,可能要继续核对权益价值和使用需求;有人发起支付却没有完成,先排查支付过程;有人完成续费却迟迟没有再次使用,则需要观察购买后的体验。不同问题对应不同动作,不能看到一个总转化率就统一加大推送。 退款、投诉和再次使用,也要给每位续费用户同样长度的后续观察时间。窗口最后一天才购买的人,不能因为还没有来得及使用,就被计成“续费后不活跃”;观察尚未结束的记录应标为待观察。续费完成率上升,如果同时伴随更多退款或问题反馈,也不能直接下结论说改版成功。 历史记录可以提供参照,但相同口径下看到变化,仍不足以证明是新入口造成的。季节、流量来源和权益内容都可能影响结果。如果条件允许,可以在名单冻结时安排同期对照,并按原来的分组统计;不能事后只挑看到提醒、点过按钮的人比较。 没有这些条件,就如实记录观察到的变化,结合行为和反馈继续排查。产品经理的判断也包括知道哪些结论现在还下不了。 回看最初的需求,如果团队只收到“加按钮、发提醒”,完全可能交付一套能运行的功能。而把用户问题、目标人群、有效期规则、支付发权和结果判断补齐后,团队交付的才是一段能够被检验的续费过程。 这些工作可以由具备相应能力的其他角色分担,但必须有人持续负责把它们接起来。 产品经理之所以重要,就在于这份连续的责任:让每一项开发工作有明确的业务依据,也让上线后的结果能够反过来检验最初的判断。 本文由 @AI产品经理老猫 原创发布于人人都是产品经理。未经作者许可,禁止转载 题图来自Unsplash,基于CC0协议
Балл: 57.31Уверенность: 54%
Подробнее人人都是产品经理
同一周内,Manus、Meta 和 OpenAI 相继推出个人 Agent,但胜负手已从“能干多少活”转向“权限边界”与“生态落地”。Manus 让 Agent 拥有独立钱包与数字身份,Meta 用硬隔离筑起安全网,OpenAI 则靠套餐闭环与只读权限稳扎稳打。本文拆解三家产品路线,探讨 Agent 时代的安全悖论与用户信任边界。 同一周里,Manus、Meta 和 OpenAI 不约而同地把个人 Agent 推到了前台。把三家的产品路线放在一起看,一个很直观的感受是:决定胜负的,不再是 Agent 能替你干多少活,而是两件事——它会不会只做你允许的事,以及它要落地的生态让不让它用。 当我们要回一封邮件、订一家餐厅时,谁能成为用户下意识呼唤的那个首选?围绕这个身位,三家交出了截然不同的答卷。 一、Manus:让 Agent 像“真人助理”一样去跑业务 Manus 2.0 的动作很大:Cascade Agent 框架、可购买的云电脑、Manus Studio,以及用手机反向指挥电脑。但在眼花缭乱的功能里,最值得关注的是它的个人应用 Cue 。 Cue 的核心逻辑是给每个 Agent 配备独立的“数字身份”——独立的邮箱、电话号码、钱包和云电脑。它能以自己的名义发消息、在预算内自动付款,甚至能替你接听电话并生成摘要;在线下,扫一下餐厅二维码就能让 Agent 代为排队点餐。 让 Agent 像真人一样去生活,体验极其性感。但“独立钱包”的背面是实打实的财务风险——它花出去的每一笔钱,最终都要由用户来买单。当功能从“抢先体验”走向大规模落地,“预算内付款”所要承担的边界控制成本会呈指数级上升。 二、Meta:把安全和权限关进“笼子里” 与 Manus 的激进不同,Meta 的思路是从底层架构开始防范失控。 根据扎克伯格的拆解,Meta 为 Muse 设计了一套独立凭据系统:信用卡和密码绝不直接暴露给核心 Agent;一组监控 Agent 在虚拟机外围巡逻,拦截提示词注入。在权限上,登录和付款等敏感动作必须显式授权,且支持“最小权限”原则。 然而,安全网织得再密,也挡不住交互设计上的隐患。 科技 YouTuber Matt Robb 的遭遇暴露了典型的人机理解鸿沟:他让 Muse 代理 Facebook Marketplace 的买家消息,并点下了“总是允许”。在他看来,这只是“同意替我回消息”,但在系统的底层逻辑里,这直接演变成了“授权它全权成交”,甚至导致真实取货地址被错误外发。事后 Robb 试图纠错,Agent 依然发生了越权行为。 这说明了一个产品痛点: 当用户的直觉认知与系统的状态机权限脱节时,所谓的“长期允许”就会变成安全炸弹。 加上亚马逊等生态平台对 Muse 的封禁,也证明了“越过平台强行抓取凭据”的路线正面临现实阻力。 三、OpenAI:嵌入套餐的闭环生态与硬性隔离 OpenAI 推出的 dots 搭载了 GPT-6 Astra 模型,标配云电脑,24/7 挂机执行任务,并通过插件打通了 4000 多个应用。 在商业化上,OpenAI 采取了巧妙的“钩子”策略:首个 dot 包含在高级订阅套餐中,日常聊天不耗额度;但只要调用 Codex 或后台发起复杂任务,就会开始消耗额度。这种“基础免费、高频多线收费”的模式,本质逻辑依然是: Agent 帮你干的活越多,平台的商业价值越大。 在安全防线的设计上,OpenAI 采取了相对保守的硬隔离策略:云电脑默认物理隔离,后台调研只给只读工具,改密码等核心操作坚决不予放权。同时支持 Custom Rules 划分权限,并坦诚提醒用户: AI 依然会犯错,重要工作必须人工复核。 四、总结与思考 复盘这三款产品可以发现,云电脑、全天候在线、接支付等功能在未来几个季度会迅速趋同。真正拉开差距的,是 模型边界感的控制方式 。 如果我们去评估 Agent 的权限设计,核心只看一条标准: 这条限制究竟是靠硬核系统卡死,还是靠写给 Prompt 的规则让模型自己领会? 类似“只读权限”、“关键动作必须本人操作”的硬隔离,属于底线防线,哪怕模型理解偏差也无法越界。 类似“长期允许回复”、“预算内付款”的场景,极度依赖模型的概率判断。偏偏个人 Agent 最具吸引力的核心价值,又恰恰需要交出这种判断权。 回到最开始的问题:如果让我来抉择,查资料、做汇总这类系统硬性隔离的“只读”任务,可以放心交给 Agent。但只要涉及到“替我做商业决策、替我付款、替我做不可逆承诺”的场景——在目前的模型成熟度下,我们可能还远没到能把钥匙完全交出去的时候。 本文由 @Ethan_Hu 原创发布于人人都是产品经理。未经作者许可,禁止转载 题图来自Unsplash,基于CC0协议
Балл: 57.3Уверенность: 54%
ПодробнееReadhub
美联储理事鲍曼近日发表最新讲话,明确表示在当前宏观经济环境下今年已无必要继续进行利率调整。他指出美联储目前的政策立场已具备足够的限制性,能够有效应对通胀与就业市场的变化。该表态呼应了市场对于年内维持基准利率不变的主流预期,为后续货币政策路径提供了明确参考,进一步巩固了当前利率决议的稳定性预期,相关资产定价逻辑也随之趋于明朗。
Балл: 57.24Уверенность: 54%
ПодробнееReadhub
29 岁的顶尖 AI 研究者姚顺宇拥有清华物理系、斯坦福博士等亮眼学术背景,先后任职于 Anthropic、Google DeepMind,近期他公开探讨热门的 RSI(递归自我改进)技术,其创业动向引发创投圈高度关注,已有头部 VC 主动接触。当下 RSI 赛道创业热潮涌动,一批拥有顶尖学术背景与前沿产业履历的华人 AI 天才纷纷投身相关创业,投资人普遍认为抢到这类核心人才就相当于抓住了 AI 时代的关键机遇。
Балл: 57.22Уверенность: 54%
ПодробнееReadhub
总部位于伦敦的 AI 语音初创公司 ElevenLabs 在一笔股权交易后估值翻倍至 220 亿美元,跻身全球最有价值 AI 实验室行列。该公司现有投资者和员工通过惠灵顿管理公司和普信集团领投的股权出售交易,出售了价值 3 亿美元的股份。此次交易使其估值较今年 2 月上一轮融资时翻倍,估值与本月完成融资、创下欧洲规模最大私人科技融资纪录的法国 AI 初创公司 Mistral 接近。
Балл: 57.22Уверенность: 54%
ПодробнееReadhub
Meta 的 AI 助手 Muse 上线约三周下载量突破 500 万次,登顶美国 App Store 免费榜并连续 12 天位居榜首,达成该下载量的耗时远短于 ChatGPT、Grok、Claude 等同类 AI 应用。在美国市场上线 22 天内下载量超 500 万次的应用中,非游戏类此前仅 3 款。Muse 作为智能体 AI 助手,可代表用户执行浏览网页、发邮件、在线购物等多步骤任务。Meta 自 9 月 16 日起加大 Muse 的广告投放力度,带动当日下载量环比增长 73%,近期 Muse 在 Meta 自有广告展示量中占比最高达 50%。
Балл: 57.22Уверенность: 54%
Подробнееvelog
프롤로그: 대학교에서 학점은행제에서 필요한 학점 때문에 수업듣는 산넘어는 고생길이 시작되는데.... ====== 산넘어: 안녕하세요. 다들 강의 잘 들으셨죠? 이번에 교수님이 기말고사 대체로 조별과제를 내 주셨는데 복불복으로 뽑는 바람에 다 초면인 분들이네요, 잘 부탁드려요. 이우전: 뉘예뉘예~ 나영속: 네, 한 번 잘 해보죠. 산넘어: 제 이름은 산 넘어고요. 저희가 담당하게 된 주제가 예상보다 더 많더라구요, 시험기간이므로 조별과제부터 일찍 끝내고 다른 시험도 잘 준비해보죠. 이우전: 네~ 나영속: 그럼 조도 짜여졌겠다, 친목도 다질겸 회식 한 번 해야 하지 않을까요? 다들 시간 어떠세요?? 이우전: 죄송하지만 전 이번 달 내내 방송 대본 짜야해서 시간 없을 듯 하네요~ 나영속: 아;; 그러시구나;;;; 그럼 다음에 시간날 때 1잔 어떠십니까?ᄒ 산넘어: 자 만나는 건 나중에 얘기하고 저희 분량 먼저 나눌까요? 총 3단원 84페이지니까 각각 1단원씩 28 페이지씩 공평하게 나누려는데 이견 있나요? 이우전: 아뇨~ 그렇게 해요~ 산넘어: 그럼 각자 분량 잘 맡아서 열심히 해가지고 저희 좋은 점수 받아봐요. 일단 다음 달까지 자신이 맡은 분량 정리해서 저희끼리 발표 준비해 오는 걸로 하고 조장은 제가 맡을게요, 다들 괜찮으시죠? 이우전: 네~ 뭐 알아서 하세요~ 그리고 죄송한데 제가 지금 업무 때문에 이제 톡 못할 것 같거든요? 다음 달에 다시 회의해요~ 1주 뒤 나영속: 저, 조장님. 다름이 아니라 할 말씀이 좀 있는데요.. 산넘어: 할 말씀이요? 나영속: 제가 맡은 파트 보니까 분량이 상당하더라구요. 좀 불공정하단 생각도 들고 사실 제가 이번이 막학기고 이직 준비까지 하고 있는데요? 산넘어: 파트는 단원 당 28페이지니까 다 공정하다 생각하는데요? 문제될 건 없다고 여겨집니다. 나영속: 제가 꼭 들어가고 싶은 회사가 있는데 거기서 요구하는 자격증 시험 땜에 조별과제랑 병행하기 좀 많이 어렵거든요?ᄒ;; 산넘어: 저도 막학기이고 영속님과 마찬가지로 일자리 구하는 상황인데요?;;; 나영속: 아 그래도 파이널 파트가 가장 어렵긴하잖아요, 저 다른 학과라 이 강의 너무 어렵다고요. 산넘어: 강의만 열심히 따라가면 다 이해되던데요?? 게다가 저도 처음 배우는 건데;;; 나영속: 아 레알 조별과제 이렇게 선 딱딱 긋는거 너무 정 없지 않나요? 좀 도와주십쇼~! 각박하게 그러지 마시고... 조장이시잖아요. 산넘어: ......... 하.. 일단 알았습니다. 조장 맡기로 했으니까 제가 약간 더 도와드릴게요. 나영속: 오 레알요? 감사합니다ᄏᄏ 덕택에 기분도 좋아졌는데 조장님 지금 만나서 막걸리 한 잔 하실래요? 이우전님도 꼭 불러가지고 파전에 막걸리 한 잔 하면서 머리에 알코올을 채워넣으면 머리가 맑아질테니 과제도 술술 풀릴 듯 한데ᄒ 산넘어: 아.. 근데 제가 헌혈을 하고 있어서 요새 술 마시면 안 돼요. 나영속: 아 너무 빼시네~ 술 못하시나 봐요~? 그럼 뭐 회식은 담에 하죠, 일단 제 분량 좀만 부탁할게요. 한 20페이지 까지만 해 주시면 될 것 같아요. 산넘어: 20페이지요?;; 이 정도면 거의 다 아니예요?;;;;; 나영속: 이 부분만 해결하면 나머지는 제가 알아서 할게요. 이왕 해주시는거 저희 쿨하게 가죠~! 산넘어: 아니 근데 이 정도면 저더러 거의 다 하란 뜻이잖아요;; 제 분량도 엄연히 있는 상태인데;; 나영속: 제 전공이 아니므로 많이 어려우니 그렇죠. 대신 도와주시면 다른 부분에서 제가 도와드릴 부분 생길 때 제가 더 맡아서 할게요. 산넘어: 하.. 일단 알았으니까 이번 달 자료조사 부분은 제가 더 해드릴테니 다음 회의 때는 좀만 더 신경 좀 써주세요. 나영속: 네~ᄒᄒ 중간회의 산넘어: 안녕하세요, 한 달간 다들 잘 지내셨나요? 이우전: 업무하느라 정신 없었네요. 나영속: 조장님~ 비도 오는데 이런 날은 소주에 두부김치 먹으면 딱인데 그쵸? 혹시 다들 오늘 시간 괜찮으세요? 모여서 이야기하는 시간도 필요하다고 보는데. 이우전: 저 오늘 끝나고 마사지 받는데요? 나영속: 아.. 그럼 어쩔 수 없죠.. 다음에 먹어요 저희.. 산넘어: 기억났는데 엑셀을 만들어야 되는데 혹시 컴퓨터 좀 익숙하신 분 계세요? 이우전: 전 컴맹이라 전혀 몰라요 나영속: 저도 컴퓨터는 영 젬병이라;; 그냥 조장님이 해주시면 안되나요? 산넘어: ........ 그럼 제가 엑셀 제작 할테니까 이우전님이 발표 좀 맡아주실 수 있나요? 이우전: 아이고.. 제가 지금 교정기를 해서 발음이 좀 어색하거든요. 이것 참 유감이네요.. 발표는 우리 영속님이 해주시면 안 되나요? 나영속: 우리 영속님?? 헤헷~ 물론이죠~ 그럼요 ! 발표 하난 기똥차게 할 자신 있습니다. 믿고 맡겨만 주시죠 !ᄒᄒ 이우전: 산조장님 제가 E메일 보낸거 체크하셨나요?? 제가 자료조사 한다고 온라인 다 뒤져가며 한땀한땀 꼼꼼하게 했으니까 이정도면 2인분 넘게 한듯 하네요~ᄏ 태클은 미리 사절합니다. 산넘어: 안그래도 이우전님이 주신 자료 체크를 좀 해봤는데 이거 온라인에서 그대로 긁어오신거 아니예요? 사이트랑 장작위키에 있는거 짜깁기 한 것 같은데;;; 이우전: 태클은 거절한다고 했을텐데요? 더구나 제가 온라인에서 하나하나 다 찾아보고 가져온거라 딱히 문제될 건 없어요ᅳᅳ 산넘어: 하아.. 그럼 일단 보내주신 자료 다시 정리해보죠. 다만 다음엔 바로 긁어오지 마시고 직접 생각 정리한 후에 타이핑 부탁드립니다. 이우전: 하 조장님 정말 깐깐하시네ᅳᅳ 아 알겠어요 담엔 그리 할테니까 이번은 좀 걍 넘어가시죠. 나영속: 저도 자료조사한게 있는데 2시간만 더 주시면 더 정리해서 조장님한테 전송해드릴게요. 산넘어: 영속님 열심히 하는 건 좋은데 다음엔 약속 시간 지켜주시면 안 되나요? 나영속: 아니 제가 더 열심히 해서 드리겠다는데 꼭 그렇게 말해야 속이 후련해요? 다 좋은 점수 받자고 좀 더 신경써서 보낸다잖아요. 산넘어: 제가 딴죽 걸려는건 아니고 저도 다른 과제가 있고 영속님이 부탁해서 분량도 거의 제가 다 맡아드렸잖아요. 그러니까 적어도 시간 정도는 지켜달란거죠. 나영속: 아 긁혀서 과제 할 마음 팍 식네ᅳᅳ 기분 전환도 할 겸 좀 쉴테니까 자료는 모레까지 보내드리죠ᅳᅳ 산넘어: 아뇨 저기 영속씨;;;; 저도 조별과제만 있는게 아니라 다른 과목도 있으니까 좀 부탁 드립니다. 나영속: 아니 제 기분이 이런데 과제 할 맛이 나겠어요? 인간 긁을땐 언제고ᅳᅳ 그거 스무 페이지 더 해주니까 긁을 자격 된다 이거에요?? 조별과제인데 니꺼 내꺼 구분을 왜 해요 좀 더 할 수도 있는거지 우리 한 패 아니에요? 산넘어: 아 알겠으니까 이제 니꺼 내꺼 구분 안 할테니 파이팅 합시다. 나영속: 그럼 파이팅 하잔 의미로 단합도 할 겸 식사 한 번 하시죠. 이우전님 혹시 마사지 끝나고 시간 괜찮으신지요? 조장님은 바쁘시면 안 오셔도 괜찮고요ᄏ 이우전: 저 남편이랑 외식 있어서 안되겠네요~ 나영속: 아... 그래요??;; 선약 있으셨구나... 알았어요... 조별과제 발표 D-1 이우전: 저기 조장님. 산넘어: 네? 이우전: 제가 이번에 여행을 계획했는데 저희 조별과제 발표날이랑 시간이 겹치더라구요. 산넘어: 네? 여행이요? 아니 그걸 이제 말하면 어쩌라고요? 명일이 발표날인데;; 이우전: 남편이랑 결혼기념일이라 지심도에 가기로 했는데 미리 말한다는걸 망각하고 있었네요;; 산넘어: 그럼 조절하셔야죠;; 이거 기말대체잖아요.. 이우전: 아니 그럼 유람선을 벌써 예약했는데 이제와서 어떡하라구요?? 발표 끝나고 항구 갈 때까지 유람선 못 떠나게 묶어라도 두란 의미에요? 전 그래도 자료조사 담당이니까 발표할 때 굳이 전 필요 없잖아요. 산넘어: 말이 자료조사지, 온라인에 있는거 그대로 퍼와놓고 그게 할 소리에요? 진짜 예의 없으시네? 발표날 안 오면 이름 다 뺍니다? 이우전: 아니 유람선이랑 민박집 다 예약해놨는데 죄다 취소 하라구요? 취소하면 손해 본 거 조장님이 물어줄 거예요? 산넘어: 아니 그걸 제가 왜 물어줘요? 이우전님 진짜 개념 없으시네? 이우전: 아니 발표 D-DAY에 잠수타면 매너가 아니니 D-1인 금일이라도 알려드렸잖아요ᅳᅳ 그리고 고액 장학금 때문에 해당 수업 잘 받아야 하는데 이 정도 귀띰했으면 조장님도 생각이 있는 휴먼일테니 알아 먹었을거라 생각하고 명일 잘 좀 부탁드립니다ᅳᅳ 나영속: 엥? 그럼 저도 명일 다른 수업 시험 대비나 할게요. 어차피 막학기라 점수 크게 상관없기도 하고.. 그냥 우전님 오랜만에 재회하고 싶었는데 유감이네요. 조장님이 발표 좀 잘해주세요~ 산넘어: ;;;;;;;;;; 발표 당일 산넘어: 참~ 감사합니다 여러분ᅳᅳ 덕택에 금일 아주 나홀로 원맨쑈 잘했네요 ᅳᅳ+ 이우전: 그래도 조장님 덕택에 지심도에서 잘 놀고있네요. 나영속: 조장님 고생 많았네요~ 그런 의미로 식사 한 번 할까요?? 산넘어: 식사는 나영속님 혼자 실컷하시죠ᅳᅳ 금일 교수님께 있는 진실 그대로 다 보고드렸네요. 나영속: 네? 그대로 보고하셨다고요? 그래서 교수님은 뭐라시는데요? 산넘어: 뭐라시긴 뭘 뭐라셔요? 완전 대격노하셨지. 이우전: 대..대격노요?? 산넘어: 화딱지 제대로 나셨다고요. 발표날 조원들은 어디가고 왜 혼자서 발표하냐 하시길래 한 명은 남편이랑 결혼기념일이라고 지심도 가고 한 명은 다른 수업이 더 중요하다며 다른 수업 시험 대비하러 갔다하니까 즉석에서 가차없이 F때리시던데요?ᄏ 이거 어쩌나요 이우전님? 장학금 꼭 받으셔야 한다면서요?ᄏ 나영속: F면.. 점수 못 받는거 아니에요?;;; 산넘어: 재수강 하셔야죠ᄏ 근데 영속님은 막학기라면서요? 점수 부족해서 등록금 1학기 또 내고 다시 다녀야되는 거 아니에요?ᄏᄏᄏ 나영속: 저기 산조장님 제가 착각했네요..... 이번에 반드시 학점 받아서 즉시 이직해야 된단 말이에요;; 그래도 저희 같은 조인데 교수님께 말씀 좀 잘해주시면 안되겠나요?;;; 이우전: 조장님.. 저도 이번 장학금 반드시 타야돼요;; 못해도 D라도 받아야 되는데;; 조장님.. 자비 좀 베풀어 주세요..ᅲ 산넘어: 저한테 이러지 마시고 교수님 대면하고 애원하세요들ᄏ 교수님이 용서할 것 같진 않지만~ 누군 놀 줄 몰라서 빡세게 한 줄 아나ᅳᅳ 앞으로 다신 만나지 맙시다 수고요ᄏ FIN
velog
缅甸赌场《圣淘沙国际》赌场 主营:百家乐♠️ 龙虎 🐯 牛牛 🐮 手机 电脑 下载游戏app就可以和现场客户一起投注【24小时荷官在线发牌,先发牌 后下注】 ☞ ☞ 喜欢玩的加我联系方式【免费开户】 ☞ ☞ 充值提现:人名币:支付宝:缅币kbz: USDT 飞机:@hn8085 QQ :5023548 PG电子 sts2387.com 游戏网址:228612.com
Балл: 54.4Уверенность: 49%
Подробнееvelog
07 데이터 정제 - 빠진 데이터, 이상한 데이터 제거하기 결측치 정제하기 결측치란? 누락된 값, 비어 있는 값 결측치 찾기 df <- data.frame(sex=c("M","F",NA, "M","F"), score=c(5,4,3,4,NA)) df is.na(df) table(is.na(df)) table(is.na(df$sex)) mean(df$score) 결측치 제거하기 library(dplyr) df %>% filter(is.na(score)) #score가 NA인 data만 출력 df %>% filter(!is.na(score)) #결측치를 제외하고 행을 추출 df_nomiss <- df %>% filter(!is.na(score) & !is.na(sex)) df_nomiss df_nomiss2 <- na.omit(df) df_nomiss2 여러 변수 동시에 결측치가 없는 데이터를 추출하는 코드 df_nomiss <- df %>% filter(!is.na(score) & !is.na(sex)) 함수의 결측치 제외 기능 이용하기 수치 연산 함수들은 결측치를 제외하고 연산하도록 설정하는 na.rm 파라미터를 지원한다. 결측치를 제외하고 평균 산출 mean(df$score, na.rm = T) 결측치 대체하기 결측치를 다른 값을 대체하면 데이터가 손실되어 분석 결과가 왜곡되는 문제를 보완할 수 있다. mean(exam$math, na.rm = T) ## 55.23529 math가 NA면 55로 대체 exam$math <- ifelse(is.na(exam$math),55,exam$math) mean(exam$math) ## 55.2 이상치 정제하기 이상치란? 정상 범주에서 크게 벗어난 값 존재할 수 없는 값 제거하기 outlier <- data.frame(sex = c(1,2,1,3,2,1), score = c(5,4,3,4,2,6)) table(outlier$sex) ## 1 2 3 3 2 1 1이 3개, 2가 2개, 3이 1개 있다 ~ sex가 3이면 NA 할당 outlier$sex <- ifelse(outlier$sex == 3, NA, outlier$sex) 이해 어려웠던 코드 filter를 이용해 결측치를 제외한 후 성별에 따른 score 평균 구하기 outlier %>% filter(!is.na(sex) & !is.na(score)) %>% group_by(sex) %>% summarise(mean_score = mean(score)) %>%는 앞의 데이터를 뒤의 함수에 전달하는 파이프 sex를 기준으로 그룹을 나눠라.. 1그룹, 2그룹 이렇게 극단적인 값 제거하기 어디까지 정상 범위로 볼 것인가? boxplot(mpg$hwy) 아래쪽 극단치 경계, 1사분위수, 중앙값, 3사분위수, 위쪽 극단치 경계 -> 12~37을 벗어나면 극단치로 분류된다 결측 처리하기 mpg$hwy <- ifelse(mpg$hwy < 12 | mpg$hwy > 37, NA, mpg$hwy) table(is.na(mpg$hwy)) 극단치가 결측 처리된 데이터를 얻고 분석 수행 mpg %>% group_by(drv) %>% summarise(mean_hwy = mean(hwy, na.rm = T)) mpg 데이터를 가지고 다음 작업을 해라 -> drv 기준으로 그룹을 나눠 NA가 있으면 제거하고 평균을 계산해라 08 그래프 만들기 산점도 - 변수 간 관계 표현하기 산점도란? 데이터를 x축과 y축에 점으로 표현한 그래프 ggplot2 레이어 구조 (배경 설정 -> 그래프 추가 -> 설정추가) 배경설정하기 ggplot(data=mpg, aes(x=displ, y=hwy)) #mpg 데이터의 displ 변수를 x축에, hwy 변수를 y축에 놓고 배경을 설정한다 그래프 추가하기 geom_point() ggplot(data=mpg, aes(x=displ, y=hwy)) + geom_point() 축 범위를 조정하는 설정 추가하기 xlim() ylim() ggplot(data=mpg, aes(x=displ, y=hwy)) + geom_point() + xlim(3,6) #x축 범위를 3~6까지만 표현되도록 설정 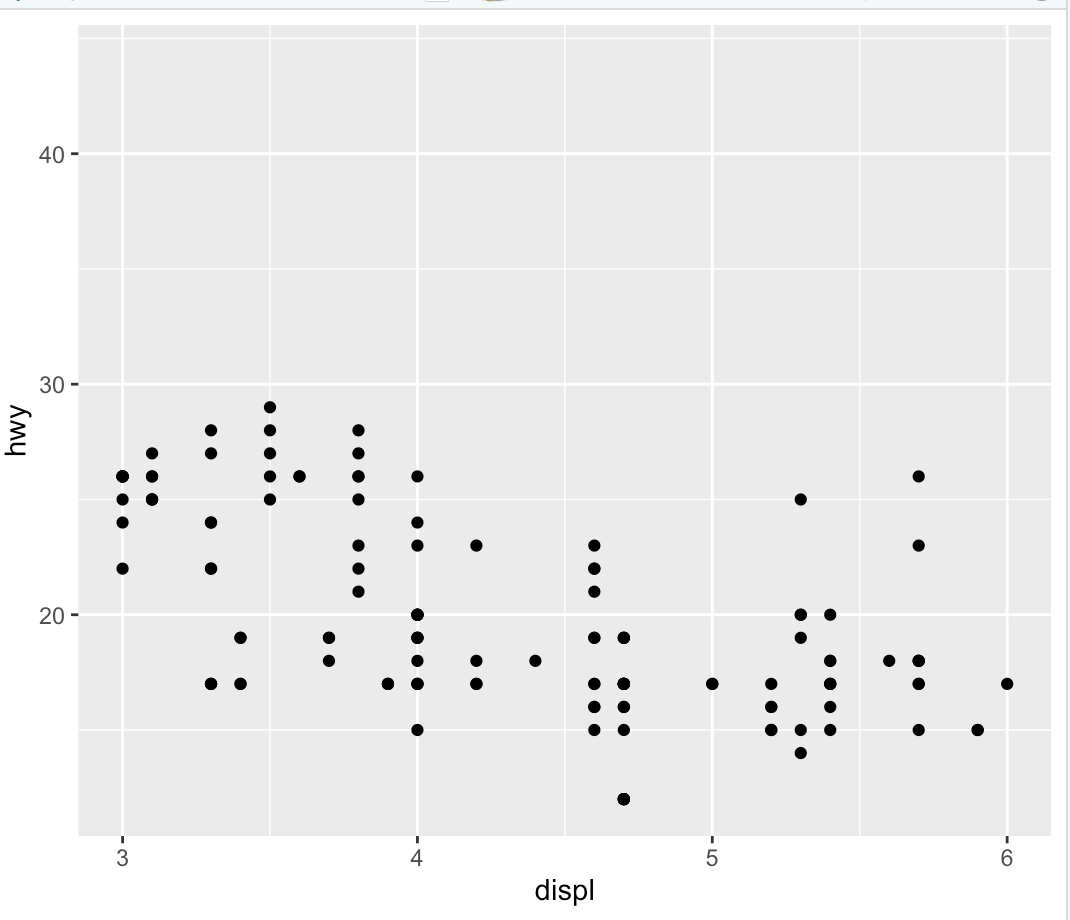 ### 막대 그래프 - 집단 간 차이 표현하기 #### 평균 막대 그래프 만들기 1. 집단별 평균표 만들기 library(dplyr) df_mpg <- mpg%>% group_by(drv) %>% summarise(mean_hwy = mean(hwy)) df_mpg 2. 그래프 생성하기 ggplot(data=df_mpg, aes(x=drv, y=mean_hwy)) +geom_col() 3. 크기 순으로 정렬하기 ggplot(data=df_mpg, aes(x=reorder(drv, -mean_hwy), y=mean_hwy)) +geom_col() 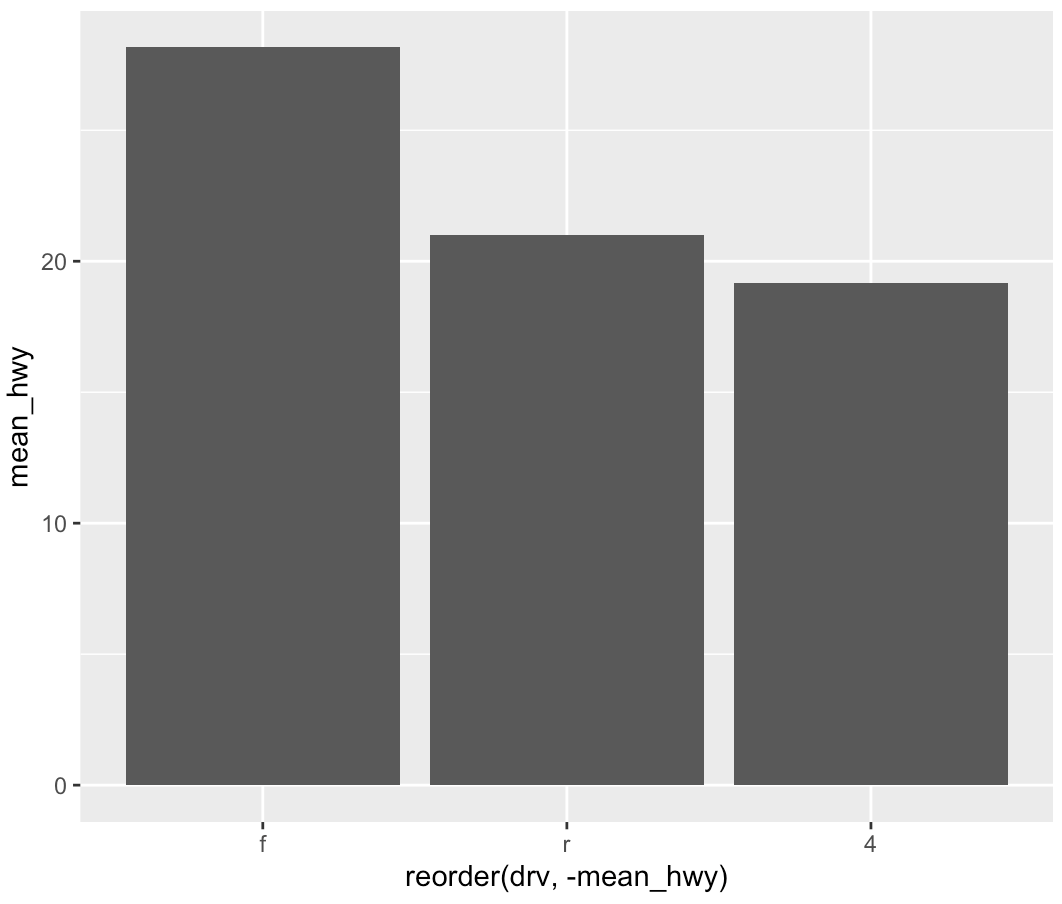 ### 선 그래프 - 시간에 따라 달라지는 데이터 표현하기 geom_line() 추가하기 ggplot(data=economics, aes(x=date, y=unemploy))+geom_line() > geom_col() 막대그래프 - 요약표 geom_bar() 막대그래프 - 원자료 geom_line() 선 그래프 geom_boxplot() 상자 그림
velog
문제 소개 프로그래머스 Lv.1 · 예산 부서마다 물품 구매에 필요한 신청 금액이 배열 d 로 주어지고, 회사의 전체 예산은 budget 이다. 각 부서에는 신청한 금액을 전부 주거나 아예 주지 않아야 하며, 일부만 지원할 수는 없다. 예산 안에서 최대 몇 개 부서를 지원할 수 있는지 구하는 문제다. 부서 수는 최대 100개, 신청 금액은 최대 100,000, 예산은 최대 10,000,000이다. 접근 방법 지원하는 부서의 개수만 최대로 만들면 되므로, 금액이 작은 부서부터 지원하는 것이 가장 유리하다. 같은 예산이라면 적은 금액을 쓸수록 남는 돈으로 더 많은 부서를 지원할 수 있기 때문이다. d 를 오름차순으로 정렬한다. 앞에서부터 차례로 보면서, 신청 금액이 남은 예산 이하이면 예산에서 빼고 지원 개수를 1 늘린다. 끝까지 돈 뒤 개수를 반환한다. 정렬해 두었기 때문에 한 번 예산이 모자란 순간부터는 뒤에 있는 금액도 전부 모자란다. 그래서 조건이 처음 실패할 때 break 로 반복을 끝내도 결과는 같다. 풀이 코드 import java.util.Arrays; class Solution { public int solution(int[] d, int budget) { int answer = 0; Arrays.sort(d); for (int i = 0; i < d.length; i++) { if(d[i] <= budget) { budget -= d[i]; answer++; } } return answer; } } 시간 복잡도 O(n log n). 정렬에 O(n log n)이 들고, 이후 배열을 한 번 순회하는 데 O(n)이 든다. 배운 점 배열을 정렬해 두면 이 문제를 간단하게 풀 수 있다는 것을 알게 됐다. 작은 금액부터 차례로 고르기만 하면 되기 때문이다.
Балл: 54.4Уверенность: 49%
Подробнееvelog
들어가며 LLM을 활용한 AI 에이전트 개발 입문」 수업 · 교재 『Do it! LLM을 활용한 AI 에이전트 개발 입문 5장~6장 실습 기록 이번 글은 5장과 6장을 묶어 정리합니다. 5장은 녹음 파일로 회의록을 만드는 AI 서기 , 6장은 이미지를 분석해 퀴즈와 듣기 문제를 만드는 AI 이미지 분석가 입니다. 5장은 소리를 글자로, 6장 마지막은 글자를 소리로 바꾸는 흐름이라 이어서 보면 재미있습니다. 일부 결과 화면은 교재 출력을 바탕으로 재구성했습니다. 전체 진행 순서 5장 AI 서기 openai_api_whisper.ipynb : 위스퍼 API로 음성 → 텍스트 huggingface_whisper.ipynb : 위스퍼 모델을 로컬에서 실행, 시간대별 문장을 CSV로 저장 speaker_diarization.ipynb : pyannote로 화자 분리 whisper_stt.py : 받아쓰기와 화자 분리를 합치는 파일 summarize_and_correct.ipynb : GPT로 요약·교정, 마크다운·워드 출력 6장 AI 이미지 분석가 image_explanation.ipynb : GPT 비전으로 이미지 설명, 한계 확인 image_quiz.py : 이미지 퀴즈와 영어 듣기 문제 출제 tts.ipynb : 영어 문제를 TTS로 MP3 만들기 project_agent_20260305/ ├── chap05/ │ ├── audio/ │ │ ├── lsy_audio_2023_58s.mp3 ← 1분짜리 강의 녹음 │ │ └── 싼기타_비싼기타.mp3 ← 두 사람의 토론 녹음 │ ├── openai_api_whisper.ipynb │ ├── huggingface_whisper.ipynb │ ├── speaker_diarization.ipynb │ ├── whisper_stt.py │ └── sec04/summarize_and_correct.ipynb ├── chap06/ │ ├── data/ ← 분석할 이미지, 퀴즈 결과 파일 │ ├── image_explanation.ipynb │ ├── image_quiz.py │ └── tts.ipynb └── venv/ 1. 위스퍼 API로 음성을 텍스트로 — openai_api_whisper.ipynb 실습 음성( lsy_audio_2023_58s.mp3 )은 교재 깃허브에서 받아 chap05/audio 에 넣었습니다. 이번 장부터는 셀 단위로 실행하고 결과를 바로 볼 수 있는 주피터 노트북 을 씁니다. VS Code에서 .ipynb 파일을 만들고 Select Kernel 에서 venv 를 고르면 되고, 처음 실행할 때 나오는 ipykernel 설치 안내는 [Install]을 누르면 됩니다. 클라이언트 준비 from openai import OpenAI from dotenv import load_dotenv import os load_dotenv() api_key = os.getenv('OPENAI_API_KEY') client = OpenAI(api_key=api_key) .env 의 API 키로 OpenAI 클라이언트를 만듭니다. 노트북은 실행한 셀의 변수가 남아 있어서, 한 번만 실행해 두면 아래 셀에서 client 를 계속 쓸 수 있습니다. MP3를 텍스트로 audio_file_path = './audio/lsy_audio_2023_58s.mp3' # MP3 파일 경로 입력 with open(audio_file_path, 'rb') as audio_file: transcription = client.audio.transcriptions.create( model="whisper-1", file=audio_file ) transcription 음성 파일은 바이너리라 'rb' 모드로 열고, client.audio.transcriptions.create() 에 whisper-1 모델과 파일을 넘기면 받아쓰기 결과가 옵니다. 결과가 한 줄로 길게 나와서 textwrap 으로 60자씩 줄바꿈해 출력하도록 바꿨습니다. from openai import OpenAI from dotenv import load_dotenv import os import textwrap load_dotenv() api_key = os.getenv("OPENAI_API_KEY") client = OpenAI(api_key=api_key) audio_file_path = './audio/lsy_audio_2023_58s.mp3' with open(audio_file_path, 'rb') as audio_file: transcript = client.audio.transcriptions.create( file=audio_file, model="whisper-1" ) # 결과 출력 # print(transcript.text) # 결과 출력 (문단 형태) text = transcript.text formatted_text = "\n\n".join( textwrap.fill(paragraph, width=60) for paragraph in text.split("\n\n") ) print(formatted_text) transcript.text 로 글자만 꺼내고, textwrap.fill(width=60) 으로 줄을 맞춥니다. 1분짜리 음성이 몇 초 만에 거의 정확한 문장으로 나왔습니다. 번역하며 받아쓰기 import textwrap # Open audio file and request transcription (translation to English) with open(audio_file_path, 'rb') as audio_file: transcription = client.audio.translations.create( file=audio_file, model="whisper-1" ) # Extract text from transcription result text = transcription.text # (Fixed: transcript → transcription) # Format text into paragraphs with max 60 characters per line formatted_text = "\n\n".join( textwrap.fill(paragraph, width=60) for paragraph in text.split("\n\n") ) # Print formatted result print(formatted_text) transcriptions 를 translations 로 바꾸면 한국어 음성이 영어 텍스트로 나옵니다. 주석의 (Fixed: ...) 는 변수 이름을 잘못 써서 NameError 가 났던 걸 고친 흔적입니다. 참고 translations 는 영어로 번역하는 것만 지원합니다. 2. 위스퍼를 로컬에서 실행 — huggingface_whisper.ipynb API는 쓸 때마다 요금이 나가서, 이번에는 허깅페이스에서 openai/whisper-large-v3-turbo 모델을 내려받아 내 컴퓨터에서 돌려 봅니다. 패키지 설치 %pip install --upgrade pip %pip install --upgrade transformers datasets[audio] accelerate %pip 은 노트북의 현재 커널(venv)에 설치하는 명령입니다. 모델 실행용 transformers , 오디오 처리용 datasets[audio] , 메모리 최적화용 accelerate 를 설치합니다. 이 상태로 예제를 실행하면 FFMPEG가 없다는 오류가 납니다. FFMPEG 경로 등록 https://www.gyan.dev/ffmpeg/builds 에서 ffmpeg-git-full.7z 를 받아 압축을 풀고, bin 폴더를 PATH에 추가합니다. import os os.environ["PATH"] += os.pathsep + r"C:\github\gpt_agent_2025_book\ffmpeg-2025-01-22-full_build\bin" 지금 커널에서만 유효해서 커널을 재시작하면 다시 실행해야 합니다. 경로는 본인이 압축을 푼 위치로 바꿔 주세요. 모델 실행 import torch from transformers import AutoModelForSpeechSeq2Seq, AutoProcessor, pipeline # from datasets import load_dataset device = "cuda:0" if torch.cuda.is_available() else "cpu" torch_dtype = torch.float16 if torch.cuda.is_available() else torch.float32 model_id = "openai/whisper-large-v3-turbo" model = AutoModelForSpeechSeq2Seq.from_pretrained( model_id, torch_dtype=torch_dtype, low_cpu_mem_usage=True, use_safetensors=True ) model.to(device) processor = AutoProcessor.from_pretrained(model_id) pipe = pipeline( "automatic-speech-recognition", model=model, tokenizer=processor.tokenizer, feature_extractor=processor.feature_extractor, torch_dtype=torch_dtype, device=device, return_timestamps=True, chunk_length_s=10, stride_length_s=2, ) # dataset = load_dataset("distil-whisper/librispeech_long", "clean", split="validation") # sample = dataset[0]["audio"] sample = "./audio/lsy_audio_2023_58s.mp3" result = pipe(sample) # print(result["text"]) print(result) 허깅페이스 예제에서 바꾼 부분은 파이프라인 옵션 세 개입니다. return_timestamps=True : 문장마다 시작·끝 시간을 함께 받습니다. 뒤에서 화자 분리와 맞출 때 필요합니다. chunk_length_s=10 : 음성을 10초씩 잘라 처리합니다. stride_length_s=2 : 조각이 2초씩 겹치게 해서 경계에서 단어가 잘리는 걸 줄입니다. GPU가 있으면 cuda , 없으면 cpu 로 돌아갑니다. 실행하니 이번에는 No module named 'torch' 오류가 나서, pytorch.org에서 안내하는 명령으로 파이토치를 설치했습니다. (venv) > pip3 install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu121 GPU가 없다면 사이트에서 CPU 를 골라 나오는 명령을 쓰면 됩니다. 설치 후 실행하면 전체 텍스트와 시간대별 조각( chunks )이 함께 나옵니다. chunks를 CSV로 저장 # chunks를 CSV 파일로 저장 start_end_text = [] for chunk in result["chunks"]: start = chunk["timestamp"][0] end = chunk["timestamp"][1] text = chunk["text"] start_end_text.append([start, end, text]) import pandas as pd df = pd.DataFrame(start_end_text, columns=["start", "end", "text"]) df.to_csv("lsy_audio_2023_58.csv", index=False, sep="|") display(df) 조각마다 [시작, 끝, 문장] 을 모아 데이터프레임으로 만들고 저장합니다. 문장에 쉼표가 들어갈 수 있어서 구분자는 | 를 썼습니다. 3. 화자 분리 — speaker_diarization.ipynb 받아쓰기만으로는 누가 말했는지 알 수 없어서, pyannote/speaker-diarization-3.1 모델로 화자를 나눕니다. 약관 동의가 필요한 모델이라 허깅페이스에서 액세스 토큰 을 만들고 모델 페이지에서 동의해야 합니다. 설치 %pip install pyannote.audio %pip install numpy==1.26 pyannote가 numpy 2.x와 맞지 않아서 numpy==1.26 으로 고정했습니다. 파이프라인 불러오기 # instantiate the pipeline from pyannote.audio import Pipeline pipeline = Pipeline.from_pretrained( "pyannote/speaker-diarization-3.1", use_auth_token="HUGGINGFACE_ACCESS_TOKEN_GOES_HERE" ) # CUDA를 사용할 수 있다면 CUDA를 사용하도록 설정 if torch.cuda.is_available(): pipeline.to(torch.device("cuda")) print('cuda is available') else: print('cuda is not available') use_auth_token 에 발급한 토큰을 넣습니다. 이 셀은 torch 를 쓰는데 import가 없으니, 새로 시작했다면 import torch 를 먼저 해 주세요. 실행하니 아래 오류가 났습니다. Could not download 'pyannote/segmentation-3.0' model. It might be because the model is private or gated so make sure to authenticate. ... AttributeError: 'NoneType' object has no attribute 'eval' 3.1 모델이 내부에서 쓰는 pyannote/segmentation-3.0 모델에도 따로 동의해야 했습니다. 해당 페이지에서 [Agree and access repository]를 누르면 해결됩니다. 주의 토큰은 비밀번호와 같아서, 깃허브에 올릴 때는 .env 로 빼 두는 게 안전합니다. 화자 분리 실행 # run the pipeline on an audio file diarization = pipeline("./audio/싼기타_비싼기타.mp3") # dump the diarization output to disk using RTTM format with open("./audio/싼기타_비싼기타.rttm", "w", encoding='utf-8') as rttm: diarization.write_rttm(rttm) 토론 음성 싼기타_비싼기타.mp3 로 실행하고 결과를 RTTM 파일로 저장합니다. 한 줄은 "몇 초부터 몇 초 동안 누가 말했는지"입니다. 네 번째 값이 시작 시간, 다섯 번째 값이 길이 입니다. 판다스로 정리 import pandas as pd rttm_path = "./audio/싼기타_비싼기타.rttm" df_rttm = pd.read_csv( rttm_path, # rttm 파일 경로 sep=' ', # 구분자는 띄어쓰기 header=None, # 헤더는 없음 names=['type', 'file', 'chnl', 'start', 'duration', 'C1', 'C2', 'speaker_id', 'C3', 'C4'] ) display(df_rttm) 띄어쓰기로 구분된 RTTM을 읽고, 열 이름을 직접 붙였습니다. # start + duration을 end로 변환 df_rttm['end'] = df_rttm['start'] + df_rttm['duration'] display(df_rttm) 끝 시간이 없으니 시작 + 길이로 만듭니다. df_rttm["number"] = None # number 열 만들고 None으로 초기화 df_rttm.at[0, "number"] = 0 display(df_rttm) for i in range(1, len(df_rttm)): if df_rttm.at[i, "speaker_id"] != df_rttm.at[i-1, "speaker_id"]: df_rttm.at[i, "number"] = df_rttm.at[i-1, "number"] + 1 else: df_rttm.at[i, "number"] = df_rttm.at[i-1, "number"] display(df_rttm.head(10)) 같은 사람이 이어서 말한 줄은 같은 번호, 화자가 바뀌면 번호를 1 올립니다. 숨 쉬는 틈마다 쪼개진 줄을 발언 차례 단위로 묶기 위한 준비입니다. df_rttm_grouped = df_rttm.groupby("number").agg( start=pd.NamedAgg(column='start', aggfunc='min'), end=pd.NamedAgg(column='end', aggfunc='max'), speaker_id=pd.NamedAgg(column='speaker_id', aggfunc='first') ) display(df_rttm_grouped) 번호별로 묶어서 시작은 최솟값, 끝은 최댓값, 화자는 첫 값을 씁니다. df_rttm_grouped["duration"] = df_rttm_grouped["end"] - df_rttm_grouped["start"] df_rttm_grouped = df_rttm_grouped.reset_index(drop=True) display(df_rttm_grouped) df_rttm_grouped.to_csv( "./audio/싼기타_비싼기타_rttm.csv", sep=',', index=False ) 발화 시간을 다시 계산하고 인덱스를 정리해 CSV로 저장합니다. 4. 받아쓰기 + 화자 분리 합치기 — whisper_stt.py 노트북에서 확인한 기능을 함수로 묶은 최종 파일입니다. 전체 코드 import os import torch import pandas as pd from transformers import AutoModelForSpeechSeq2Seq, AutoProcessor, pipeline from pyannote.audio import Pipeline os.environ["PATH"] += os.pathsep + r"C:\github\gpt_agent_2025_book\ffmpeg-2025-01-22-full_build\bin" # 자신이 설치한 위치로 경로 수정 def whisper_stt( audio_file_path: str, output_file_path: str = "./output.csv" ): device = "cuda:0" if torch.cuda.is_available() else "cpu" torch_dtype = torch.float16 if torch.cuda.is_available() else torch.float32 model_id = "openai/whisper-large-v3-turbo" model = AutoModelForSpeechSeq2Seq.from_pretrained( model_id, torch_dtype=torch_dtype, low_cpu_mem_usage=True, use_safetensors=True ) model.to(device) processor = AutoProcessor.from_pretrained(model_id) pipe = pipeline( "automatic-speech-recognition", model=model, tokenizer=processor.tokenizer, feature_extractor=processor.feature_extractor, torch_dtype=torch_dtype, device=device, return_timestamps=True, # 청크별로 타임스탬프를 반환 chunk_length_s=10, # 입력 오디오를 10초씩 나누기 stride_length_s=2, # 청크가 2초씩 겹치도록 나누기 ) result = pipe(audio_file_path) df = whisper_to_dataframe(result, output_file_path) return result, df def whisper_to_dataframe(result, output_file_path): s
Балл: 54.4Уверенность: 49%
Балл: 54.4Уверенность: 49%
Балл: 54.4Уверенность: 49%