자동화는 코드가 아니라 업무 관찰에서 시작한다 자동화할 업무를 고르는 법 한 줄 요약 "코드로 만들 수 있을까?"보다 먼저 "이 업무에서 사람이 반복해서 내리는 판단은 무엇인가?" 를 물어야 한다. 게이트 3문항으로 걸러내고, 4가지 기준으로 평가한 뒤, 오류 비용에 맞춰 자동화 수준 을 정하면 만들고도 안 쓰이는 도구를 줄일 수 있다. i️ 이 글은 특정 회사나 서비스와 무관한 일반 방법론 입니다. 예시 업무는 모두 가상 이고, 숫자는 설명을 위한 가정 값입니다. 들어가며 반복 업무를 보면 자동화 욕심이 생깁니다. 그런데 막상 만들고 나면 이런 일이 자주 생깁니다. 만들었는데 아무도 쓰지 않는다 예외가 계속 나와서 수정에 더 많은 시간 이 든다 절감한 시간보다 만드는 데 쓴 시간 이 더 길다 만든 사람이 자리를 비우자 아무도 고치지 못한다 원인은 대부분 기술이 아니라 대상 선정 입니다. 어떤 업무를 자동화할지, 어느 수준까지 자동화할지를 먼저 정하지 않았기 때문입니다. 1. 먼저 손익을 계산해 본다 자동화에는 비용이 듭니다. 감이 아니라 대략이라도 계산해 보세요. 주당 절감 시간 = 1회 소요 시간 × 주당 횟수 × 사용자 수 손익분기(주) = 개발 시간 ÷ 주당 절감 시간 가정 예시입니다. 1회 40분 걸리는 업무를 주 2회, 한 명이 한다면 주당 80분을 절약합니다. 개발에 12시간(720분)이 들면 손익분기는 약 9주 입니다. 여기에 숨은 비용을 더하면 더 길어집니다. 숨은 비용 내용 예외 처리 규칙에 안 맞는 건을 따로 다루는 시간 유지보수 입력 형식·규칙이 바뀔 때마다 수정 권한·보안 접근 권한 관리, 키 관리, 점검 문서화·인수인계 만든 사람 외에도 쓸 수 있게 하는 시간 반대로 시간 외의 가치도 있습니다. 오류 감소 , 지연 감소 , 특정 사람에 대한 의존 감소 가 그 예입니다. 이런 가치는 숫자로 환산하기 어려우니 별도 항목으로 적어 두세요. 2. 업무를 먼저 관찰하고 분해한다 코드를 쓰기 전에 업무를 네 칸으로 나눕니다. 칸 질문 입력 어디서 오는가? 형식이 정해져 있는가? 처리 어떤 규칙으로 변환·계산하는가? 사람이 판단하는 부분은 어디인가? 출력 결과물은 무엇이고 누가 받는가? 후속 행동 결과를 받은 사람이 무엇을 하는가? 처리 상태는 어디에 남는가? 그리고 두 가지를 실제로 해봅니다. 한 번 직접 수행하며 단계를 기록 합니다. 머릿속 절차와 실제 절차는 다릅니다. 최근 20건 정도를 모아 예외가 몇 건인지 셉니다. 예외 비율이 규칙성의 가장 솔직한 지표입니다. 3. 선정 방법: 게이트 → 평가 → 판정 1 게이트 3문항 (하나라도 No면 보류) 질문 No라면 도구를 유지할 오너 가 있는가? 만든 사람이 떠나면 방치된다. 오너부터 정한다 프로세스가 한동안 안정적 인가? 곧 바뀔 업무를 자동화하면 폐기물이 된다. 안정화 후에 한다 결과를 검증할 방법 이 있는가? 틀려도 모르는 자동화는 위험하다. 검증 기준부터 만든다 2 4가지 기준으로 평가 기준 상 중 하 빈도 주 1회 이상 월 1~3회 분기에 1회 이하 소요 시간 1회 1시간 이상 20분~1시간 20분 미만 규칙성 기준이 명문화되고 예외가 적다 기준은 있으나 예외가 꽤 있다 사람마다 판단이 다르다 입력 정형성 표·폼처럼 구조화되어 있다 일부 정리가 필요하다 자유 서술, 이미지, 스캔본 여기에 오류 비용 (틀리면 얼마나 아픈가)을 따로 봅니다. 이 항목은 점수가 아니라 자동화 수준 을 정하는 데 씁니다. (4장에서 설명합니다) 3 판정 평가 결과 판정 빈도·소요 시간 높음 + 규칙성·입력 정형성 높음 규칙 기반 자동화 빈도·소요 시간 높음 + 입력이 비정형 (규칙으로 쓰기 어려움) AI 보조 + 사람 확인 빈도·소요 시간 높음 + 판단 기준이 사람마다 다름 기준·프로세스 정리가 먼저 빈도가 낮거나 소요 시간이 짧음 자동화하지 않고 체크리스트로 가상의 업무 네 가지에 적용해 보면 이렇습니다. 업무 (가상) 빈도 소요 규칙성 입력 오류 비용 판정 주간 실적 취합·리포트 작성 상 상 상 상 중 규칙 기반 자동화 문의 메일 1차 분류 상 중 하 하 하 AI 보조 + 사람 확인 담당자마다 방식이 다른 월간 보고 중 상 하 중 중 기준 정리가 먼저 연 1회 감사 대응 자료 정리 하 상 중 중 상 체크리스트로 충분 💡 세 번째 업무가 중요한 사례입니다. 기준이 사람마다 다른 업무를 자동화하면, 그 혼란이 그대로 빠르게 반복됩니다. 자동화는 나쁜 프로세스를 고쳐 주지 않고 더 빠르게 만들 뿐입니다. 4. 자동화 수준을 정한다 "자동화할 것인가 말 것인가"의 이분법이 아니라 어디까지 맡길 것인가 를 정합니다. 수준 설명 사람의 역할 L0 수동 전부 사람이 한다 전부 L1 문서화 절차를 체크리스트·템플릿으로 정리한다 실행과 판단 L2 반자동 도구가 집계·초안을 만들고 사람이 확인·승인한다 확인과 승인 L3 자동 + 예외 알림 도구가 실행하고 예외만 사람에게 넘긴다 예외 처리 L4 완전 자동 사람 개입 없이 실행하고 로그만 남긴다 주기적 점검 오류 비용이 수준을 결정합니다. 오류 비용 권장 수준 낮음 (틀려도 쉽게 고침) L3 이상 중간 L2~L3 (결과를 확인하는 단계 유지) 높음 (금전·신뢰·법적 문제) L2 이하. 최종 승인은 사람이 한다 대부분의 업무에서 L2~L3이 가장 현실적 입니다. 처음부터 L4를 목표로 하면 예외 처리 때문에 끝나지 않는 프로젝트가 됩니다. AI는 어디에 쓰는가 작업 규칙으로 AI로 정해진 형식의 표 계산·변환 ✅ ❌ (결정적이고 싸고 검증이 쉽다) 자유 서술 분류·요약·정보 추출 ❌ (규칙으로 쓰기 어렵다) ✅ (단, 사람 확인 포함) 금액·수량 같은 정확도가 필수인 계산 ✅ ❌ (결과가 매번 다를 수 있다) 초안 작성 △ ✅ (사실 확인은 사람이) 규칙으로 되는 일에 AI를 쓰면 비용이 늘고 결과를 재현하기 어려워집니다. AI는 규칙으로 못 푸는 비정형 입력에 쓰고, 그 결과는 반드시 검증 단계를 거치게 하세요. 5. 만들 때 지킬 설계 원칙 원본을 보존하고 로그를 남깁니다. 결과가 이상할 때 되짚을 수 있어야 합니다. 입력을 구조화합니다. 자유 메시지 대신 정해진 양식으로 받으면 오류의 절반이 사라집니다. 예외를 숨기지 않고 사람에게 넘깁니다. 처리 못 한 건을 조용히 버리는 자동화가 가장 위험합니다. 가장 흔한 케이스부터 만듭니다. 전체의 70~80%를 덮고, 나머지는 예외 큐로 보냅니다. 규칙과 코드를 분리합니다. 기준이 바뀔 때 코드가 아니라 설정 파일이나 표만 고치게 합니다. 되돌릴 수 있게 만듭니다. 실행 전 미리보기, 중복 실행해도 문제없는 구조를 선호합니다. 권한은 최소로, 키는 코드 밖에 둡니다. 접근 정보를 코드에 직접 넣지 않습니다. 오너와 문서를 지정합니다. 개인 PC에서만 도는 스크립트는 자동화가 아니라 개인 습관입니다. 6. 도입 후에 할 일 전후를 측정합니다. 소요 시간, 오류 발생 건수, 예외 비율, 실제 사용 횟수를 기록하세요. 추정치와 실측치를 구분해서 말합니다. "약 N분 줄 것으로 추정"과 "실측 N분 감소"는 다른 말입니다. 범위로 말하고, 업무 조건에 따라 달라진다는 점을 함께 적으세요. 2~4주 뒤 사용 현황을 점검합니다. 쓰이지 않는다면 이유를 묻고, 개선하거나 폐기합니다. 규칙이 바뀔 때의 대응 절차를 정합니다. 누가 언제 수정하는지 미리 정해 두세요. 7. 흔한 안티패턴 안티패턴 문제 처방 사용자 없이 만든다 만들고 나서 안 쓴다 업무 담당자와 함께 관찰하고, 초기 버전을 같이 써 본다 일회성 업무를 자동화한다 손익분기가 오지 않는다 빈도 기준을 먼저 본다 예외를 무시한다 자동화가 오히려 오류를 늘린다 예외 비율을 측정하고 예외 큐를 만든다 블랙박스로 만든다 결과를 검증할 수 없다 중간 산출물과 로그를 남긴다 AI를 과하게 쓴다 비용·비재현성·오류가 늘어난다 규칙으로 되는 곳은 규칙으로 절감 시간을 과장한다 신뢰를 잃는다 실측과 추정을 구분한다 프로세스를 안 고치고 자동화한다 나쁜 방식이 굳는다 기준 정리를 먼저 한다 8. 체크리스트 도구를 유지할 오너가 있는가 프로세스가 당분간 안정적인가 결과를 검증할 방법이 있는가 직접 한 번 수행하며 단계를 기록했는가 최근 건을 모아 예외 비율을 확인했는가 빈도 · 소요 시간 · 규칙성 · 입력 정형성을 평가했는가 손익분기(개발 시간 ÷ 주당 절감 시간)를 대략 계산했는가 오류 비용에 맞는 자동화 수준(L2~L3 등)을 정했는가 규칙으로 되는 곳과 AI가 필요한 곳을 구분했는가 원본 보존, 로그, 예외 큐, 설정 분리를 설계에 넣었는가 도입 전후 측정 방법과 점검 날짜를 정했는가 마무리 좋은 자동화는 사람이 하던 일을 없애는 것이 아니라, 반복적인 조회와 전달을 줄이고 사람이 판단과 처리에 집중할 수 있게 만드는 일입니다. 그러려면 만들기 전에 두 가지를 먼저 답해야 합니다. "이 업무는 자동화할 가치가 있는가?" 그리고 "어디까지 맡길 것인가?"
공부 기록 1. 마진과 서포트 벡터 분류 학습의 가장 기본적인 아이디어: 클래스를 잘 나누는 결정 경계/초평면 찾는 것 ⇒ 새로운 데이터에 대해서도 견고한 경계 서포트 벡터: 결정 경계와 가장 가까운 값 마진: 결정 경계(직선)와 서포트 벡터(점) 사이의 거리 → 점과 직선 사이의 거리 결정 경계에서 양쪽 서포트 벡터로의 거리는 같다 (→ 하나만 구해서 x2 해도 됨) 마진은 클수록 좋음 → 데이터가 잘 벌어져 있다 → 분류를 잘한다 ⇒ 마진을 최대화 하는 결정 경계를 구해보자 2. 수학적 모델링 초평면 어떤 n차원 공간에서 한 차원 낮은 n-1 차원의 subspace ex1) 3차원 공간에서 초평면: 면, 2차원 공간에서 초평면: 선 ex2) *전제: 벡터의 크기(길이)가 1이여함 법선 벡터 $w = [w_1, w_2]^T$ 에 대해 원점과의 거리가 $d$인 직선의 방정식 → 법선 벡터는 직선과 수직임 (2차원) 법선 벡터 $w = [w_1, w_2, w_3]^T$ 에 대해 원점과의 거리가 $d$인 직선의 방정식 → 법선 벡터는 평면과 수직 (3차원 일반적으로 선형방정식으로 묘사 됨 (*차원에 따라 $w$의 개수는 달라짐) $$ W^Tx+b =0 $$ w=[w_1, w_2, w_3]^T: 법선 벡터 → 초평면의 방향 결정 (수직 방향) b: 초평면과 원점과의 거리 (법선 벡터의 크기가 1일 때만 성립) 이때 점 x에서 초평면까지의 거리 d → 점과 직선 사이의 거리 공식 $$ d= \frac{|w^Tx+b|}{||w||} $$ 초평면만 주어지면 거리 구할 수 있는 이유 (수업 필기 내용) ⇒ 만약 선형 분류가 가능하다고 가정한다면 위와 같은 초평면 $\mathbf {(w^T+b=0)}$ 이 존재한다. $y_i =1$ 이면 $\mathbf {(w^T+b>0)}$ 이고, $y_i =0$ 이면 $\mathbf {(w^T+b<0)}$ 이다. ⇒ 초평면의 양쪽을 가장 가까운 샘플인 서포트 벡터와 거리를 같게 가정함 ($\delta$는 거리에 해당함) 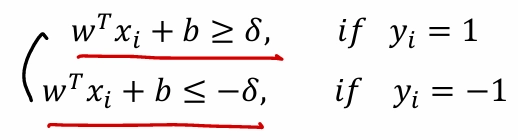 스케일링 (양변을 $\delta$로 나눔) 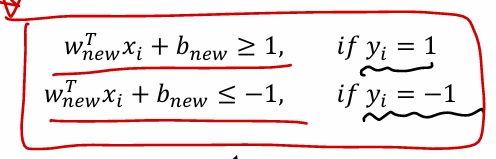 - **등호는 서포트 벡터에서 성립함** - 선형 분리가 가능하다고 가정했으므로 이런 부등식을 만족시키는 **$w^T_{new}, b_{new}$가 항상 존재함** 그림 임의의 점 x에서 초평면까지의 거리 d $$ x $$ 마진: 초평면과 서포트벡터 사이의 거리 → 최대화 해야함 $$ d_{x_0}=\frac{|w^Tx_0+b|}{||w||} =\frac{1}{||w||} $$ $$ d_{x_1}=\frac{|w^Tx_1+b|}{||w||} =\frac{1}{||w||} $$ $$ margin = \frac {2}{||w||} $$ 최적화 문제 최적화 문제로 바꾸려면 마진에 역수 취하면 됨 → 최소화 문제로 바뀜 !image.png 제곱한 이유: 해를 구하기 더 쉽기 때문 라그랑주 함수는 그냥 참고용 닫힌해 항상 존재 → 데이터만 같다면 항상 같은 해 도출 S.V 만 안바뀌면 SVM은 항상 고정 S.V 바뀌면 SVM도 바뀜 3. 변형 ;우리에게 주어진 데이터가 선형 분리 안될 때 소프트 마진(↔ 하드 마진) 몇몇의 샘플들에 대해서는 조건식을 만족하지 않아도 되도록 함 조건식을 만족하지 않는 경우 $y_i =0 → w^Tx + b > 0$ 위에 손실 함수 미분 불가능 → 대리 손실 찾아야함 ⇒ 볼록이고 연속인 함수 사용 커널 트릭 차원 뻥튀기 → 고차원 공간에서 선형적으로 분리할 수 있다고 가정하고, 고차원 내적을 직접 계산하지 않고 원래 차원에서 간접적으로 계산 $$ K(x,x') = \phi(x)^T\phi(x') $$ 4. 서포트 벡터 회귀 초평면을 회귀식으로 사용 !image.png !image.png
공부 기록 선형 회귀 기본 형식 지도 학습 선형 모델: 속성들의 선형 조합을 통해 예측하는 함수를 학습하는 모델 독립변수 x로 종속변수 y를 예측하는 모델 $$ f(\mathbf x) = \mathbf \beta_1x_1 + \beta_2x_2 + {...} + \beta_nx_n+b = \beta^T\mathbf x+\mathbf b $$ b를 $\beta$ 에 포함해서 표현할 수도 있다. $\beta, b$: 학습을 통해 얻어야하는 파라미터 학습 방법 선형 회귀의 손실함수: 일반적으로 MSE(평균 제곱 오차) 사용 최소제곱법 입력 데이터가 하나인 경우 (*이런 경우는 거의 음슴.. 속성은 여러 개인 경우가 훨씬 많으니..) $f(x_i) =\beta_ix_i+b$ $MSE = \frac 1m\sum\limits_{i=1}^m(y_i-\beta x_i-b)^2$ $\beta, b$를 찾는 것은 $\frac 1m\sum\limits_{i=1}^m(y_i-\beta x_i-b)^2$를 최소화 하는 과정임. $E_{(\beta, b)} = \frac 1m\sum\limits_{i=1}^m(y_i-\beta x_i-b)^2$ 을 손실 함수로 쓰는 이유 → 볼록 함수 이기 때문에 미분해서 0되는 지점이 최소점임을 알 수 있기 때문 해당 손실 함수가 볼록함수인 것 증명 방법 1. $(y_i-\beta x_i-b)^2$ **각각이 볼록함수임을 증명,** 2. **그것들의 합이 볼록함수임을 증명 ⇒ 볼록함수의 합은 볼록이다.** 증명 필기 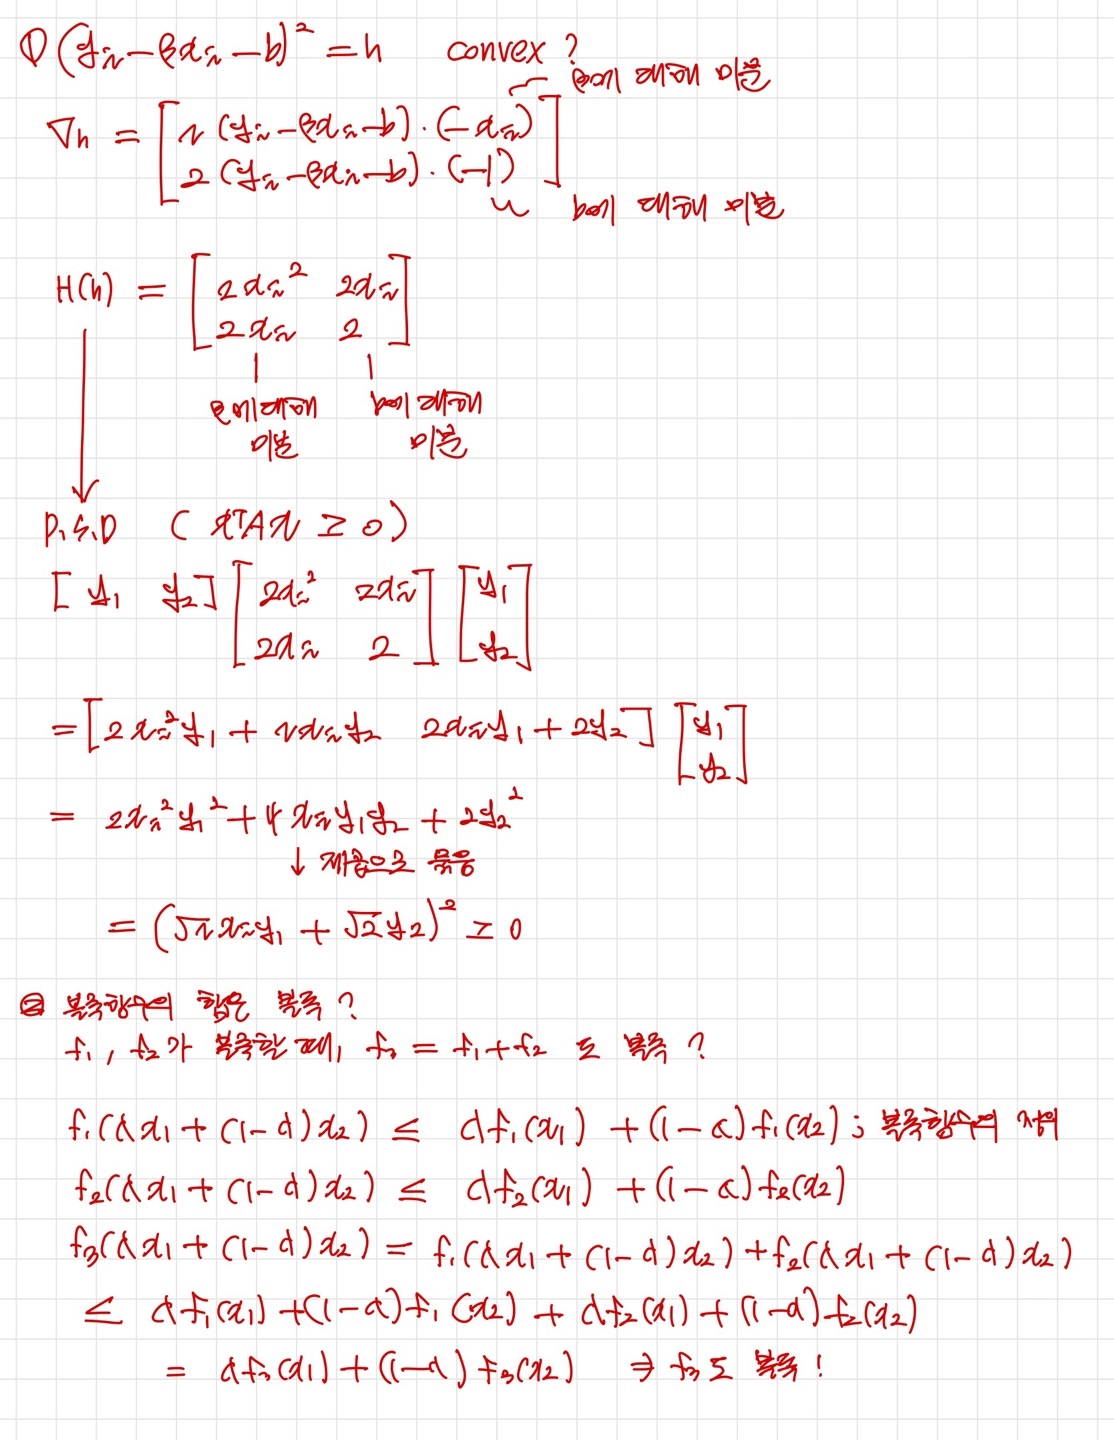 - $E_{(\beta, b)} = \frac 1m\sum\limits_{i=1}^m(y_i-\beta x_i-b)^2$ 을 $\beta$ 와 $b$에 대해 편미분 → $\beta$ 와 $b$도 식으로 표현할 수 있음 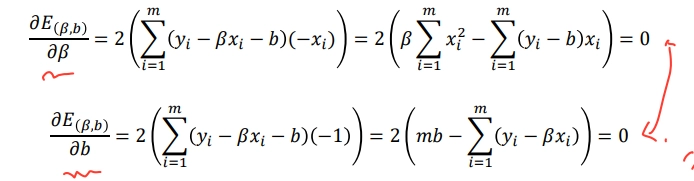 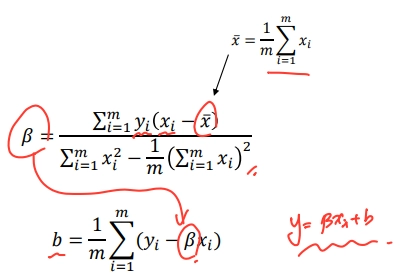 입력 데이터가 여러개인 경우 : 다변량 선형 회귀 $f(x_i) =b+\beta_1x_{i1}+\beta_2x_{i2}+{...}+ \beta_dx_{id}$ $\mathbf {E_{\hat \beta}=(y-X\hat\beta)^T(y-X\hat\beta)}$ (= 값 상수임)를 최소로 하는 $\hat \beta^*$ 을 찾는 것이 목표 필기 위의 필기 에 의해 $\mathbf {X^TX\hat\beta = X^Ty}$ 에서 $\mathbf {X^TX}$가 full rank 라면, (= 선형독립 이라면 = 역행렬이 있다면) $$ \mathbf {\hat \beta=(X^TX)^{-1}X^Ty} $$ 항상 똑같은 최적의 선형식이 도출된다. ⇒ 당연함. $\hat \beta$는 주어진 것들로 구해지기 때문 기하학적 표현 개념 수학적 표현 의미 열공간 $col(X)$ 입력 벡터(열 벡터)들이 만드는 공간(평면) 예측값 $\hat y = X\hat\beta$ 열공간 위의 어떤 점 오차 $\epsilon = y-X\hat\beta$ y와 예측값 사이의 벡터 정규방정식(normial equation) $X^T(y-X\hat\beta) =0$ 오차가 열공간에 직교함 → 오차가 0이 되어야 함. → 직교 조건에 해당 로그 선형 회귀 $\mathbf {\ln y = \beta^Tx+b}$: 데이터셋에서 대응하는 결과값 데이터가 지수 척도에서 변화한다면? === y가 선형이 아니라 지수적으로 증가하거나 감소 ⇒ 비선형 함수도 선형처럼 풀 수 있다. 로지스틱 회귀 ; 분류에 사용함 결과값이 1,0 인 이진 분류 문제라면, 선형 회귀 모델이 생성한 예측값을 0/1로 반환해 줘야함 단위 계단 함수 but 미분 불가능 로지스틱 함수 = 시그모이드 함수 $[-\infin, \infin]$ 의 입력값 $\mathbf x$를 $[0, 1]$의 출력값 $\mathbf y$로 바꾸어주는 함수 → 미분 가능 로지스틱 회귀: 선형회귀 + 로지스틱 함수 출력값: ‘클래스 1로 분류될 확률’ 출력값 > 0.5 = 1 출력값 < 0.5 = 0 $$ y = \frac{1}{1+e^{-(w^T+b)}} $$ $$ \ln \frac y{1-y} = z = w^T+b $$ ⇒ 분류를 해줄 뿐만 아니라 근사확률에 대한 예측도 가능함. ⇒ **선형 회귀 모델의 예측값을 로짓에 근사해보자** 학습 방법 손실 함수 우도(Likelihood): 확률의 곱셈 클수록 좋음(= 확률이 클수록 좋다) → 클수록 실제 데이터를 잘 맞추는 것이기 때문 우도를 최대한 크게하는 $\beta$를 찾아야함. ⇒ Maximum Likelihood Estimation (MLE) - $y_i$가 크면 $f(x_i)^{y_i}$의 값이 크게 나옴 - 반대로, $1-y_i$가 크면 $(1-f(x_i))^{1-y_i}$의 값이 크게 나옴 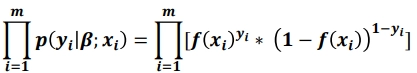 - 전체 샘플 개수 m 일 때 현재의 파라미터 $\beta$가 얼마나 좋은 파라미터인지 알 수 있음 - 확률과 우도(Likelhood) - 필기 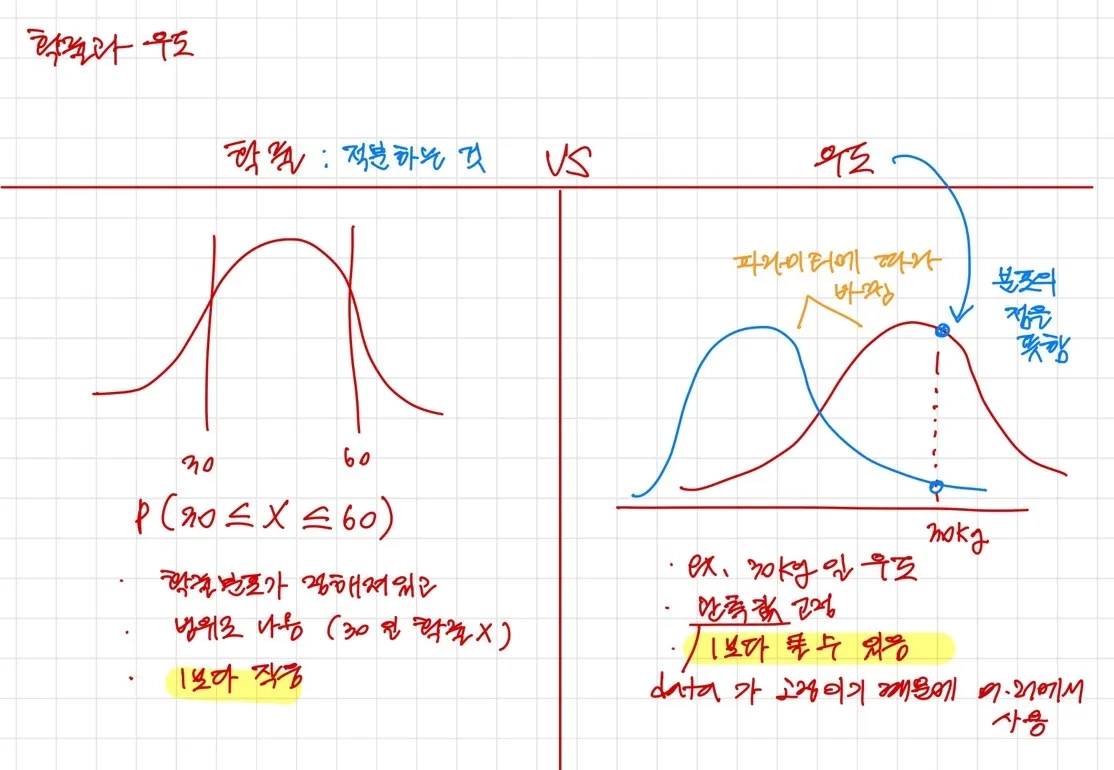 - Log-likelihood: 위의 우도 식에 로그 씌운 것 → 곱셈이므로 로그 씌우면 덧셈으로 바뀔 수 있음 - 우도는 확률의 곱셈인데, 확률이 작다면 ᄌᆬᆬᆬ작아질 수 있음 그러면 곤란해짐 → 로그를 씌우자. 그럼 덧셈이니까. 그리고 계산 쉬워짐 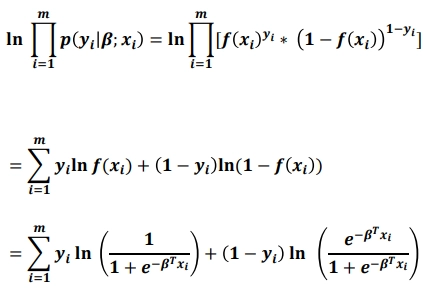 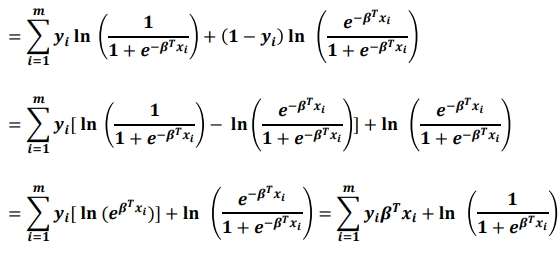 ⇒ 로지스틱 회귀: 선형회귀 + 로지스틱 함수 인 이유 손실함수 = 최소화 해야하는 값 ⇒ 작을수록 좋다. 우도는 $\beta$가 얼마나 좋은 파라미터인지 나타냄 but, 손실함수는 $\beta$가 얼마나 안좋은 파라미터인지를 보여줌 따라서 값이 ‘작을수록’ 좋아야함 따라서 우도에 마이너스를 붙이면 ‘작을수록 좋다‘ 라는 손실함수의 조건을 충족 함 ⇒ 따라서 로짓 우도에 음의 부호(-)를 붙여서 손실함수로 사용한다.* - **$\beta$에 대해 고차이고, 미분 가능, 볼록 함수이다**. ⇒ 최소점이 1개이고, 그 최소점을 찾을 수 있다. == 최적해가 존재한다. - **닫힌해가 존재하지 않음 =**= $\beta$에 대한 식을 직접적으로 계산하는 명확한 공식이 존재하지 않는다. 학습 방법: 최적화 알고리즘 ⇒ 경사하강법, 뉴턴법 걍 방법 똑같음
Summary Language model의 test loss는 model 크기 $N$, dataset 크기 $D$, 학습 compute $C$ 각각에 대해, 나머지 둘이 병목이 아닐 때 power law를 따른다. 반면 depth, width, head 수 같은 architecture shape는 non-embedding parameter 수 $N$이 같으면 loss에 거의 영향을 주지 않는다. $N$과 $D$를 함께 키울 때 overfitting 정도는 $N^{0.74}/D$라는 비율 하나로 결정된다. 즉 model을 8배 키우면 data는 약 5배만 늘리면 된다. 고정된 compute budget에서 최적의 전략은 model을 크게 키우고($N \propto C^{0.73}$), 수렴하기 훨씬 전에 학습을 멈추는 것이다. 1. Introduction Language modeling의 성능은 model architecture, parameter의 수, compute의 수, 주어진 data 양 등에 따라 달라진다. 해당 논문은 Transformer language modeling을 대상으로 위 요인들 중 실제 성능을 결정하는 주요 요인들이 무엇일지를 실험적으로 측정한다. 조건을 바꾸어가며 진행한 여러 실험 결과에 따르면 성능은 학습 시간, context 길이, dataset 크기, model 크기, compute budget에 대해 power law 형태로 scaling 되는 것을 확인할 수 있다. 여러 조건에 따른 결과를 비교하는만큼 해당 논문에서는 몇 가지 notation들을 정의하여 사용한다. $L$: Cross-entropy loss $N$: Number of model parameters $D$: Dataset size $C$: Total non-embedding training compute $C_{min}$: Estimate of minimum amount of non-embedding compute to reach a given loss 2. Background & Methods 2.1. Parameter and Compute Scaling of Transformers Transformer architecture에 대한 hyperparameter를 다음과 같이 설정하였다. $n_{layer}$: layer 수 $d_{model}$: residual stream의 차원 $d_{ff}$: feed-forward layer의 중간 차원 $d_{attn}$: attention output의 차원 $n_{head}$: layer당 attention head 수 1 Model 크기 $N$ layer 하나는 다음과 같은 parameter들로 이루어져 있다. Attention의 Q, K, V projection과 output projection: $4 \times d_{model} \times d_{attn}$ FFN의 두 linear layer: $2 \times d_{model} \times d_{ff}$ 따라서 embedding과 bias를 제외한 전체 parameter 수는 $$ N \approx 2, d_{model}, n_{layer} \left(2 d_{attn} + d_{ff}\right) = 12, n_{layer}, d_{model}^2 \qquad (d_{attn} = d_{model} = d_{ff}/4) $$ 2 Compute token 하나의 forward pass에 드는 연산량(FLOPs)은 $$ C_{forward} \approx 2N + 2, n_{layer}, n_{ctx}, d_{attn} $$ 이때, 두 번째 항은 attention score 계산에서 나오는 context 길이 의존 항이므로 $d_{model} \gg n_{ctx}/12$인 경우에 $N$값에 비해 훨씬 작아지기 때문에 이 항을 무시할 수 있다. 또한, backward pass의 compute는 forward의 약 2배이므로 token 당 전체 학습 compute는 다음과 같이 근사할 수 있다. $$ C \approx 6N $$ 3. Empirical Results and Basic Power Laws 3.1. Transformer Shape and Hyperparameter Independence Transformer의 shape가 성능에 끼치는 영향을 확인하기 위하여 Non-embedding parameter 수 $N$을 고정한 상태에서 $n_{layer}$, $n_{head}$, $d_{ff}$ 중 하나씩 바꿔 가며 loss를 측정하였다. 그 결과 loss는 다음과 같다. Feed-forward 비율, aspect ratio($d_{model}/n_{layer}$), head 차원을 넓은 범위에서 바꿔도 loss 변화는 수 % 이내로 aspect ratio가 40배 차이 나는 구조들도 비슷한 성능을 낸다. 즉 $N$이 고정되면 Transformer의 성능은 shape에 크게 의존하지 않는다. 3.2. Performance with Non-Embedding Parameter Count $N$ Model의 크기를 나타내기 위하여 사용하는 값은 model 속 parameter의 개수이다. 이때, parameter는 실제 objective function에 맞게 학습하는 parameter만 셀 것인지, 혹은 embedding parameter까지 포함할 것인지에 따라 크게 두 가지 관점으로 볼 수 있다. 그렇기에 parameter 수에 따른 model 성능 관계를 더욱 정확하게 나타내기 위해서 두 parameter 중 어떠한 값을 parameter 값으로 사용할 것인지를 정해야 하며 그 검증 과정으로 다음과 같은 실험을 진행하였다. Left: embedding parameter까지 포함해서 세면, loss가 parameter 수뿐만 아니라 $n_{layer}$에도 의존하는 것처럼 보인다. Right: embedding parameter를 빼고 세면, depth가 다른 model들이 하나의 직선(power law)으로 모인다. 이때, layer가 1개뿐이거나 depth/width 비율이 극단적인 경우만 예외적이었다. 왼쪽처럼 보이는 이유는, 작은 model일수록 전체 parameter에서 embedding이 차지하는 비중이 크기 때문이다. parameter 수는 많아 보이지만 실제로 계산에 쓰이는 부분은 적어서 loss가 나쁘게 나온다. 그래서 이 논문은 이후 모든 분석에서 non-embedding parameter 수를 $N$ 으로 사용한다. 이렇게 정의하면 loss를 $N$에 대한 식으로 쓸 수 있다. $$ L(N) \approx \left(\frac{N_c}{N}\right)^{\alpha_N}, \qquad \alpha_N \approx 0.076,\quad N_c \approx 8.8 \times 10^{13} $$ 3.3. Performance with Dataset Size and Compute Dataset 크기 $D$ Data의 수가 model의 bottleneck이 되도록 큰 model($n_{layer}=36$, $d_{model}=1280$)을 WebText2의 부분집합으로 학습하여 특정 data 수로 도달할 수 있는 최저 loss를 측정한다. 이때, 최저 loss를 비교하기 위해서 test loss가 더 이상 줄어들지 않으면 학습을 멈춘다. 그 결과 loss와 Dataset 크기의 관계는 다음과 같다. $$ L(D) \approx \left(\frac{D_c}{D}\right)^{\alpha_D}, \qquad \alpha_D \approx 0.095,\quad D_c \approx 5.4 \times 10^{13} $$ Compute $C$ 학습 compute는 $C = 6NBS$이다. $C$를 고정하고 $N$을 바꿔 가며, 그 compute 안에서 가장 낮은 loss를 내는 model을 찾는다. 이 최적점들을 이으면 다음 관계가 나온다. $$ L(C) \approx \left(\frac{C_c}{C}\right)^{\alpha_C} $$ 각각의 식에서 $X_c$로 나타낸 값들은 log-log 그래프 상에서 관계를 나타내기 위한 fitting으로 구해낸 값이다. 이러한 parameter, Dataset, Compute에 대한 loss의 관계를 정리하면 다음과 같다. 세 그래프 모두 log-log 축에서 linear하다. 왼쪽 그래프의 하늘색 곡선들은 크기가 다른 model 각각의 learning curve이고, 이들의 아래쪽 envelope(검은 선)이 compute에 대한 power law $L = (C_{\min}/2.3 \cdot 10^8)^{-0.050}$ 을 이룬다. 단, 이 power law는 나머지 두 요인이 bottleneck이 아닐 때만 성립한다. 4. Charting the Infinite Data Limit and Overfitting 이전까지는 하나의 변수만 bottleneck이 되도록 하여 각 변수별로 독립적인 영향을 확인하였다. 이번에는 $N$과 $D$ 두 값을 동시에 바꿀 때 loss가 어떻게 되는지, 특히 data가 부족할 때 생기는 overfitting을 다룬다. 4.1. Proposed $L(N, D)$ Equation $$ L(N, D) = \left[\left(\frac{N_c}{N}\right)^{\frac{\alpha_N}{\alpha_D}} + \frac{D_c}{D}\right]^{\alpha_D} $$ 이러한 $N$, $D$에 따른 loss는 다음의 원칙들을 만족하도록 정하였다. Rescaling : Vocabulary 크기나 tokenization이 바뀌면 loss 전체가 일정 배율로 달라질 것이므로, 식이 이런 rescaling을 자연스럽게 허용해야 한다. 한 변수를 무한히 키워도 다른 변수에 의한 한계 : $D$를 고정하고 $N \to \infty$로 보내면 loss는 $L(D)$로, $N$을 고정하고 $D \to \infty$로 보내면 $L(N)$으로 수렴해야 한다. $L(N, D)$는 $D = \infty$에서 analytic : $1/D$에 대한 정수 거듭제곱 급수로 전개할 수 있어야 한다. 4.2. Results $N$과 $D$를 바꿔 가며 학습하고, test loss가 더 이상 줄지 않으면 멈춘 뒤, 위 식의 parameter를 fitting했다. Parameter $\alpha_N$ $\alpha_D$ $N_c$ $D_c$ Value 0.076 0.103 $6.4 \times 10^{13}$ $1.8 \times 10^{13}$ ** Overfitting** Data가 무한할 때의 loss $L(N, \infty)$에 비해 얼마나 손해를 보는지를 $\delta L$로 정의한다. $$ \delta L \equiv \frac{L(N, D)}{L(N, \infty)} - 1 \approx \left(1 + \left(\frac{N}{N_c}\right)^{\frac{\alpha_N}{\alpha_D}} \frac{D_c}{D}\right)^{\alpha_D} - 1 $$ $\delta L$이 클수록 overfitting이 심하다. 식을 보면 $\delta L$은 $N^{\alpha_N/\alpha_D}/D \approx N^{0.74}/D$ 하나에만 의존 한다. Random seed에 따른 loss 변동이 약 0.02이므로, $\delta L < 0.02$이면 overfitting이 없다고 본다. 이를 만족하는 조건은 $$ D \gtrsim (5 \times 10^3), N^{0.74} $$ 즉 model 크기를 키울 때 data는 sub-linear하게만 늘려도 overfitting을 피할 수 있다. 이처럼 Data $D$와 parameter $N$으로 loss 식을 fitting 할 수 있는 것은 물론, overfitting을 방지하기 위한 $N$, $D$의 관계 또한 확인할 수 있었다. 5. Scaling Laws with Model Size and Training Time 이제는 학습 step 수 $S$까지 고려하여 $N$과 학습 시간에 따른 loss를 하나의 식으로 묶는다. 그 전에 batch 크기에 따라 달라지는 step 수와 compute를 보정하기 위해 critical batch size 를 도입한다. 5.1 Critical Batch Size $B_{crit}(L)$ Batch 크기 $B$에 따라 학습 시간(step 수)과 compute가 달라진다. $B \ll B_{crit}$: Batch를 키우면 step 수가 거의 비례해서 줄어든다. Compute 효율이 좋다. $B \gg B_{crit}$: Batch를 더 키워도 step 수가 거의 줄지 않는다. Step 수는 최소에 가깝지만 compute를 낭비한다. 목표 loss에 도달하는 데 필요한 step 수 $S$와 처리한 data 수 $E = BS$ 사이에는 다음 관계가 있다. 이때 E는 Dataset 크기인 D와 다른 실제 처리한 token 수 이다. $$ \left(\frac{S}{S_{\min}} - 1\right)\left(\frac{E}{E_{\min}} - 1\right) = 1 $$ $S_{\min}$: 목표 loss에 도달하는 데 필요한 최소 step 수 ($B \to \infty$일 때) $E_{\min}$: 목표 loss에 도달하는 데 필요한 최소 data 수 ($B \to 0$일 때) Critical batch size는 이 둘의 비율로 정의한다. $$ B_{crit}(L) \equiv \frac{E_{\min}}{S_{\min}} $$ 목표 loss에 따라 $E_{\min}$, $S_{\min}$이 정해지므로 $B_{crit}$도 loss의 함수다. $B = B_{crit}$으로 학습하면 $S = 2S_{\min}$, $E = 2E_{\min}$이 되어, 시간과 compute 사이의 균형점이 된다. 실험적으로 $B_{crit}$은 model 크기와 무관하게 loss에만 의존 하며, 다음 power law를 따른다. $$ B_{crit}(L) \approx \frac{B_ }{L^{1/\alpha_B}}, \qquad B_ \approx 2 \times 10^8 \text{ tokens},\quad \alpha_B \approx 0.21 $$ 실제 측정한 loss에 따른 critical batch를 나타내면 다음과 같다. loss가 13% 줄어들 때마다 $B_{crit}$은 약 2배가 된다. 이를 이용하면 임의의 batch 크기 $B$로 학습한 결과($S$, $C$)를, $B \gg B_{crit}$일 때의 최소 step 수와 $B \ll B_{crit}$일 때의 최소 compute로 환산할 수 있다. $$ S_{\min}(S) = \frac{S}{1 + B_{crit}(L)/B}, \qquad C_{\min}(C) = \frac{C}{1 + B/B_{crit}(L)} $$ 5.2. Performance with Model size and Compute $S_{\min}$을 쓰면 loss를 $N$과 학습 step의 함수로 쓸 수 있다. $$ L(N, S_{\min}) = \left(\frac{N_c}{N}\right)^{\alpha_N} + \left(\frac{S_c}{S_{\min}}\right)^{\alpha_S}, \qquad \alpha_S \approx 0.76,\quad S_c \approx 2.1 \times 10^3 $$ 첫 번째 항은 무한히 학습했을 때 model 크기가 정하는 한계, 두 번째 항은 학습이 덜 되어서 생기는 손실이다. Left: compute를 고정하면 loss를 최소로 만드는 최적 model 크기가 존재한다. 너무 작은 model은 용량이 부족하고, 너무 큰 model은 같은 compute로 충분히 학습되지 못한다. Right: step 수를 고정하면 model이 클수록 loss가 낮다. 점선이 $L(N, S)$ 식이고, 학습 초반(작은 $S$)을 제외하면 실험값과 잘 맞는다. 5.3. Lower bound on Early Stopping Step Data가 유한할 때와 무한할 때의 learning curve는 $S_{\min} \approx S_{stop}$ 근처까지 거의 같다. 따라서 overfitting 때문에 학습을 멈춰야 하는 step 수의 하한을 다음과 같이 추정할 수 있다. $$ S_{stop}(N, D) \gtrsim \frac{S_c}{\left[L(N, D) - L(N, \infty)\right]^{1/\alpha_S}} $$ data가 부족해서 생기는 loss 차이 $L(N,D) - L(N,\infty)$가 작을수록, 더 오래 학습한 뒤에야 overfitting이 시작된다. 6. Optimal Allocation of the Compute Budget 6.1. Optimal Performance and Allocations $B_{crit}$으로 보정한 $C_{\min}$을 쓰면, loss를 $C_{\min}$의 함수 $L(C_{\min})$으로 다시 쓸 수 있다. 그리고 주어진 compute에서 loss를 최소로 만드는 최적 model 크기 $N(C_{\min})$을 구하면 $$ N(C_{\min}) \propto C_{\min}^{0.73} $$ $C_{\min} = 6NB_{crit}S$이고 $B_{crit} \propto C_{\min}^{0.24}$이므로, 남는 step 수는 $$ S_{\min} \propto C_{\min}^{0.03} $$ 이다. 즉, 결론은 다음과 같다. Compute를 최적으로 배분해서 language model을 키울 때는 model 크기 $N$을 주로 키우고, batch 크기는 $B_{crit}$에 맞춰 함께 늘리며, step 수는 거의 늘리지 않는다. 6.2 Predictions from $L(N, S_{\min})$ 5.2절의 $L(N, S_{\min})$ 식과 $B_{crit}(L)$ 식을 결합하면, $L(C_{\min})$의 지수를 이론적으로 예측할 수 있다. $$ L(C_{\min}) = \left(\frac{C_c^{\min}}{C_{\min}}\right)^{\alpha_C^{\min}}, \qquad \alpha_C^{\min} = \frac{1}{1/\alpha_S + 1/\alpha_B + 1/\alpha_N} \approx 0.054 $$ 실험에서 직접 측정한 값 0.050과 잘 맞는다. 세 개의 독립적인 power law가 서로 일관된다는 근거다. 6.3 Contradictions and a Conjecture 이 scaling law를 계속 적용하면 모순이 생긴다. Overfitting을 피하려면 data가 $D \propto N^{0.74} \propto C_{\min}^{0.54}$만큼 늘어야 한다. 그런데 compute-efficient하게 학습할 때 실제로 보는 data는 $$ D(C_{\min}) = \frac{2C_{\min}}{6N(C_{\min})} \propto C_{\min}^{0.26} $$ 으로, 필요한 속도보다 훨씬 느리게 늘어난다. 따라서 data를 재사용하지 않더라도 결국 overfitting 영역에 들어가게 된다. $L(C_{\min})$(주황 점선)은 compute를 늘릴수록 빠르게 줄어든다. 교차점 왼쪽에서는 compute가 bottleneck이라, compute를 늘리면 loss가 줄어든다. $L(D(C))$(빨간 선)는 그 compute에서 보는 data 양으로 달성할 수 있는 loss의 하한이다. 이 선은 더 천천히 줄어든다. 교차점 오른쪽에서는 $L(C_{\min})$이 $L(D(C))$보다 낮아지는데, 이는 data가 부족한데도 loss가 그 data로 가능한 한계보다 낮아진다는 뜻이라 불가능하다. 따라서 scaling law는 교차점 이전에 깨져야 한다. 교차점은 대략 $C^* \sim 10^4$ PF-days, $N^* \sim 10^{12}$ parameters, $D^* \sim 10^{12}$ tokens, $L^* \sim 1.7$ nats/token이다. 논문은 이 지점의 loss $L^*$가 자연어의 token당 entropy에 대한 추정치일 수 있다고 추측한다. 다만 교차점의 위치는 power law 지수에 매우 민감하므로 정확한 값으로 볼 수는 없다. 7. Discussion Language model의 loss는