신규 서버를 설치할 때 이런 상황을 겪게 됩니다. 서버 NIC 두 개를 스위치의 Port-Channel에 연결했는데, 서버에 OS가 없으니 NIC Bonding도 LACP도 동작하지 않아요. 서버가 LACPDU를 보내지 못하니 스위치도 정상적인 Port-Channel을 만들지 못합니다. 그런데 서버는 PXE 부팅으로 네트워크에서 OS를 받아와야 하죠. 이 문제를 풀어주는 기능이 LACP Fallback 입니다. 어떤 문제를 해결할까 OS가 정상적으로 올라온 서버라면 위 그림처럼 양쪽이 Active로 LACP를 주고받으며 Port-Channel이 만들어집니다. 하지만 신규 서버이거나 OS가 없는 서버는 Bonding이 안 되니 LACPDU를 교환하지 못해요. 스위치에 Port-Channel 구성이 되어 있으면 협상이 안 돼서 포트가 정상 동작하지 않고, 그 결과 PXE 서버에서 OS Image를 받아올 수 없습니다. 그래서 실무에서는 종종 서버팀으로부터 LACP Fallback 설정을 요청받게 돼요. LACP Fallback이란 LACP 협상이 일정 시간 동안 실패하면, 해당 Port-Channel에 속한 포트를 개별 포트로 동작시키는 기능 입니다. 그 시간은 Arista 기본값이 90초이고, timeout은 1~300초로 조정할 수 있어요. 동작 방식은 두 가지입니다. static mode : 개별 포트 중 LACP priority 값이 가장 낮은 포트 하나만 살립니다. individual mode : 모든 포트를 개별 포트로 살립니다. 실무에서는 보통 individual mode로 설정합니다. PXE 부팅에는 어느 NIC로 요청이 나갈지 모르니 모든 포트가 살아 있는 편이 편해요. 동작 순서 신규 서버라 아직 OS가 없어서 NIC Bonding이 안 됩니다. 네트워크 담당자에게 Fallback 설정을 요청합니다. 해당 Port-Channel에 LACP Fallback을 추가합니다(보통 individual mode). 서버가 DHCP 서버에서 IP를 받고, PXE 서버에서 OS Image를 전송받습니다. OS 설치가 끝나고 재부팅되면 Bonding이 정상적으로 동작합니다. 멤버 포트 중 하나에서 LACPDU를 수신하면, individual fallback 상태에서 정상 Port-Channel 동작으로 복귀합니다. 설정 예시 interface Ethernet7 switchport access vlan 15 channel-group 10 mode active interface Ethernet8 switchport access vlan 15 channel-group 10 mode active interface Port-Channel10 switchport mode trunk switchport trunk allowed vlan 100,200,300 port-channel lacp fallback individual port-channel lacp fallback timeout 90 이 예시는 이렇게 읽을 수 있어요. Port-Channel10 은 LACP가 정상 동작할 때 서비스 용도로 쓰는 Trunk입니다. 각 물리 포트에 설정한 access vlan 15 는 Fallback으로 개별 포트가 되었을 때 적용됩니다. 이때 포트로 들어오는 프레임을 VLAN 15로 판단하니, 서버는 이 VLAN에서 DHCP, PXE 서버와 통신하게 됩니다. port-channel lacp fallback timeout 은 LACPDU를 받지 못한 채로 이 시간이 지나면 Fallback으로 전환한다는 뜻이에요. 알아두면 좋은 점 Fallback은 설정해야 동작합니다. 기본적으로 꺼져 있고, 멤버 포트가 아니라 Port-Channel 인터페이스에 설정해요. timeout 동안은 포트가 열리지 않습니다. 기본값이 90초라서, 서버가 PXE로 부팅을 시도하는 시점에 아직 Fallback 전환 전이라면 DHCP 요청이 나가지 못할 수 있어요. 필요하면 timeout 값을 조정할 수 있습니다. Native VLAN으로도 비슷한 목적을 달성할 수 있습니다. Trunk 포트로 태그 없이 들어온 프레임은 Native VLAN으로 처리됩니다. OS가 없는 서버는 VLAN 태그를 모르고 태그 없는 프레임을 보내니, Native VLAN을 설치용 VLAN과 연결해서 관리망과 서비스망 트래픽을 구분하는 구성도 쓰입니다. DHCP 요청은 브로드캐스트 라서, DHCP 서버가 다른 대역에 있으면 L3 장비에 DHCP relay(EOS에서는 ip helper-address ) 설정이 필요합니다. 신규 서버 설치가 잘 안 될 때는 Fallback과 함께 이 설정도 같이 확인해보세요. 정리 LACP Fallback은 OS가 없어 LACP가 동작하지 않는 서버를 위해, 일정 시간 협상이 실패하면 멤버 포트를 개별 포트로 동작시키는 기능입니다. 서버는 이 개별 포트로 DHCP와 PXE 서버에 접속해서 OS를 설치하고, 설치 후 LACPDU가 들어오면 Fallback이 해제되며 정상 Port-Channel로 복귀해요. Fallback 설정을 이해하고 나면 실무의 DHCP relay 설정과 Native VLAN을 쓰는 의도도 한층 잘 보입니다.
데이터분포 탐색하기 백분위수와 상자그림 백분위수 전체 분포를 알아보는데 보통 사용하는 것이 백분위수 이다. 주로 사용되는 것은 사분위수(25, 50, 75번째 백분위수)나 십분위수(10, 20, 30,...,90번째 백분위수)아다. 이것은 꼬리 부분(외측 범위)를 묘사하는 데 좋다. 상자그림 백분위수를 이용해 데이터의 분산을 손쉽게 시각화 하는 방법이다. import matplotlib.pyplot as plt import numpy as np 가상 데이터 생성 data = np.random.randn(100) 박스 플롯 그리기 plt.figure(figsize=(6, 4)) plt.boxplot(data) plt.title("Basic Box Plot") plt.show() | 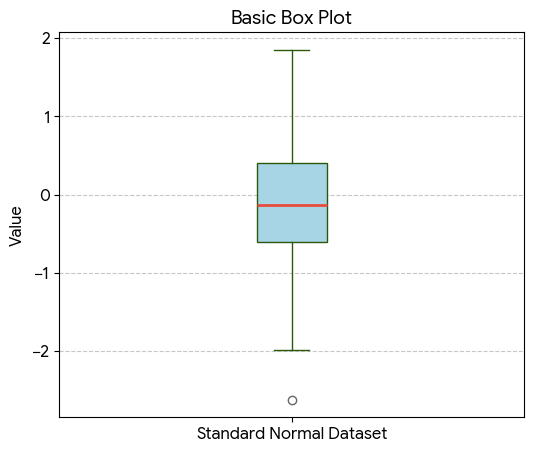 | |--| |<center>**위 코드로 생성한 상자그림**</center>| 위 아래 T자로 나 있는 것이 **수염**으로 데이터 전체의 범위를 나타내준다. 그 외에 수염 부분보다 밖에 위치한 데이터는 원으로 표시한다. ### 도수분포표와 히스토그램 - #### 도수분포표 변수의 범위를 동일한 크기의 구간으로 나눈 다음, 각 구간마다 몇 개의 변숫값이 존재하는지 보여주기 위해 사용한다. (1) 범주형 변수(species)의 도수분포표 ```python import seaborn as sb import pandas as pd # Iris 데이터셋 불러오기 iris = sb.load_dataset('iris') # species 컬럼의 도수분포표 freq_table = iris['species'].value_counts() print(freq_table) # 상대도수(비율) 구하기 prop_table = iris['species'].value_counts(normalize=True) print(prop_table) output class counts setosa 50 versicolor 50 virginica 50 (2) 연속형 변수(sepal_length)의 도수분포표 # sepal_length를 5개의 구간으로 나누어 도수분포표 작성 iris['sepal_length_binned'] = pd.cut(iris['sepal_length'], bins=5) print(iris['sepal_length_binned'].value_counts().sort_index()) output section counts (4.296, 5.02] 32 (5.02, 5.74] 41 (5.74, 6.46] 42 (6.46, 7.18] 24 (7.18, 7.9] 11 구간 표시 기호 의미: 소괄호 (는 초과, 대괄호 ]는 이하를 뜻합니다. 예: (4.296, 5.02] 구간은 4.296cm 초과 ~ 5.02cm 이하인 데이터가 32개 있다는 의미 위 표에서 7.18cm-7.9cm 사이의 데이터가 적다는 분포를 볼 수 있다. 히스토그램 도수분포표를 시각화하는 방법이다. 범주형은 연속형이 아니기 때문에 히스토그램이 적절하지 않다. 연속형 변수(sepal_length)의 도수분포표 Memorize 통계학에서는 모멘트(moment) 혹은 적률 이라는 개념을 쓴다. 위치와 변이는 각각 분포의 일차 및 이차 모멘트 라고 한다. 삼차, 사차 모멘트는 각각 왜도(Skewness) , 첨도(kurtosis) 라고 부른다. 왜도는 데이터가 큰 값이나 작은 값 쪽으로 얼마나 비슴드히 쏠려 있는지를 나타내고, 첨도는 데이터가 극단 값을 갖는 경향성을 나타낸다. 보통을 이런 값을 직접 구하기보다는 그래프로 시각화해서 직접 확인한다. 밀도 그림과 추정 밀도 그림 커널 밀도추정* 을 통해서 데이터로부터 직접 계산 한 후 보통 히스토그램 위에 데이터의 분포를 연속된 선으로 보여준다. 다른 말로 하면 부드러운 히스토그램이라고도 할 수 있다. 히스토그램과 다른 점은 y축의 값을 개수가 아닌 비율로 표시한다. 밀도 곡선 아래의 총 면적은 1이고 구간의 개수 대신 x축의 두 점 사이의 곡선 아래 면적을 계산하며, 이는 두 점 사이에 있는 분포의 비율에 해당한다. 이진 데이터와 범주 데이터 탐색하기 이진변수나 범주가 몇 개 안되는 범주형 변수는 중요한 범주의 비율만 보면 되기에 분석이 그리 어렵지 않다. 범주형 자료를 보여줄 때 주로 사용하는 것은 막대도표이다. 막대도표는 히스토그램과 매우 유사하다. 차이점은 x축이다. 막대 도표는 요인변수의 서로 다른 범주인 반면, 히스토그램은 수치적으로 나타낼 수 있는 하나의 변수 값을 의미한다. 그림을 보았을 때 바로 보이는 건 막대는 떨어져 있고 히스토는 붙어있다. 막대도표 대신 파이그림을 사용하기도 하지만, 시각적으로 효과적이지 않다는 이유로 잘 사용하지 않는다. 최빈값 데이터에서 가장 자주 등장하는 범주 혹은 값들. 기댓값 범주에 해당하는 어떤 수치가 있을 때, 범주의 출현 확률에 따른 평균 가중치가 해당 확률이 되는 가중평균이 기댓값이다. 이렇듯 기댓값과 가중평균과 같은 꼴이다. import matplotlib.pyplot as plt import seaborn as sns # 1. 데이터 로드 df = sns.load_dataset('iris') # 2. 품종별 평균 및 전체 평균(기준값) 계산 species_mean = df.groupby('species')['sepal_length'].mean() overall_mean = df['sepal_length'].mean() # 5.8433... # 3. 그래프 그리기 plt.figure(figsize=(7, 5)) bars = plt.bar(species_mean.index, species_mean.values, color=['#9ecae1', '#a1d99b', '#fcae91'], edgecolor='gray', width=0.6) # 4. 기준값(전체 평균) 선 추가 plt.axhline(overall_mean, color='red', linestyle='--', linewidth=1.5, label=f'Overall Mean ({overall_mean:.2f} cm)') # 5. 수치 라벨링 및 꾸미기 for bar in bars: height = bar.get_height() plt.text(bar.get_x() + bar.get_width()/2., height + 0.1, f'{height:.2f} cm', ha='center', va='bottom', fontsize=10, fontweight='bold') plt.title('Iris Mean Sepal Length by Species', fontsize=14, pad=15) plt.xlabel('Species', fontsize=12) plt.ylabel('Sepal Length (cm)', fontsize=12) plt.ylim(0, 8) plt.legend(loc='upper left') plt.grid(axis='y', linestyle=':', alpha=0.6) plt.tight_layout() plt.show() Misleading graph 왜곡 정도를 나타내는 대표 지표는 Lie factor 이다. $$\text{Lie factor}=\frac{\text{그래프에 표현된 변화율}}{\text{실제 데이터의 변화율}}$$ 확률 사건이 발생할 확률이란 상황이 수없이 반복될 경우 사건이 발생할 비율을 의미. *어떻게 정의하는가에 따라 철학적 토론할 수밖에 없지만, 이 책은 위와 같은 의미로 정의한다. 상관관계 탐색적 데이터 분석(EDA) 을 하는 과정에서 예측값과 목푯값과의 상관관계를 조사해야 한다. $X$가 큰 값을 가질 때 $Y$가 큰 값을 가지고, $X$가 작은 값을 가질 때 $Y$가 작은 값을 가지는 경우 서로 양의 상관관계 를 가진다. 반대로 $X$가 큰 값을 가질 때 $Y$가 작은 값을 가지는 경우에는 음의 상관관계 를 가진다. 상관계수(correlation coefficien): 수치적 변수들 간에 어떤 관계가 있는지 나타내기 위해 사용되는 측정량(-1에서 +1까지의 범위) 상관행렬(correlation matrix): 행과 열이 변수들을 의미하는 표를 말하며, 각 셀은 그 행과 열에 해당하는 변수들 간의 상관관계를 의미한다. 아래 변수 볼 때 벡터곱합은 32이다. v1 : {1, 2, 3} v2 : {4, 5, 6} 벡터의 순서를 섞어서 곱해서 더해도 32를 넘을 수 없다. 즉 32라는 합을 랜덤으로 섞었을 때 나오는 값들과 비교해볼 수 있을 것이다. 하지만 이런 값들은 재표본분포에 대한 레퍼런스로서의 의미밖에는 없다. 재표본분포(Resampling Distribution) : 관측된 데이터나 표본에서 반복적으로(복원 또는 비복원) 데이터를 추출해 만든 통계량(평균, 중앙값, 차이 등)의 확률 분포 이런 방법보다는 상관계수(피어슨 상관계수라고도 함)라는 표준화된 방식이 훨씬 더 유용하다. $$ r = \frac{\sum_{i=1}^{n}(x_i-\bar{x})(y_i-\bar{y})}{(n-1)s_x s_y} $$ 의미 기호 의미 $(n)$ 데이터 쌍의 개수 $(x_i,\ y_i)$ $(i)$번째 데이터 쌍 $(\bar{x},\ \bar{y})$ 각 변수의 평균 $(s_x,\ s_y)$ 각 변수의 표본 표준편차 해석 (r) 값 해석 (1)에 가까움 (x)가 커질수록 (y)도 커지는 강한 직선적 관계 (0)에 가까움 직선적 관계가 약함 (-1)에 가까움 (x)가 커질수록 (y)는 작아지는 강한 직선적 관계 두 변수 간의 선형적인 관계를 갖지 않을 경우, 상관계수는 유용한 측정 지표가 아니다. import matplotlib.pyplot as plt import seaborn as sns import pandas as pd from sklearn.datasets import load_iris # 1. 데이터 불러오기 및 깔끔한 변수명 설정 iris = load_iris() df = pd.DataFrame(iris.data, columns=['Sepal Length', 'Sepal Width', 'Petal Length', 'Petal Width']) corr_matrix = df.corr() # 2. 히트맵 시각화 plt.figure(figsize=(8, 6)) sns.heatmap( corr_matrix, annot=True, # 수치 표시 cmap='RdBu_r', # 양수: 빨강, 음수: 파랑 (0: 흰색) vmin=-1, # 최소-최대 고정으로 0의 기준점 유지 vmax=1, center=0, fmt='.2f', # 소수점 둘째 자리 linewidths=0.5, # 셀 사이 선 두께 cbar_kws={"shrink": 0.8} ) plt.title('Iris Feature Correlation Heatmap', fontsize=14, pad=15) plt.tight_layout() # 3. PNG 파일로 저장 (고해상도 150 DPI) plt.savefig('iris_heatmap.png', dpi=150) plt.show() *상관계수는 특잇값에 민감하다. 산점도 $x$축과 $y$축이 서로 다른 두 개의 변수를 나타내는 도표 두 변수 사이의 관계를 시각화하는 가장 기본적인 방법이 산점도를 그려보는 것이다. import matplotlib.pyplot as plt from sklearn.datasets import load_iris iris = load_iris() for i, species in enumerate(iris.target_names): mask = iris.target == i plt.scatter( iris.data[mask, 2], iris.data[mask, 3], label=species, alpha=0.8 ) plt.xlabel("Petal Length (cm)") plt.ylabel("Petal Width (cm)") plt.title("Iris: Petal Length vs. Petal Width") plt.legend(title="Species") plt.grid(alpha=0.2) plt.tight_layout() plt.savefig("petal_scatter.png", dpi=200) plt.show() 두 개 이상의 변수 탐색하기 평균과 분산과 같이 익숙한 추정값은 일변량분석 (한 번에 하나의 변수), 상관분석은 이변량분석 , 셋 이상의 변수를 분석하는 것을 다변량분석 이라고 한다. 분할표(Contingency Table) : 두 가지 이상의 범주형 변수의 빈도수를 기록한 표 육각형 구간(Hexagonal Binning) : 두 변수를 육각형 모양의 구간으로 나눈 그림 등고 도표(Contour Plot) : 지도상에 같은 높이의 지점을 등고선으로 나타내는 것처럼, 두 변수의 밀도를 등고선으로 표시한 도표 바이올린 도표(Violin Plot) : 상자그림과 비슷하지만 밀도추정을 함께 보여준다. 육각형 구간과 등고선(수치형 변수 대 수치형 변수를 시각화) 산점도는 데이터의 개수가 상대적으로 적을 때는 괜찮지만, 수백만의 레코드를 나타내기에는 점들이 너무 밀집되어 알아보기 어렵다. 그럴 때 아래와 같은 육각형 구간 import matplotlib.pyplot as plt import seaborn as sns # 1. 붓꽃(Iris) 내장 데이터셋 로드 iris = sns.load_dataset('iris') # 데이터 추출 x = iris['petal_length'] y = iris['petal_width'] # 2. 그래프 크기 설정 및 hexbin 플롯 그리기 plt.figure(figsize=(9, 6)) # gridsize: 육각형의 크기/조밀도 조정 # cmap: 'viridis' 컬러맵 적용 (기본값) # mincnt: 데이터가 1개 이상 있는 빈(bin)만 표시하여 빈 곳을 흰색으로 처리 hb = plt.hexbin(x, y, gridsize=20, cmap='viridis', mincnt=1) # 3. 우측 컬러바(Colorbar) 추가 및 라벨 설정 cb = plt.colorbar(hb) cb.set_label('Number of samples') # 4. 타이틀 및 축 라벨 설정 plt.title('Iris: Petal Length vs. Petal Width (Hexbin)', fontsize=14, pad=15) plt.xlabel('Petal Length (cm)', fontsize=12) plt.ylabel('Petal Width (cm)', fontsize=12) # 5. 축 눈금 및 범위 세부 조정 (이미지와 일치하도록 설정) plt.xlim(0.5, 7.5) plt.ylim(-0.1, 2.6) # 그래프 표시 plt.tight_layout() plt.show() 등고선은 꼭대기 쪽으로 갈수록 밀도가 높아진다. import matplotlib.pyplot as plt import seaborn as sns # 1. 붓꽃(Iris) 데이터셋 로드 iris = sns.load_dataset('iris') plt.figure(figsize=(9, 6)) # 2. 등고선 그래프(KDE Plot) 그리기 # fill=True를 주면 등고선 사이가 색상으로 채워집니다. sns.kdeplot( data=iris, x='petal_length', y='petal_width', cmap='viridis', # 육각형 그래프와 동일한 컬러맵 적용 fill=True, # 등고선 내부 채우기 (선만 그리려면 False) thresh=0.05, # 밀도가 아주 낮은 외곽 영역 제거 levels=10 # 등고선 층의 개수 ) # 3. 타이틀 및 축 라벨 설정 plt.title('Iris: Petal Length vs. Petal Width (Contour/KDE)', fontsize=14, pad=15) plt.xlabel('Petal Length (cm)', fontsize=12) plt.ylabel('Petal Width (cm)', fontsize=12) # 4. 축 범위 조정 plt.xlim(0.5, 7.5) plt.ylim(-0.1, 2.6) plt.tight_layout() plt.show() 두 수치형 변수의 관계를 나타내는 다른 도표로 히트맵이 있다. import matplotlib.pyplot as plt import numpy as np # 색상 값과 셀에 표시할 문구를 별도로 지정 colors = np.array([ [0.09, 0.60, 0.00, 0.13], [0.44, 0.67, 0.16, 0.59], [0.92, 1.00, 0.20, 0.96], ]) labels = [ ["1.46 cm", "1.46 cm", "0.69 cm", "0.78 Corr"], ["11.37 cm", "12.25 cm", "1.03 cm", "0.79 Corr"], ["1.46 cm", "0.78 Corr", "1.01 cm", "0.73 Corr"], ] species = ["Setosa", "Versicolor", "Virginica"] variables = [ "Petal Length [Low]", "Petal Length [High]", "Petal Width [Low]", "Petal Width [High]", ] fig, ax = plt.subplots(figsize=(14, 9)) heatmap = ax.imshow( colors, cmap="viridis", vmin=0, vmax=1, aspect="auto", interpolation="nearest", ) ax.set_xticks(np.arange(len(variables)), labels=variables) ax.set_yticks(np.arange(len(species)), labels=species) ax.tick_params(axis="both", labelsize=14) ax.set_xlabel("Variable Group", fontsize=20) ax.set_ylabel("Species", fontsize=20) ax.set_title( "Iris Data Analysis (Heatmap)\n" "Correlation and Mean Values Matrix", fontsize=25, pad=12, ) # 셀 사이 흰색 구분선 ax.set_xticks(np.arange(0.5, 3.5, 1), minor=True) ax.set_yticks(np.arange(0.5, 2.5, 1), minor=True) ax.grid(which="minor", color="white", linewidth=2) ax.tick_params(which="minor", bottom=False, left=False) # 셀 내부 문구 for row in range(len(species)): for col in range(len(variables)): ax.text( col, row, labels[row][col], ha="center", va="center", fontsize=21, color="#171717" if colors[row, col] > 0.8 else "#eeeeee", ) colorbar = fig.colorbar( heatmap, ax=ax, ticks=np.linspace(0, 1, 6), fraction=0.04, pad=0.07, ) colorbar.ax.tick_params(labelsize=16) colorbar.set_label( "Normalized Mean or Correlation Value\n(Arbitrary Units)", fontsize=20, ) plt.tight_layout() plt.show() 범주형 변수 대 범주형 변수 분할표 는 두 범주형 변수를 요약하는 데 효과적인 방법, 범주별 빈도수를 기록한 표다. 꽃받침 길이(중간값 기준) 분할표 import pandas as pd from sklearn.datasets import load_iris # 1. 아이리스 데이터셋 로드 iris = load_iris() df = pd.DataFrame(iris.data, columns=iris.feature_names) # 타겟(품종) 데이터 추가 및 문자열 이름 매핑 ('setosa', 'versicolor', 'virginica') d
VRRP(Virtual Router Redundancy Protocol)는 게이트웨이 이중화 프로토콜 입니다. active-standby로 동작하고, 목적은 fail over예요. 게이트웨이 장비 한 대가 죽어도 서버나 단말은 설정을 바꾸지 않고 계속 통신할 수 있습니다. 동작 방식 두 장비가 하나의 가상 IP(VIP)와 가상 MAC(vMAC)을 공유하고, 서버는 이 VIP를 게이트웨이로 씁니다. priority 값이 높은 장비가 master, 낮은 장비가 backup이 됩니다. 기본값은 100이에요. master는 1초마다 advertisement를 보내고, backup은 이게 끊기면 master가 죽었다고 보고 승격합니다. preempt 를 켜두면, master가 죽어서 backup이 역할을 가져갔다가 원래 master가 살아났을 때 다시 역할을 되찾습니다. Arista에서는 기본으로 켜져 있어요. 슬라이드의 show 결과를 보면, master(priority 120)는 State is Master , backup(priority 100)은 State is Backup 이고, backup의 Master Router 에는 master의 주소(10.10.10.1)가 보입니다. VIP는 10.10.10.254, vMAC은 0000.5e00.010a 예요. vMAC의 마지막 바이트 0a 는 VRRP group 번호(10)를 16진수로 쓴 값입니다. Master Down interval 이 3.530s, 3.600s로 나오는 것도 눈여겨볼 만해요. Advertisement interval(1초)의 3배에 skew time을 더한 값이라, master가 사라지면 backup은 약 3.5초 뒤에 승격합니다. fail over가 일어나 backup이 master로 승격하면, 그 장비는 GARP 를 보내서 "이제 VIP와 vMAC을 가진 master는 나"라고 광고합니다. 실습 구성 EVE-NG에서 vEOS5를 master, vEOS6을 backup으로 구성했습니다. 아래쪽 vEOS가 두 장비에 연결되어 있고, 각 장비의 Eth3는 위쪽 업링크 장비로 이어집니다. [master - vEOS5] track UL interface Ethernet3 line-protocol interface Vlan10 vrf BLUE ip address 10.10.10.1/24 vrrp 10 priority-level 120 vrrp 10 preempt delay minimum 5 reload 30 vrrp 10 ipv4 10.10.10.254 vrrp 10 tracked-object UL decrement 30 [backup - vEOS6] interface Vlan10 vrf BLUE ip address 10.10.10.2/24 vrrp 10 ipv4 10.10.10.254 master 설정을 줄별로 보면 이렇습니다. priority-level 120 : 기본값(100)인 backup보다 높아서 master가 됩니다. preempt delay minimum 5 reload 30 : preempt가 일어난 뒤 master 역할을 되찾기까지 5초를 기다리고(minimum), 재부팅한 경우에는 30초를 기다립니다(reload). tracked-object UL decrement 30 : UL이라는 tracked object가 down이 되면 priority를 30 낮춥니다. UL은 Eth3(업링크)의 line protocol을 추적해요. backup은 priority와 preempt를 기본값으로 둡니다. show vrrp brief 결과는 이렇습니다. [master] Interface VRF ID Ver Pri Time State Last Transition VR IP Addresses Vl10 BLUE 10 2 120 3530 Master 00:11:43 ago 10.10.10.254 [backup] Interface VRF ID Ver Pri Time State Last Transition VR IP Addresses Vl10 BLUE 10 2 100 3600 Backup 00:02:36 ago 10.10.10.254 실습: 업링크가 죽으면? vEOS5의 업링크(Eth3)를 shutdown해봤습니다. localhost(config-if-Et3)#shutdown localhost(config-if-Et3)#sh vrrp vrf BLUE brief Interface VRF ID Ver Pri Time State Last Transition VR IP Addresses Vl10 BLUE 10 2 90 3640 Backup 00:00:02 ago 10.10.10.254 tracked object UL이 down이 되면서 priority가 120에서 30만큼 줄어 90 이 됐고, backup(100)보다 낮아져서 vEOS5는 Backup으로 내려갔습니다. show vrrp vrf BLUE all 에서도 Priority is 90 , Master Router is 10.10.10.2, priority is 100 , Tracking object UL with priority 30 (Interfaces: Ethernet3) 로 확인돼요. 새 master가 된 vEOS6에서는 priority 100으로 Master 상태가 됐고, 그 순간 GARP를 보냈습니다. vEOS6의 Eth1에서 캡처한 프레임입니다. Frame 2: 60 bytes on wire (480 bits) Ethernet II, Src: IETF-VRRP-VRID_0a (00:00:5e:00:01:0a), Dst: Broadcast (ff:ff:ff:ff:ff:ff) Address Resolution Protocol (reply/gratuitous ARP) 출발지 MAC이 vMAC( 00:00:5e:00:01:0a )이고 목적지는 브로드캐스트인 gratuitous ARP입니다. 이걸 받은 아래쪽 스위치가 vMAC의 위치를 vEOS6 쪽 포트로 새로 학습하기 때문에, 서버 트래픽이 새 master로 넘어갑니다. 알아두면 좋은 점 tracking이 필요한 이유 : 업링크가 죽어도 게이트웨이 장비 자체는 살아 있으면 VRRP advertisement가 계속 나가서 master를 유지합니다. 그러면 서버 트래픽이 나갈 길이 없는 장비로 향하죠. tracked object로 priority를 낮춰주면 이런 상황에서도 fail over가 일어납니다. decrement 값 은 master priority − decrement 가 backup priority보다 낮아야 의미가 있습니다. 이 실습은 120 − 30 = 90이 100보다 낮아서 전환이 됐어요. 값이 너무 작으면 업링크가 죽어도 master가 바뀌지 않습니다. 복구하면 Eth3가 다시 올라오고 priority가 120으로 돌아옵니다. preempt가 켜져 있으니 minimum delay(5초) 뒤에 master 역할을 되찾습니다. MLAG 환경에서는 Arista가 VRRP보다 VARP를 권장합니다. VRRP는 게이트웨이 MAC으로 오는 트래픽이 peer-link를 타고 master까지 가야 하기 때문이에요. 정리 VRRP는 priority로 master와 backup을 정하고, preempt로 master의 복귀 여부를 정하며, tracked object로 업링크 장애까지 fail over에 반영할 수 있는 게이트웨이 이중화 프로토콜입니다. fail over가 일어나면 새 master가 vMAC으로 GARP를 보내 스위치의 MAC 테이블을 갱신하고, 서버는 같은 VIP로 계속 통신합니다.
Nutanix 환경을 중심으로 클라우드 가시성 확보와 디지털 운영 회복력을 실무 관점에서 정리했습니다 금요일 저녁 퇴근 30분 전, 슬랙 채널이 붉게 물들기 시작합니다. 처음엔 한두 개 알람이었는데 어느새 수십 개. 급하게 Prism 대시보드를 열어보지만, 온프레미스 클러스터와 AWS, Azure가 얽힌 환경에서 어디가 진짜 원인인지 금방 파악이 안 됩니다. CPU 사용률은 정상, 메모리도 이상 없음. 그런데 서비스 응답이 느립니다. 이런 상황이 낯설지 않다면, 가시성 문제가 있는 겁니다. 모니터링을 하는데도 원인을 못 찾는 이유 이 상황의 본질은 도구가 없어서가 아닙니다. 지표는 충분히 수집되고 있는데 그것들이 서로 연결되어 있지 않아서입니다. CPU 사용률은 보이지만 어떤 시스템 콜이 병목을 만드는지는 안 보이고, 네트워크 트래픽은 보이지만 어떤 VM 간 통신이 문제인지는 알 수 없습니다. 하이브리드 멀티클라우드 환경이 일반화될수록 가시성의 사각지대는 오히려 더 넓어집니다. 기존 모니터링의 한계도 여기서 드러납니다. 사전에 정해둔 임계치를 넘으면 알람을 보내는 구조는, 연쇄 장애를 잡지 못합니다. 스토리지 I/O 지연이 누적되어 애플리케이션 타임아웃이 발생하고, 그게 다시 재시도 트래픽을 유발해 네트워크 병목으로 번지는 식의 문제에서는 각 지표를 따로 보면 다 정상 범위 안에 있습니다. 연결해서 봐야만 보입니다. 이래서 '모니터링'과 '관측성(Observability)'의 차이가 중요해졌습니다. 모니터링이 "무엇이 실패했는가"를 알려준다면, 관측성은 "왜 실패했는가"를 추적할 수 있는 구조입니다. 메트릭, 로그, 트레이스가 실시간으로 연결되어야 진짜 가시성입니다. Nutanix가 NCM(Nutanix Cloud Manager) 2.x에서 강조하는 방향도 여기 있습니다. 정적인 대시보드 리포팅을 넘어 커스텀 메트릭과 고해상도 텔레메트리 데이터를 직접 정의하고 시각화할 수 있게 됐습니다. 50개 이상의 내장 지표, 인벤토리 브라우저, Signals 기능이 추가됐고, 최대 10,000개 활성 VM 워크로드를 5개 Worker VM 폼팩터로 관리하면서 단일 VM 장애에도 관리 평면이 무너지지 않는 결함 허용 구조를 갖췄습니다. 금융이나 공공 부문처럼 운영 중단이 허용되지 않는 환경에서는 이 부분이 생각보다 큰 차이를 만듭니다. 서드파티 APM 도구와의 통합도 실무에서 자주 씁니다. Datadog 연동을 예로 들면, 에이전트 하나로 Prism Central이 관리하는 모든 클러스터·호스트·VM의 CPU, 메모리, 스토리지 I/O 지연을 초 단위로 수집할 수 있습니다. 단순 메트릭 수집을 넘어 Prism Central의 운영 이벤트, 감사 로그, 알람 정보가 Datadog 플랫폼으로 직접 스트리밍되기 때문에, 애플리케이션 응답 지연이 코드 문제인지 Nutanix 스토리지 컨트롤러 I/O 경합 때문인지를 단일 뷰에서 연관 분석할 수 있습니다. Dynatrace는 AHV 하이퍼바이저 전용 엔티티 모델을 기반으로 가상화 하위 계층부터 프론트엔드까지 장애 원인을 추적하는 뷰를 제공합니다. eBPF: 커널 레벨까지 내려가는 이유 가시성 확보 기술 중에서 최근 가장 주목받고 있는 게 eBPF(extended Berkeley Packet Filter)입니다. 복잡한 기술인데, 실무 관점에서 핵심만 정리하면 이렇습니다. 기존에는 마이크로서비스 환경에서 컨테이너 트래픽을 모니터링하려면 각 Pod마다 사이드카(Sidecar) 프록시를 붙여야 했습니다. 수천 개 컨테이너 환경에서 이건 CPU·메모리 낭비가 상당하고, 레이턴시도 추가됩니다. eBPF는 이 구조를 바꿉니다. 애플리케이션 코드를 건드리지 않고 커널 내부에서 시스템 콜, 네트워크 이벤트, 패킷을 직접 추적합니다. 성능 부하는 1~2% 미만이면서 훨씬 정밀한 데이터를 뽑아낼 수 있습니다. 실무에서 특히 유용한 건 네트워크 레벨 가시성입니다. TCP 핸드셰이크 지연으로 특정 연결이 느린 건지, 패킷 재전송이 발생해 간헐적 타임아웃이 생기는 건지, DNS 조회 실패로 서비스 디스커버리가 깨진 건지를 커널에서 직접 포착합니다. 재현이 어려운 간헐적 장애의 원인을 Wireshark 같은 전통적 패킷 캡처 없이도 잡아낼 수 있습니다. 보안 관점에서도 달라집니다. 전통적인 CSPM 도구들은 클라우드 API 로그나 IAM 활동 기록에 의존하다 보니 공격이 일어나고 한참 뒤에야 로그가 남는 구조였습니다. eBPF는 커널 이벤트를 직접 검사하므로 비정상적인 권한 상승, 컨테이너 네임스페이스 탈출 시도, 알려지지 않은 취약 라이브러리 함수 호출을 거의 실시간으로 잡아낼 수 있습니다. Falco , Tetragon , KubeArmor 같은 런타임 보안 솔루션들이 모두 eBPF 기반인 이유가 여기 있습니다. eBPF와 LSM(Linux Security Modules)이 결합되면 탐지를 넘어 커널 레벨에서 불법 명령을 즉각 차단하는 방어까지 가능해집니다. 실무 팁 — Prism Syslog 연동 Prism의 Syslog 포워딩 기능을 활용해 eBPF 에이전트가 수집한 데이터를 사내 SIEM이나 중앙 로그 서버로 통합하면, 보안 위협과 성능 저하의 상관관계를 한 화면에서 볼 수 있습니다. 현재 Prism Central(pc.2024.3 기준)에서 Syslog 서버는 단일 대상만 지정할 수 있으니, 설계 단계에서 고성능 로그 집계기를 앞단에 배치하는 구조를 먼저 잡는 게 좋습니다. UDP 대신 RELP 기반 TCP 전송을 쓰면 패킷 정합성도 보장됩니다. RTO와 RPO: 숫자 뒤에 있는 비즈니스 질문 운영 회복력을 이야기할 때 RTO와 RPO는 항상 등장하는 개념인데, 실무에서는 조금 다르게 접근하는 게 유용합니다. RPO(Recovery Point Objective)는 단순히 "몇 시간 백업 주기"가 아닙니다. "1시간 전 백업으로 복구할 때 결제 트랜잭션 몇 건이 유실되는가, 그리고 그게 비즈니스적으로 감당 가능한가"라는 질문입니다. RTO(Recovery Time Objective)는 "복구에 몇 시간이 걸리는가"가 아니라 "핵심 결제 시스템이 2시간 멈추면 비즈니스 손실이 얼마인가, 그 손실을 줄이기 위해 인프라에 얼마를 투자할 수 있는가"의 문제입니다. 이 두 지표를 비즈니스 영향 평가(BIA)와 연결해서 생각하면 DR 전략이 명확해집니다. 실시간 결제 시스템처럼 15분 RTO, 거의 0에 수렴하는 RPO가 필요한 워크로드가 있는가 하면, 내부 정산 시스템처럼 24시간 RTO·4시간 RPO로도 충분한 워크로드가 있습니다. 모든 시스템에 동일한 수준의 보호를 적용하는 건 비용 낭비입니다. 랜섬웨어 상황에서는 다릅니다. 랜섬웨어 공격 시에는 하드웨어는 멀쩡한데 파일이 암호화됩니다. 감염되지 않은 복구 지점을 찾아 과거로 계속 되돌려야 하기 때문에, RPO를 얼마나 촘촘하게 잡느냐가 복구 가능성을 직접 결정합니다. 물리적 재해 대비 DR과는 설계 기준이 다릅니다. MST: DR을 하드웨어 구매에서 클라우드 소비로 전통적인 DR 구성의 가장 큰 문제는 비용 구조입니다. 원격지에 주 데이터센터와 비슷한 규모의 하드웨어를 상시 대기 상태로 유지해야 한다는 것, 평소엔 아무것도 안 하는 장비에 계속 돈을 써야 한다는 겁니다. Nutanix의 MST(Multicloud Snapshot Technology)는 이 구조를 바꿉니다. 온프레미스 AHV 클러스터의 VM과 볼륨 그룹 스냅샷을 AWS S3나 Azure Blob 같은 오브젝트 스토리지로 주기적으로 복제합니다. 비싼 블록 스토리지 DR 사이트 대신, 기가바이트당 과금되는 저렴한 클라우드 스토리지에 복구 지점을 쌓아두는 방식입니다. 최대 300TB 규모의 보호 환경을 지원하고, 실제 재해가 발생하거나 복구 훈련을 돌릴 때만 NC2(Nutanix Cloud Clusters) 노드를 동적으로 프로비저닝해서 데이터를 재수화(Rehydrate)합니다. 배포 모델 선택이 실무에서 중요합니다. 실제 설계에서는 보통 이 둘을 섞습니다. 핵심 결제나 인증 시스템에는 Pilot Light, 내부 협업 도구나 개발 인프라에는 Zero Compute를 적용하는 식입니다. Prism Central 7.5.1과 함께 배포된 Instant Restore 기능은 이 회복 시나리오의 응답성을 한층 끌어올려 줍니다. IaC로 복구 절차를 코드에 굳혀두기 DR 구성이 아무리 잘 돼 있어도, 막상 장애가 났을 때 복구 절차를 매뉴얼 보면서 수동으로 따라가야 한다면 대응 속도가 나오지 않습니다. IaC(Infrastructure as Code)를 사용하면 Nutanix 환경 전체(VM 구성, 네트워크 설정, 스토리지 정책)를 Terraform 코드로 정의하고 Git으로 버전 관리할 수 있습니다. 재해 상황에서 관리자는 감염된 환경에서 수동으로 복구 스크립트를 타이핑하는 대신, 사전에 구문 검증과 보안 스캔이 완료된 코드로 지리적으로 격리된 안전한 클라우드 리전에 인프라를 즉각 프로비저닝할 수 있습니다. 부수적인 효과도 있습니다. 모든 변경 사항이 Git 커밋 로그로 남기 때문에 DORA 같은 규제가 요구하는 감사 추적이 자동으로 충족됩니다. 담당자가 바뀌거나 조직 개편이 있어도 운영 노하우가 코드에 남아 있습니다. GitOps 워크플로우와 결합하면 구성 오류(Configuration Drift)도 원천 차단됩니다. MST와 IaC를 함께 쓰면 흐름은 이렇습니다. 평소에는 MST가 온프레미스 스냅샷을 S3로 주기적으로 복제하고, Pilot Light 클러스터가 클라우드에서 최소한의 불씨를 유지합니다. 재해가 발생하면 Terraform 코드가 트리거되어 클라우드 리소스를 프로비저닝하고, MST 스냅샷에서 데이터를 복원해 서비스를 재개합니다. 이 시퀀스가 자동화되어 있으면 RTO를 수 시간에서 수십 분 수준으로 줄이는 게 현실적으로 가능해집니다. Flow Network Security와 마이크로 세그멘테이션 가시성과 회복력의 마지막 퍼즐은 보안입니다. 랜섬웨어나 APT 공격이 성공하는 전형적인 패턴은 하나의 VM을 뚫은 뒤 내부 네트워크를 수평으로 이동하며 피해를 키우는 방식입니다. Nutanix의 FNS(Flow Network Security)는 이 수평적 이동(Lateral Movement)을 막는 데 초점이 맞춰져 있습니다. VM과 애플리케이션 카테고리 단위로 세분화된 방화벽 정책을 부여하는 마이크로 세그멘테이션 기능을 기본 제공합니다. 감염된 VM이 인접한 중요 VM이나 관리망으로 확산하려 할 때, 하이퍼바이저 내장 네트워크 계층에서 이를 차단합니다. 복잡한 마이크로 세그멘테이션 룰셋이 적용될 때 발생하는 패킷 검사 연산 부하는 NVIDIA BlueField DPU 같은 스마트 닉으로 오프로딩하는 구조를 활용하면, 보안 정책을 넓게 적용하면서도 애플리케이션 성능 저하를 피할 수 있습니다. 오늘 우리 환경을 점검해보려면 마지막으로 현재 상태를 스스로 점검해볼 수 있는 질문들을 남깁니다. ✅ 지금 모니터링 도구가 메트릭, 로그, 트레이스를 연결해서 보여주고 있는가, 아니면 각각 따로 수집하고 있는가? ✅ NCM 또는 Datadog·Dynatrace 같은 통합 관측성 플랫폼을 통해 Nutanix 인프라 레이어와 애플리케이션 레이어를 같은 화면에서 보고 있는가? ✅ DR 목표(RTO/RPO)가 비즈니스 영향 평가(BIA)와 연결되어 워크로드별로 차등 적용되고 있는가? ✅ 복구 절차가 매뉴얼로만 존재하는가, 아니면 IaC 코드로 자동화되어 있는가? ✅ MST를 쓰고 있다면, Zero Compute와 Pilot Light 중 어떤 모델이 우리 워크로드 특성에 맞는지 검토해봤는가? ✅ FNS 마이크로 세그멘테이션 정책을 설정한 뒤 최근 리뷰를 한 적이 있는가? 인프라는 절대로 망가지지 않도록 만들 수 없습니다. 하지만 망가졌을 때 얼마나 빠르고 예측 가능하게 복구할 수 있는지는 설계 단계에서 결정됩니다. 위의 질문들에 자신 있게 답할 수 있다면, 금요일 저녁 알람도 조금은 다른 마음으로 받을 수 있을 겁니다.
Chapter1. 탐색적 데이터 분석_(2) 책 읽기 전.. 1.5 데이터 분포 탐색하기 “평균과 표준편차만 보고 데이터 전체를 안다고 할 수 있을까?” 답은 아님 (이게 무슨 말이냐햄..) 예를 들어 두 데이터가 평균과 표준편차가 비슷해도, A : █ █████ █████████ █████ █ B : ███ ███ ███ ███ 처럼 모양은 완전히 다를 수 있음 그래서 1.5에서는 분포의 모양을 직접 확인하는 방법이 등장함 책에서는 백분위수와 상자그림, 도수분포표와 히스토그램, 밀도 그림을 다룸 1.6 이진 데이터와 범주 데이터 탐색하기 “숫자가 아닌 데이터를 어떻게 요약할까?” 수치형은 평균을 계산할 수 있지만, 서울 + 부산 + 대구 ────────────── 3 같은 계산은 의미가 없음 그래서 개수(count), 비율(proportion), 최빈값(mode) 등이 중요해짐 그리고 여기서 기댓값(Expected Value) 과 확률(Probability) 도 나오는데, 지금은 처음부터 복잡한 확률수학이라고 겁먹지 말고: “여러 가능한 결과가 있을 때, 각 결과가 얼마나 자주/얼마나 가능하게 나타나는가?” 라는 관점으로 읽자햄 1.7 상관관계 두 변수가 같이 움직인다는 것은 정확히 무슨 뜻일까?” 그리고 반드시 기억할 전제: 상관관계가 있다고 해서 원인과 결과 관계라는 뜻은 아니다. 예를 들어 아이스크림 판매량과 물놀이 사고가 같이 증가한다고 해서: 아이스크림 ↓ 물놀이 사고 라고 할 수는 없어. 오 이거 강사님이 말씀하신 내용이다햄!! 둘 다 여름철 기온 같은 제3의 변수와 관계있을 수 있음 여기서는 특히 상관계수 숫자만 보지 말고 산점도(scatterplot) 를 같이 봐야 하는 이유를 생각하면서 읽기 1.8 두 개 이상의 변수 탐색하기 “변수의 종류가 다르면 어떤 그래프를 써야 할까?” 변수 조합 생각할 질문 수치형 × 수치형 둘이 같이 증가/감소하는가? 범주형 × 범주형 그룹별 비율이 다른가? 범주형 × 수치형 그룹마다 수치 분포가 다른가? 여러 변수 두 변수 관계가 제3의 변수에 따라 달라지는가? 1.9 마치며 데이터 하나를 받았을 때 어디서부터 EDA를 시작해야 하지? 데이터 확인 ↓ 변수의 종류 확인 ↓ 수치형 / 범주형 구분 ↓ 하나의 변수 탐색 ├─ 중심 ├─ 변이 └─ 분포 ↓ 두 변수 관계 탐색 ├─ 수치 × 수치 ├─ 범주 × 범주 └─ 범주 × 수치 ↓ 여러 변수 관계 확인 항상 느끼는 거지만 EDA도 너무 어렵다햄.. 이번 범위에서 특히 놓치지 않았으면 하는 4가지 통계량만 보지 말고 분포의 모양을 같이 본다. 변수의 자료형에 따라 적절한 요약·그래프가 달라진다. 상관계수 하나만 믿지 말고 산점도를 같이 본다. 관계가 있다고 해서 인과관계라고 결론 내리지 않는다. 책 읽는 중.. 1.5 데이터 분포 탐색하기 용어 정리 용어 영어 핵심 의미 백분위수 Percentile 데이터를 정렬했을 때 특정 비율에 해당하는 위치 사분위수 Quartile 데이터를 4등분하는 지점. Q1=25%, Q2=50%, Q3=75% 상자도표 Boxplot 중앙값, Q1, Q3, IQR, 이상치 등을 한눈에 보여주는 그래프 도수 Frequency 특정 값이나 구간에 데이터가 몇 개 있는지 도수분포표 Frequency Table 구간별 데이터 개수를 표로 정리한 것 구간 / 빈 Bin 연속된 수치 데이터를 일정 범위로 나눈 구간 히스토그램 Histogram 각 구간에 몇 개의 데이터가 있는지 막대로 표현 밀도 Density 특정 영역에 데이터가 상대적으로 얼마나 몰려 있는지 밀도 추정 Density Estimate 데이터가 어떤 분포 모양을 가지는지 부드러운 곡선으로 추정 커널밀도추정 KDE 각 데이터에 작은 커널을 놓고 합쳐 부드러운 밀도곡선을 만드는 방법 커널 Kernel KDE에서 각 데이터 위치에 놓는 작은 함수/언덕 대역폭 Bandwidth KDE 곡선을 얼마나 부드럽게 만들지 결정하는 값 헷갈리는 용어 및 질문 용어 핵심 의미 모멘트(Moment) 분포의 여러 특징을 수치적으로 표현하기 위한 개념 왜도(Skewness) 분포가 좌우 어느 방향으로 얼마나 비대칭인지 나타냄 양의 왜도 오른쪽 꼬리가 긴 분포 음의 왜도 왼쪽 꼬리가 긴 분포 첨도(Kurtosis) 분포의 꼬리와 극단값 특성을 나타내는 값 바이올린 플롯(Violin Plot) KDE를 좌우 대칭으로 표현해 분포의 모양과 밀도를 보여주는 그래프 모멘트 구조 1차 → 중심과 연결 2차 → 분산과 연결 3차 → 왜도 4차 → 첨도 더 읽을 거리 자료 연결되는 개념 Boxplot 가이드 보관본 상자도표, 중앙값, Q1·Q3, IQR, 수염, 이상치 Density Estimation in R 밀도추정, KDE, 분포의 모양 Basics of Histograms 히스토그램, bin, 구간 크기에 따른 그래프 변화 Box-plot with R Tutorial 상자도표를 실제 데이터로 그리는 방법 ⭐ Matthew Conlen – KDE 커널밀도추정, 커널, bandwidth를 직접 조절하며 이해 1.6 이진 데이터와 범주 데이터 탐색하기 용어 정리 용어 영어 핵심 의미 이진 데이터 Binary Data 가능한 값이 2개뿐인 데이터. 예: Yes/No 범주형 데이터 Categorical Data 값이 숫자 크기보다 그룹을 나타내는 데이터 비율 Proportion 전체 중 특정 범주가 차지하는 비중 최빈값 Mode 데이터에서 가장 자주 등장하는 값 기댓값 Expected Value 가능한 결과와 각 결과의 확률을 고려한 장기적인 평균값 확률 Probability 어떤 사건이 일어날 가능성을 0~1 사이로 나타낸 값 막대그래프 Bar Chart 범주별 개수나 비율을 막대로 비교하는 그래프 더 읽을 거리 자료 연결되는 개념 Misleading Graph 막대그래프·파이차트 해석, 축 조작, 왜곡된 시각화, 그래프를 비판적으로 보는 법 1.7 상관관계 용어 정리 용어 영어 핵심 의미 상관관계 Correlation 두 변수가 함께 변하는 정도 상관계수 Correlation Coefficient 두 변수의 선형적 관계를 -1~1 사이의 숫자로 표현 양의 상관관계 Positive Correlation X가 증가할 때 Y도 증가하는 경향 음의 상관관계 Negative Correlation X가 증가할 때 Y는 감소하는 경향 무상관 No Correlation 뚜렷한 선형 관계가 없는 상태 상관행렬 Correlation Matrix 여러 변수 사이의 상관계수를 표로 정리한 것 산점도 Scatterplot 두 수치형 변수의 값을 점으로 찍어 관계를 보는 그래프 히트맵 Heatmap 숫자의 크기를 색으로 표현하는 그래프 더 읽을 거리 자료 연결되는 개념 Freedman, Pisani & Purves – Statistics 상관계수, 양·음의 상관관계, 산점도, 상관관계 해석 상관관계 ≠ 인과관계 , 상관계수만으로 관계를 판단할 때의 주의점 1.8 두 개 이상의 변수 탐색하기 용어 정리 수치형 × 수치형 용어 영어 핵심 의미 산점도 Scatterplot 두 수치 변수의 관계를 점으로 표현 육각형 구간 그래프 Hexagonal Binning / Hexbin 좌표공간을 육각형으로 나누고 각 구간의 데이터 개수를 색으로 표현 등고선 도표 Contour Plot 같은 밀도를 가진 영역을 선으로 연결한 그래프 밀도 Density 특정 공간에 데이터가 얼마나 많이 몰려 있는가 범주형 × 범주형 용어 영어 핵심 의미 분할표 / 교차표 Contingency Table 두 범주형 변수의 조합별 개수를 표로 정리 교차표 Crosstab 범주 A와 범주 B가 함께 나타난 빈도를 나타냄 범주형 × 수치형 그래프 특징 Boxplot 중앙값·사분위수·이상치 비교 Violin Plot 분포의 밀도와 모양 비교 여러 변수 시각화 용어 영어 핵심 의미 다변량 분석 Multivariate Analysis 세 개 이상의 변수를 동시에 탐색 조건화 Conditioning 다른 변수의 값을 기준으로 데이터를 나눠 관계를 살펴봄 패싯 Facet 범주별로 그래프를 여러 개 나눠서 보여주는 방식 헷갈리는 용어 및 질문 더 읽을 거리 자료 연결되는 개념 Modern Data Science with R 여러 변수의 관계 탐색, 다변량 시각화, EDA ⭐ ggplot2: Elegant Graphics for Data Analysis Grammar of Graphics, 그래프 구성 요소, 변수에 따라 그래프 선택하기 Josef Fruehwald ggplot2 Tutorial ggplot2를 활용한 실제 시각화 작성 1.9 마치며 정리 데이터 │ ▼ 자료형 확인 │ ├─ 수치형 └─ 범주형 │ ▼ 변수 하나 탐색 │ ├─ 위치 │ ├─ 평균 │ └─ 중앙값 │ ├─ 변이 │ ├─ 표준편차 │ ├─ IQR │ └─ MAD │ └─ 분포 ├─ Boxplot ├─ Histogram └─ KDE │ ▼ 변수 두 개 이상 탐색 │ ├─ 수치 × 수치 │ ├─ Scatterplot │ ├─ Hexbin │ └─ Contour │ ├─ 범주 × 범주 │ └─ Crosstab │ └─ 범주 × 수치 ├─ Boxplot └─ Violin Plot │ ▼ 여러 변수 → Facet / Conditioning 책 읽은 후.. 퀴즈 총 10문제 중에 2문제를 틀렸다햄.. 2문제는 왜도 와 범주형 × 수치형 → 상자도표 에 대한 문제였다햄.. 범주형×수치형 그래프는 상자 도표로 왜 그리는지를 모르겠어서 이해하는데 조금 걸렸다햄..ᄒ 나의 생각 매 미션마다 EDA를 진행하지만.. 시각화를 하는데 어느 그래프가 적절할지 아직도 잘 모르겠다햄... 특히 여태 배운 그래프를 종류 하나가 아닌 여러가지를 합쳐서 만드는 방법도 있어서.. 적절하게 선택하는 방법이 어려운 것 같다햄..
LAG는 한 장비 안의 포트끼리만 묶을 수 있어서, 장비가 통째로 죽으면 소용이 없었습니다. MLAG(Multi-chassis Link Aggregation)는 물리적으로 다른 두 스위치를 하나의 논리적인 스위치처럼 구성 해서 이 문제를 풉니다. Fail over와 Load Balance 같은 효과를 얻을 수 있어요. 그림 왼쪽이 물리 구성입니다. vEOS10과 vEOS11이 Eth2, Eth3로 서로 연결되어 있고, 아래쪽 vEOS는 Eth1, Eth2로 각각 두 장비에 연결됩니다. 오른쪽 논리 구성에서는 아래쪽 스위치 입장에서 위쪽 두 대가 한 대로 보여요. 그래서 두 링크를 하나의 LACP로 묶어 쓸 수 있습니다. STP였다면 둘 중 한 링크는 막혔을 구성인데, MLAG에서는 두 링크를 모두 쓸 수 있다는 점이 큰 차이예요. MLAG 설정 mlag configuration domain-id mlag local-interface Vlan4094 peer-address 192.168.1.2 peer-address heartbeat 192.168.2.2 peer-link Ethernet2 dual-primary detection delay 1 action errdisable all-interfaces dual-primary recovery delay mlag 1 non-mlag 3 reload-delay mlag 1 reload-delay non-mlag 10 한쪽 장비의 설정이고, 줄별로 보면 이렇습니다. domain-id : 두 장비를 같은 MLAG 도메인으로 묶는 이름입니다. 양쪽이 똑같아야 해요(대소문자 구분). local-interface : peer-link 위에서 MLAG 제어 통신에 쓰는 VLAN 인터페이스입니다. peer-address : 상대 장비의 주소입니다. peer-link : 두 장비를 잇는 링크입니다. peer-address heartbeat : peer-link와 별개의 경로로 상대가 살아있는지 확인하는 주소입니다. dual-primary detection / recovery , reload-delay : 아래에서 설명합니다. 여기서 말하는 mlag 포트 는 mlag 도메인으로 묶인 포트들이고, non-mlag 포트 는 그 외 일반 포트입니다. dual-primary MLAG에서는 두 장비가 primary와 secondary로 역할을 나눠 가집니다. 그런데 두 장비 사이의 제어를 담당하는 peer-link가 끊기면 , secondary 장비는 primary가 죽었다고 판단하고 자신도 primary로 승격 합니다. 이게 dual-primary예요. 양쪽이 서로의 상태를 모르는 채 각자 primary로 트래픽을 처리하게 됩니다(split-brain). 이를 막으려고 dual-primary detection 을 설정합니다. peer-link가 끊겼더라도 heartbeat 링크로 primary가 살아있음을 확인하면, secondary 장비의 포트를 errdisable 상태로 바꿉니다. action errdisable all-interfaces 는 peer-link를 제외한 모든 이더넷 인터페이스를 끈다는 뜻이에요. 설정에 같이 있는 delay 값들은 포트를 다시 올리는 타이밍을 정합니다. dual-primary recovery delay : dual-primary 상태가 해소된 뒤, 포트를 다시 올리기까지 기다리는 시간입니다. mlag 포트용과 non-mlag 포트용을 따로 정합니다. reload-delay : 장비가 재부팅된 뒤 포트를 올리기까지 기다리는 시간입니다. 이것도 mlag/non-mlag를 따로 정해요. 알아두면 좋은 점 heartbeat는 꼭 peer-link와 다른 경로 여야 의미가 있습니다. peer-link가 끊길 때 heartbeat도 같이 끊기면 상대가 죽은 건지 링크만 끊긴 건지 구분할 수 없기 때문이에요. 그래서 관리망(Management) 같은 별도 경로를 쓰는 경우가 많고, 이 설정은 양쪽 장비에 모두 해야 합니다. 슬라이드의 delay 값(1, 3, 10)은 실습용으로 짧게 준 값입니다. 실제 운영에서는 기본값을 쓰는 걸 권장하는 자료가 많아요. 아래쪽 스위치와는 정적 LAG보다 LACP( channel-group mode active )로 협상 하는 걸 권장합니다. 확인 명령어는 show mlag , show mlag detail 입니다. dual-primary 설정 여부와 delay 값도 여기서 볼 수 있어요. 정리 MLAG는 서로 다른 두 스위치를 하나의 논리 스위치처럼 묶어서, 장비 단위 장애에도 통신을 유지하고 두 링크를 모두 쓰게 해줍니다. peer-link가 끊겨 양쪽이 모두 primary가 되는 dual-primary는 heartbeat로 상대 생존을 확인하고 secondary의 포트를 errdisable로 막아서 해결합니다.
현장에서 보안 아키텍처를 논의하다 보면 대화가 결국 한 지점으로 수렴하는 경우가 많다. "로그는 쌓이는데 SIEM 라이선스 비용이 감당이 안 된다"는 이야기다. 매일 테라바이트 단위로 쏟아지는 텔레메트리를 전부 넣자니 예산이 버텨주지 않고, 줄이자니 랜섬웨어 사후 조사에 필요한 기록이 남지 않는다. 이 딜레마는 사실 기술 문제이기 전에 아키텍처 문제다. SIEM이 설계된 시대와 지금의 데이터 규모가 근본적으로 달라졌기 때문이다. SIEM이 비싼 이유: 스키마 온 라이트의 구조적 한계 SIEM은 데이터가 들어오는 시점에 구조를 확정하는 스키마 온 라이트(Schema-on-Write) 방식으로 동작한다. 로그가 유입될 때마다 실시간으로 파싱하고, 필드를 매핑하고, 인덱스를 생성해야 하기 때문에 처리량이 늘어날수록 컴퓨팅 비용이 거의 선형으로 따라온다. GB/Day 기준의 라이선스 구조가 이 방식과 맞물리면, 데이터가 많을수록 비용이 폭발하는 구조가 된다. 결국 많은 조직이 SIEM에 넣는 데이터를 스스로 제한하게 된다. 방화벽 플로우 로그는 잘라내고, DNS 쿼리는 샘플링하고, 엔드포인트 프로세스 이벤트는 중요도 기준으로 걸러낸다. 비용을 줄인 건 맞지만, 나중에 침해 사고를 조사할 때 필요한 흔적을 함께 지운 셈이기도 하다. 보안 데이터 레이크가 다르게 접근하는 방식 보안 데이터 레이크(SDL)는 이 문제를 다른 지점에서 공략한다. 데이터를 원형 그대로 저장해두고, 구조 부여는 조회 시점으로 미루는 스키마 온 리드(Schema-on-Read) 방식이다. Delta Lake나 Apache Iceberg 같은 개방형 테이블 포맷을 클라우드 오브젝트 스토리지(S3, GCS 등) 위에 얹으면, 스토리지 비용은 대폭 낮추면서도 스키마 진화(Schema Evolution)나 타임 트래블 쿼리 같은 분석 기능을 쓸 수 있는 레이크하우스 환경을 구성할 수 있다. 아래 표는 두 접근법의 핵심 차이를 정리한 것이다. 비교 항목 전통적 SIEM 보안 데이터 레이크 (SDL) 데이터 구조 부여 방식 스키마 온 라이트 스키마 온 리드 포맷 생태계 벤더 종속적 개방형 (Iceberg, Delta Lake 등) 비용 구조 유입량(GB/Day) 기반 스토리지/컴퓨팅 분리 과금 보존 기간 30~90일 내외 12개월 이상 가능 주요 데이터 경로 Hot Path 중심 (전체의 10~20%) Warm/Cold Path 중심 (80~90%) 핵심 유스케이스 실시간 탐지, 컴플라이언스 보고 위협 헌팅, 포렌식, AI/ML 학습 단, 이 구분이 SIEM을 대체한다는 의미는 아니다. 두 방식은 서로 다른 역할을 맡는 게 맞다. 데이터 늪에 빠지지 않으려면 SDL을 도입할 때 가장 흔한 실수는 "일단 다 저장하면 되겠지"라는 접근이다. 실제로는 메타데이터 관리와 거버넌스 체계 없이 구축한 데이터 레이크가 데이터 늪(Data Swamp)으로 전락하는 경우가 적지 않다. 원하는 데이터를 찾을 수 없고, 쿼리 비용이 예측 불가능해지고, 결국 아무도 쓰지 않는 스토리지 더미가 된다. 파싱 단계에서 100% 완벽을 추구하는 것도 현실적으로 무리다. 실무에서는 95% 정확도를 목표로 하고, 파싱에 실패한 나머지를 데드 레터 큐(Dead Letter Queue, DLQ)로 분리해두는 전략이 유용하다. 역설적으로 이 실패 데이터가 새로운 공격 패턴의 조기 신호가 되는 경우가 있기 때문에, 그냥 버리는 것보다 격리해두는 편이 낫다. 수집과 저장 사이: 텔레메트리 파이프라인의 역할 원시 데이터를 그대로 SDL에 밀어 넣으면 저장 비용이 SDL 도입 효과를 상쇄한다. 수집 단계와 저장 단계 사이에 보안 텔레메트리 파이프라인을 두는 이유가 여기 있다. 파이프라인이 하는 일은 크게 세 가지다. 첫째, 보안 가치가 낮은 정상 트래픽을 사전에 걸러내는 필터링이다. 잘 설계된 필터링 규칙은 최종 저장 비용을 실질적으로 절반 이상 줄여준다. 둘째, Geo-IP 매핑이나 위협 인텔리전스 피드를 로그와 실시간으로 결합하는 보강(Enrichment)이다. 저장 시점이 아니라 수집 시점에 컨텍스트를 붙여두면 이후 분석 속도가 달라진다. 셋째, Apache Kafka 같은 메시지 큐를 사용한 비동기 버퍼링이다. 수집과 처리를 분리해두면 로그가 급증하는 구간에서 파이프라인이 무너지지 않는다. 벤더 간 데이터 통합: OCSF와 OpenTelemetry 팔로알토 방화벽 로그와 크라우드스트라이크 EDR 로그는 필드 이름부터 구조까지 다 다르다. 여러 벤더의 텔레메트리를 하나의 레이크에 모으면 통합 분석이 사실상 불가능해진다. OCSF(Open Cybersecurity Schema Framework)는 이 문제를 표준화 레이어로 해결한다. 서로 다른 소스의 로그를 user.name , auth_protocol 같은 공통 필드 체계로 매핑해두면, 나중에 분석 도구를 교체하거나 소스를 추가해도 파이프라인을 처음부터 다시 짤 필요가 없다. OpenTelemetry와 함께 파이프라인의 기반으로 삼으면 특정 벤더에 종속되지 않는 데이터 아키텍처를 만들 수 있다. SIEM과 SDL을 같이 쓰는 방법 SIEM을 완전히 걷어내는 건 대부분의 조직에서 현실적이지 않다. 실시간 탐지와 컴플라이언스 보고는 여전히 SIEM이 더 잘하는 영역이기 때문이다. 실용적인 접근은 두 시스템을 역할에 따라 분리하는 하이브리드 아키텍처다. 전체 텔레메트리의 10 20% 정도, 즉 즉각적인 탐지와 대응이 필요한 핵심 이벤트는 SIEM으로 라우팅한다. 방화벽 플로우 로그나 DNS 쿼리처럼 실시간 경보보다 장기 분석 가치가 더 큰 나머지 80 90%는 SDL로 보낸다. 이렇게 경로를 나누면 SIEM 라이선스 부담을 줄이면서도 두 시스템의 장점을 함께 유지할 수 있다. 텔레메트리 파이프라인이 라우팅 로직을 담당하게 하면, 어떤 데이터를 어느 경로로 보낼지를 코드로 관리할 수 있어 운영 복잡도도 낮아진다. 장기 데이터 보존이 복구 속도를 결정한다 랜섬웨어 감염 이후 어제 백업본을 복원하면 끝이라고 생각하기 쉽지만, 실제 침해 조사에서는 그게 거의 통하지 않는다. 공격자들은 감염 수개월 전부터 환경에 잠복하는 경우가 많다. 백업 시점이 이미 오염된 상태라면, 복원 이후에도 같은 문제가 반복된다. RTO(복구 시간 목표)를 실질적으로 단축하려면 감염 이전으로 충분히 거슬러 올라가는 텔레메트리가 있어야 한다. SDL이 12개월 이상의 데이터를 저비용으로 보존할 수 있다는 점은 이 맥락에서 단순한 스토리지 이점 이상의 의미가 있다. 수개월 전의 프로세스 이벤트와 네트워크 플로우를 조회해서 최초 진입점과 정확한 감염 시점을 찾을 수 있는 것이 SDL의 포렌식 가치다. SDL과 텔레메트리 파이프라인의 조합은 보안 가시성을 유지하면서 비용 구조를 현실적으로 관리할 수 있는 방향이다. 하지만 기술 선택보다 먼저 해야 할 게 있다. 조직에서 어떤 데이터를 왜 보존해야 하는지에 대한 명확한 기준이다. 그 기준 없이 SDL을 도입하면 앞서 말한 데이터 늪이 된다. 현재 운영 중인 환경에서 어떤 로그가 SIEM에 들어가고 어떤 게 걸러지고 있는지, 그 판단 기준이 어디서 왔는지를 한번 검토해보는 것이 좋은 출발점이 될 것이다.
MLAG와 VRRP를 함께 쓰는 환경에서 트래픽이 어떻게 흐르는지, 벤더 교육 자료의 도식을 보고 EVE-NG에서 직접 구성해서 확인해봤습니다. 상향 트래픽은 자료와 같았는데 하향 트래픽은 실제 동작과 다르다고 판단했고, 실습하면서 MAC 테이블에서 재미있는 점도 하나 발견했어요. 먼저 구성 MLAG로 묶인 스위치 두 대(Primary, Secondary)가 있고, VRRP로 게이트웨이를 이중화합니다. VRRP는 Active-Standby로 동작하니 Primary가 게이트웨이 역할(master)을 맡아요. 위쪽에는 L3 장비가 두 스위치에 모두 연결되어 있고, 아래쪽 서버는 MLAG 포트로 두 스위치에 이중 연결됩니다. 트래픽 방향은 이렇게 부르겠습니다. 상향 트래픽 : 서버 → L3 장비 (다른 대역으로 나가는 트래픽) 하향 트래픽 : L3 장비 → 서버 왼쪽이 상향, 오른쪽이 하향 트래픽입니다. 상향 트래픽은 서버가 게이트웨이로 보내는 트래픽이라 라우팅을 Primary가 처리하고, 서버의 트래픽이 LAG 분산 때문에 Secondary로 들어오면 peer-link를 거쳐 Primary로 넘어가요(점선). 반면 하향 트래픽은 Primary든 Secondary든 서버로 직접 전달합니다. 아래에서 이 부분을 자세히 보겠습니다. 발견 1: Secondary도 트래픽을 처리한다 VRRP가 Active-Standby로 동작하는 건 맞습니다. 하지만 그렇다고 Standby 스위치가 아무것도 못 하는 건 아니에요. VRRP의 핵심은 서버가 다른 대역으로 나가려고 게이트웨이(VIP)로 보내는 트래픽, 즉 라우팅이 필요한 트래픽은 모두 Primary를 거친다 는 점입니다. 위 그림의 상향 트래픽이 여기에 해당해요. 하향 트래픽은 다릅니다. MLAG 스위치 두 대와 서버는 L2로 연결되어 있어서, Secondary도 ARP를 통해 서버의 IP와 MAC을 이미 알고 있어요. 그래서 ECMP로 하향 트래픽이 Secondary 쪽으로 들어오더라도, peer-link로 Primary에 넘기지 않고 바로 서버로 보낼 수 있습니다. EVE-NG에서 실습하면서 Secondary가 이렇게 트래픽을 직접 처리하는 것을 확인했어요. 참고로 Arista 문서도 MLAG 환경에서는 VRRP보다 VARP를 권장합니다. VRRP는 게이트웨이 MAC으로 오는 트래픽이 peer-link를 타고 master까지 가야 하지만, VARP는 두 스위치가 모두 직접 라우팅하기 때문이에요. 발견 2: MAC이 Po5가 아니라 Po10으로 학습된다 그림에서 vEOS47이 보낸 트래픽이 빨간 화살표를 따라 vEOS46을 거쳐 위쪽 vEOS로 올라간다고 해볼게요. 이때 vEOS46의 MAC 테이블에는 vEOS47의 MAC이 Eth1이 속한 channel group인 Po10 으로 잡힙니다. 여기까지는 당연합니다. MLAG는 MAC 테이블을 동기화합니다. 그러면 vEOS45는 vEOS47의 MAC을 어떻게 학습할까요? 저는 이 MAC이 vEOS46 쪽에 있으니 vEOS46으로 이어지는 Po5 로 학습할 거라고 예상했어요. 그런데 실제로 확인해보니 vEOS45도 vEOS47의 MAC을 Po10으로 학습 하고 있었습니다. 이유는 Po10이 두 장비에서 같은 MLAG 포트로 동작하기 때문이에요. vEOS47은 두 스위치에 모두 연결되어 있으니, vEOS45에도 vEOS47로 이어지는 로컬 Po10이 있습니다. MLAG가 동기화한 MAC은 상대 장비로 넘어가는 경로(peer-link)가 아니라 같은 MLAG 포트의 로컬 멤버 에 매핑돼요. Arista 문서에도 MLAG에서 개별 장비가 학습한 MAC은 동기화되어 적절한 인터페이스에 매핑된다고 나옵니다. 덕분에 vEOS47 앞으로 가는 트래픽이 vEOS45로 들어와도 peer-link를 거치지 않고 자기 쪽 Po10으로 바로 보낼 수 있어요. MLAG가 peer-link 사용을 최소화하도록 설계된 모습입니다. 알아두면 좋은 점 peer-link는 기본적으로 제어 통신이 중심이고, 한쪽 장비에만 연결된 단일 연결(single-homed) 장비가 있을 때 데이터 트래픽이 지나갑니다. MAC 테이블은 show mac address-table 로, MLAG 상태는 show mlag 로 확인합니다. 양쪽 장비의 MAC 테이블을 나란히 보면 같은 MAC이 어떤 포트로 학습됐는지 비교할 수 있어요. 정리 VRRP는 Active-Standby지만 Standby 스위치도 L2로 서버를 알고 있어서 하향 트래픽을 직접 처리할 수 있고, 라우팅이 필요한 상향 트래픽만 Primary를 거칩니다. MLAG가 동기화한 MAC은 peer-link가 아니라 같은 MLAG 포트(Po10)의 로컬 멤버로 학습되어, peer-link를 거치지 않고 트래픽을 보낼 수 있습니다.
문제 링크 : https://school.programmers.co.kr/learn/courses/30/lessons/70129 난이도 : Lv.2 분류 : 요약 : 문제를 내 말로 한두 줄 접근 방법 입력 크기 / 시간 제한으로 판단한 방향: 사용한 알고리즘 / 자료구조와 선택 이유: 풀이 코드 class Solution { public int[] solution(String s) { int convert = 0, removed = 0; while (!"1".equals(s)) { int ones = 0; for (int i = 0; i < s.length(); i++) { if (s.charAt(i) == '1') ones++; } removed += s.length() - ones; // 제거한 0의 개수 s = Integer.toBinaryString(ones); // 길이(=1의 개수)를 2진수로 convert++; } return new int[]{convert, removed}; } } 복잡도 시간: O() 공간: O() 막혔던 부분 / 틀린 이유 계속 문자열 변환을 해서 메모리가 많이 사용되었다. toBinaryString() 이라는 함수의 존재를 몰랐다.
보안 담당자라면 한 번쯤 이런 로그를 마주쳤을 것이다. 내부망에서 발생한 이상 접속인데, 정식 계정으로 정상 시간대에 들어온 것으로 찍혀 있다. 방화벽도 통과했고, VPN 인증도 마쳤다. 문제는 그 계정 주인이 그 시간에 사무실에 있지 않았다는 것이다. 이게 더 이상 특수한 사례가 아니다. 오늘날 기업 보안 사고의 상당 부분은 '뚫린 문'이 아니라 '열린 문'에서 시작된다. 합법적으로 발급된 계정, 정상적으로 배포된 업데이트, 검증받은 협력업체의 원격 접속—그 신뢰받는 경로 안에 위협이 숨어 있다. 이 글은 그런 환경에서 왜 제로 트러스트 아키텍처(ZTA)와 공급망 위험 관리(C-SCRM)가 함께 이야기되어야 하는지를 실무적인 시각에서 풀어보려 한다. VPN이 '고속도로'가 된 경위 전통적인 기업 보안 모델의 전제는 단순했다. 사내 네트워크 안에 들어온 존재는 신뢰할 수 있다는 것이다. 경계 밖은 위험하고 경계 안은 안전하다는 이른바 '성곽과 해자(Castle-and-Moat)' 구조다. VPN은 그 구조에서 외부 사용자가 안전하게 성문을 통과하는 수단이었다. 문제는 그 성문을 통과하는 순간 내부망 전체에 대한 접근 경로가 열렸다는 것이다. 네트워크 계층(L3) 전체를 대상으로 하는 광범위한 연결이었기 때문에, VPN 계정 하나만 탈취하면 공격자가 내부 서버와 데이터베이스를 마음대로 이동할 수 있었다. 횡적 이동(Lateral Movement)이라고 부르는 이 움직임을 레거시 VPN 환경에서는 실시간으로 추적하거나 차단하기가 사실상 어렵다. 접속 진입점에서의 인증 절차는 꼼꼼하지만, 일단 내부망에 안착한 이후의 움직임은 애플리케이션 수준의 감사 로그조차 제대로 남지 않는 경우가 많기 때문이다. 여기에 VPN 게이트웨이가 인터넷에 상시 노출되어야 한다는 구조적 문제가 겹친다. Shodan 같은 도구를 쓰면 패치가 적용되지 않은 게이트웨이를 손쉽게 탐색할 수 있고, 알려진 CVE를 이용한 원격 코드 실행으로 인프라 전체가 장악될 수 있다. 게다가 SMS OTP 같은 정적 자격 증명 체계는 중간자 공격(AiTM)에 취약하고, 세션이 수립된 이후 기기가 악성코드에 감염되거나 비정상적인 대량 다운로드가 발생해도 이를 실시간으로 차단하는 동적 제어 기능이 없다. 2013년 미국 타겟(Target) 백화점 침해 사고는 이 구조적 취약점의 교과서 같은 사례다. 공격자들은 타겟 본사를 직접 공격하는 대신, 타겟 매장의 냉난방 시스템(HVAC)을 관리하던 외부 협력업체를 먼저 해킹했다. 피싱 메일로 VPN 계정 자격 증명을 탈취한 후, 그 계정으로 내부망에 접속해 결제망까지 횡적 이동했다. 냉난방 유지보수 시스템과 POS 결제망 사이에 논리적인 세그멘테이션이 전혀 없었던 것이다. 이렇게 결제망에 도달한 공격자들은 단말기 메모리에 평문으로 존재하는 결제 데이터를 가로채는 RAM 스크래핑 기법으로 4,000만 건의 신용카드 정보를 탈취했다. 기업이 입은 직접 손실은 2억 달러를 넘었고, '한 번 인증되면 믿어버리는' 암묵적 신뢰가 어떤 결과로 이어지는지를 적나라하게 보여줬다. 제로 트러스트의 출발점: "이미 뚫렸다고 가정하라" 이런 경험들이 쌓이면서 보안 업계가 받아들이게 된 전제가 하나 있다. '침해 가정(Assume Breach)'이다. 내부 네트워크라고 해서 절대 안전하지 않으며, 이미 어딘가는 침해되었을 수 있다는 가정 아래 시스템을 설계해야 한다는 것이다. 제로 트러스트 아키텍처(ZTA)는 이 전제 위에서 출발한다. NIST SP 800-207이 제시하는 ZTA의 핵심 구조는 '제어 평면(Control Plane)'과 '데이터 평면(Data Plane)'을 엄격히 분리하는 것이다. 제어 평면의 정책 엔진(Policy Engine)은 접속 요청이 들어오면 사용자의 신원, 기기의 패치 상태, 접속 위치와 시간대, 평소 행동 패턴을 종합해 신뢰 점수(Trust Score)를 산출하고, 정책 관리자(Policy Administrator)가 접근 허용 여부를 결정한다. 실제 데이터 트래픽은 이 제어 평면의 명시적 승인이 떨어진 이후에만, 데이터 평면의 정책 집행 지점(PEP)을 통해 격리된 암호화 터널로 흐른다. 이 구조의 요점은 단 하나다. 어떤 사용자도, 어떤 기기도, 어떤 네트워크 위치에 있든 자동으로 신뢰받지 않는다. 매 접속, 매 세션마다 다시 검증된다. NIST가 제시하는 7대 실천 원칙을 현장 언어로 요약하면 이렇다. 내부망 트래픽이라도 외부와 동일한 수준의 암호화와 상호 인증을 적용한다. 권한은 특정 시점에 특정 자원에 한정해서만 부여하고, 그 세션이 끝나면 회수한다. 기기의 패치 상태, EDR 에이전트 동작 여부를 상시 검증한다. SMS OTP를 넘어 피싱이 구조적으로 불가능한 인증을 쓴다. 그리고 모든 통신 로그를 머신러닝 피드백 루프로 연결해 정책을 지속적으로 고도화한다. VPN에서 ZTNA로: 달라지는 게 뭔가 제로 트러스트 철학을 실제 원격 접속 인프라에 구현한 것이 ZTNA(Zero Trust Network Access)다. VPN과 근본적으로 다른 지점이 몇 가지 있다. 첫 번째는 인프라 은폐다. ZTNA 환경에서 내부 자원은 인터넷에서 아예 보이지 않는다. VPN은 외부 접속을 받기 위해 게이트웨이가 공개 인터넷에 노출되어야 했지만, ZTNA는 내부에서 클라우드 브로커로 아웃바운드 연결만 생성한다. 공격자가 정찰 도구를 써도 포트나 IP 자체를 탐지할 수 없으니 DDoS나 익스플로잇 공격의 표적 자체가 사라진다. 이것을 '다크 클라우드(Dark Cloud)' 효과라고 부른다. 두 번째는 접근 범위다. VPN이 네트워크 전체를 열어줬다면, ZTNA는 개별 애플리케이션 단위로 접근 경계를 그린다. 인사 시스템에만 권한이 있는 사람은 재무 데이터베이스 네트워크 세그먼트로 라우팅 자체가 되지 않는다. 이 마이크로 세그멘테이션(Micro-segmentation)이 타겟 사고 같은 횡적 이동 공격 킬 체인을 원천 차단하는 핵심 메커니즘이다. 세 번째는 신뢰 평가 방식이다. VPN은 최초 로그인 시점에 단 한 번 인증하면 끝이지만, ZTNA는 세션 중에 기기가 악성코드에 감염되거나 이례적인 데이터 접근 패턴이 감지되면 즉시 세션을 종료하고 접근을 차단한다. 멀티 클라우드 환경이 중심이 된 지금은 ZTNA 단독보다 SASE(Secure Access Service Edge) 아키텍처로 확장 구축하는 경우가 많다. ZTNA에 클라우드 접근 보안 브로커(CASB), 보안 웹 게이트웨이(SWG), SD-WAN을 통합한 구조로, 트래픽을 본사 데이터센터로 끌어왔다가 내보내는 백홀링(Backhauling) 병목을 없애면서 전 세계 어느 위치의 사용자에게도 일관된 보안 정책을 적용할 수 있다. 구글 워크스페이스, AWS 같은 SaaS/IaaS 혼용 환경에서 특히 효과적이다. 공급망 공격: 정문을 피해 배송 트럭을 노린다 내부망을 ZTNA로 단단하게 묶었다고 해서 끝이 아니다. 현대 기업은 수백 개의 협력업체, 벤더 솔루션, 오픈소스 라이브러리가 복잡하게 얽힌 공급망 생태계 위에 서 있다. 고도로 조직화된 공격 그룹은 보안이 촘촘한 대기업 본망을 직접 뚫기보다, 해당 기업에 소프트웨어를 납품하거나 시스템을 유지보수하는 제3자를 먼저 공략한다. 외부 생태계를 오염시킨 다음 정상적인 업데이트 채널을 타고 내부로 침투하는 이 전술은 이제 공격 그룹의 표준 전략이 됐다. 2020년 솔라윈즈(SolarWinds) 사태가 이 전술의 완성형을 보여준다. 러시아 SVR 소속으로 강하게 추정되는 해킹 그룹 UNC2452는 전 세계 수만 개 기관이 IT 인프라 모니터링에 쓰던 솔라윈즈 Orion 플랫폼의 빌드 시스템 자체를 침투했다. 소스코드가 컴파일되는 순간, SolarWinds.Orion.Core.BusinessLayer.dll 이라는 정상 파일에 SUNBURST 백도어를 삽입했다. 이렇게 변조된 DLL은 솔라윈즈의 정식 디지털 서명이 찍힌 채 공식 업데이트 채널을 통해 배포됐다. 수십억 원짜리 EDR 솔루션도, 차세대 방화벽도 이 파일을 막지 못했다. 제조사의 정당한 인증서를 가지고 있었으니까. 신뢰 사슬(Chain of Trust)의 근간이 농락당한 것이다. 백도어는 설치 후 12~14일간 샌드박스 탐지를 피하기 위해 아무 활동도 하지 않다가, 이후 도메인 생성 알고리즘(DGA)으로 C2 서버와 통신하며 고가치 타겟을 선별해 심층 침투를 시작했다. 내부에서는 탈취한 관리자 자격 증명으로 정상적인 시스템 관리 업무처럼 위장해 수개월간 발각되지 않았다. 전 세계 18,000여 개 기관이 노출됐고 미국 연방 정부 주요 부처가 포함됐다. 2021년 카세야(Kaseya) 사태도 같은 패턴이다. IT 관리 서비스 제공업체(MSP)들이 공통으로 쓰는 카세야 VSA의 제로데이 취약점을 익스플로잇해 1,500여 개 하위 고객사 네트워크 전체에 랜섬웨어를 동시에 살포했다. 한 번의 취약점 공략이 1대다(1-to-N) 연쇄 폭발로 이어진 전형적인 사례다. 최근엔 오픈소스 생태계를 노리는 공격도 증가하고 있다. 유명 라이브러리와 철자가 미세하게 다른 악성 패키지를 공용 저장소에 업로드해 개발자의 실수를 유도하는 타이포스쿼팅(Typosquatting), 오픈소스 리포지토리에 악성 코드를 직접 커밋하는 방식이 횡행한다. AI 모델 개발 파이프라인에서 외부 API나 검증되지 않은 데이터셋에 과도하게 의존하는 것도 새로운 공급망 취약성 축으로 부상하고 있다. C-SCRM: 방어선을 공급망 끝까지 확장하는 일 공급망 공격에 대응하기 위한 체계가 사이버 공급망 위험 관리(C-SCRM, Cyber Supply Chain Risk Management)다. 미국, EU, 한국 등 주요국 보안 당국이 강력히 권고하고 있고 일부는 의무화됐다. NIST SP 800-161이 제시하는 C-SCRM은 3계층 거버넌스 구조로 구현한다. 조직 레벨(Tier 1)에서는 CISO와 이사회가 공급망 보안의 큰 그림을 그린다. 벤더 계약서에 침해 사고 발생 시 책임 조항과 보안 모니터링 허용 조건을 법적 강제성이 있는 형태로 표준화하고, 기업이 외부 서비스 도입 시 감내할 위험 범위(Risk Appetite)를 명확히 선언하는 것이 핵심이다. 비즈니스 프로세스 레벨(Tier 2)에서는 각 부서가 사용하는 제3자 솔루션의 위험도를 평가하고 핵심 미션이 중단됐을 때의 영향도를 분석한다. 시스템 레벨(Tier 3)에서는 실무자가 구체적인 통제 수단을 구현한다. 소프트웨어 배포 파이프라인 무결성 검증, 오픈소스 취약점 스캐닝 자동화, 3rd Party 인력 접속에 대한 JIT 통제와 세션 레코딩이 여기에 해당한다. 이 중에서 최근 가장 주목받는 실무 도구가 SBOM(소프트웨어 자재 명세서)다. 식품 성분표처럼, 소프트웨어를 구성하는 오픈소스 모듈과 제3자 컴포넌트, 버전 정보를 기계 판독 가능한 표준 규격으로 문서화하는 것이다. SBOM의 실질적 가치는 Log4j 같은 제로데이 취약점이 갑자기 공개되는 상황에서 드러난다. SBOM 인벤토리가 없는 조직은 수백 대 서버를 일일이 스캔하며 취약 모듈을 찾느라 며칠을 쓴다. SBOM이 있으면 데이터베이스 조회 몇 분이면 어느 서버의 어떤 애플리케이션에 문제가 있는지 핀포인트로 확인하고, 공격자의 익스플로잇 전에 패치 적용이나 격리를 선제적으로 수행할 수 있다. 이 구성 요소 검증 프로세스는 AI 모델 개발 파이프라인에서 학습 데이터셋 출처와 외부 API 안전성을 담보하는 데도 가장 중요한 기초 공사가 될 전망이다. 3rd Party 원격 접속 통제: 가장 취약한 고리를 조이는 법 이론적으로 ZTA와 C-SCRM을 어떻게 결합하느냐고 물으면, 가장 현실적인 답은 외부 유지보수 인력의 원격 접속 경로 통제에서 시작하라는 것이다. 침해 통계를 보면 직접 공격보다 보안 통제가 느슨한 협력업체 계정을 탈취해 우회 침투하는 것이 훨씬 경제적인 해킹 루트로 꼽힌다. 타겟 백화점이 그랬고, 수많은 글로벌 침해 사고가 그 패턴을 반복해 보여줬다. 가장 먼저 바꿔야 할 관행은 상시 권한이다. 협력업체 엔지니어에게 계약 기간 내내 언제든 접속 가능한 계정을 주는 것은, 그 계정이 탈취됐을 때 365일 24시간 접속 경로를 열어두는 것과 같다. 제로 스탠딩 프리빌리지(ZSP, Zero Standing Privileges) 원칙은 유휴 상태일 때 접근 권한을 완전히 소거하는 것이다. 이 위에 적시 권한 부여(JIT, Just-in-Time Access)가 얹힌다. 유지보수 작업이 필요할 때 엔지니어가 작업 목적, 대상 시스템, 소요 시간을 명시해 접속 요청을 상신한다. 승인이 떨어지면 해당 시간 동안만 최소 권한이 활성화되고, 종료 즉시 자동 회수된다. 계정 자격 증명이 탈취되더라도 작업 시간 외에는 접속 경로 자체가 없으니 무기화 가능성이 시간이라는 축으로 극적으로 줄어든다. 인증도 강화가 필요하다. SMS OTP 방식의 MFA는 정교하게 위조된 로그인 페이지를 통해 세션 토큰을 가로채는 중간자 공격(Adversary-in-the-Middle, AiTM)에 무력하다. FIDO2/WebAuthn 규격의 하드웨어 보안 키(YubiKey 등)나 TPM 칩과 암호학적으로 결합한 디바이스 기반 인증처럼, 구조적으로 피싱 자체가 불가능한 피싱 방지용 MFA(Phishing-resistant MFA)로 전환해야 한다. 접속 중 행위는 전부 기록해야 한다. JIT와 강력한 MFA를 거쳐 내부에 진입했다고 통제가 끝나는 게 아니다. CLI 명령어 입력과 GUI 화면 조작 전체를 특권 접근 관리(PAM) 시스템을 통해 CCTV 녹화하듯 실시간으로 세션 레코딩하고, 변조가 불가능한 별도의 감사 스토리지에 저장한다. 이 로그는 평시에는 이상 행위 탐지 머신러닝의 학습 자료로, 사고 발생 시에는 포렌식의 핵심 증거물로 쓰인다. OT 환경이라면 더 엄격한 구조가 요구된다. 정유, 발전, 반도체 공장 같은 산업 제어 시스템은 망이 뚫리면 가동 중단과 인명 피해로 직결된다. IT망과 OT망 사이에는 IDMZ(Industrial Demilitarized Zone, 산업용 비무장지대)를 두고, 외부 벤더는 인터넷이나 IT망을 통해 OT 자산에 직접 접속하는 것이 절대 불가하다. 반드시 IDMZ 안의 점프 호스트(Jump Host)를 경유해 신원 확인과 악성코드 검사를 받은 후, 별도의 2단계 세션을 맺어야만 내부 제어 기기의 특정 포트로 제한된 접근이 허용된다. ISA/IEC-62443과 퍼듀 모델(Purdue Model)을 참조 아키텍처로 삼는 이유다. 어디서부터 시작할까 CISA의 제로 트러스트 성숙도 모델(ZTMM 2.0)이 강조하듯, ZTA는 솔루션을 구매하면 끝나는 프로젝트가 아니다. 수년에 걸쳐 낡은 업무 구조를 뜯어고치는 여정이다. 시작점은 가시성 확보다. 내가 어떤 자산을 보유하고 있는지, 외부 인력의 접속이 어디서 어떻게 이루어지고 있는지 파악하지 못한 상태에서 ZTNA를 도입하는 것은 의미가 없다. 자산과 접속 경로 인벤토리를 구축하고, 기기 보안 상태 점검 체계를 세우는 것이 첫 단계다. 그다음은 레거시 VPN을 점진적으로 대체하면서 피싱 방지 MFA와 마이크로 세그멘테이션을 적용하는 단계다. 전환 부담이 있기 때문에 고위험 접속 경로, 특히 3rd Party 유지보수 채널부터 시작하는 것이 현실적이다. 이 시기에 C-SCRM 정책을 조달 계약과 연동시키고 SBOM 도입 파이럿을 시작하는 것이 좋다. 최종적으로 목표하는 상태는 이상 징후를 시스템이 자동으로 포착하고 위협을 즉각 격리하는 인텔리전스 기반 자동화 체계다. 기기 포스처 진단, 사용자 행위 분석(UEBA), JIT 권한 부여가 자동화 루프로 연결되고, SIEM과 SOAR가 연계돼 선제적 대응이 가동되는 구조다. KISA의 평가 가이드라인도 같은 맥락에서 정체성(Identity), 기기(Device), 네트워크, 애플리케이션, 데이터의 5개 기둥(Pillars) 각각에 대해 초기·발전·최적화 단계별로 성숙도를 진단하도록 권고하고 있다. 어느 기둥이 가장 취약한지를 먼저 직시하는 것, 그것이 출발점이다. 마치며 VPN 중심의 경계 보안이 한계에 달한 것은 돌이킬 수 없는 사실이다. 클라우드와 원격 근무가 일상화된 환경에서 사내 네트워크라는 경계 자체가 의미를 잃었고, 솔라윈즈와 카세야 같은 사례들은 신뢰받는 공급망 채널이 얼마나 치명적인 공격 벡터가 될 수 있는지를 실물로 증명했다. 제로 트러스트와 C-SCRM은 이 환경에서 보안 체계를 재설계하는 두 축이다. 하나는 내부 접근 구조를 어떻게 바꿀 것이냐의 문제이고, 다른 하나는 외부와의 연결 고리를 어떻게 관리할 것이냐의 문제다. 이 둘이 유기적으로 맞물려야 완전한 방어 체계가 된다. 완벽한 침투 차단은 가능하지 않다. 하지만 침해 범위를 제어하고, 사고가 터졌을 때 조직이 쓰러지지 않고 운영을 이어갈 수 있는 복원력(Business Resilience)은 설계할 수 있다. 그 설계를 지금 시작해야 할 이유가 여기에 있다.