Загружаем каталог…
Загружаем каталог…
공부 기록 선형 회귀 기본 형식 지도 학습 선형 모델: 속성들의 선형 조합을 통해 예측하는 함수를 학습하는 모델 독립변수 x로 종속변수 y를 예측하는 모델 $$ f(\mathbf x) = \mathbf \beta_1x_1 + \beta_2x_2 + {...} + \beta_nx_n+b = \beta^T\mathbf x+\mathbf b $$ b를 $\beta$ 에 포함해서 표현할 수도 있다. $\beta, b$: 학습을 통해 얻어야하는 파라미터 학습 방법 선형 회귀의 손실함수: 일반적으로 MSE(평균 제곱 오차) 사용 최소제곱법 입력 데이터가 하나인 경우 (*이런 경우는 거의 음슴.. 속성은 여러 개인 경우가 훨씬 많으니..) $f(x_i) =\beta_ix_i+b$ $MSE = \frac 1m\sum\limits_{i=1}^m(y_i-\beta x_i-b)^2$ $\beta, b$를 찾는 것은 $\frac 1m\sum\limits_{i=1}^m(y_i-\beta x_i-b)^2$를 최소화 하는 과정임. $E_{(\beta, b)} = \frac 1m\sum\limits_{i=1}^m(y_i-\beta x_i-b)^2$ 을 손실 함수로 쓰는 이유 → 볼록 함수 이기 때문에 미분해서 0되는 지점이 최소점임을 알 수 있기 때문 해당 손실 함수가 볼록함수인 것 증명 방법 1. $(y_i-\beta x_i-b)^2$ **각각이 볼록함수임을 증명,** 2. **그것들의 합이 볼록함수임을 증명 ⇒ 볼록함수의 합은 볼록이다.** 증명 필기 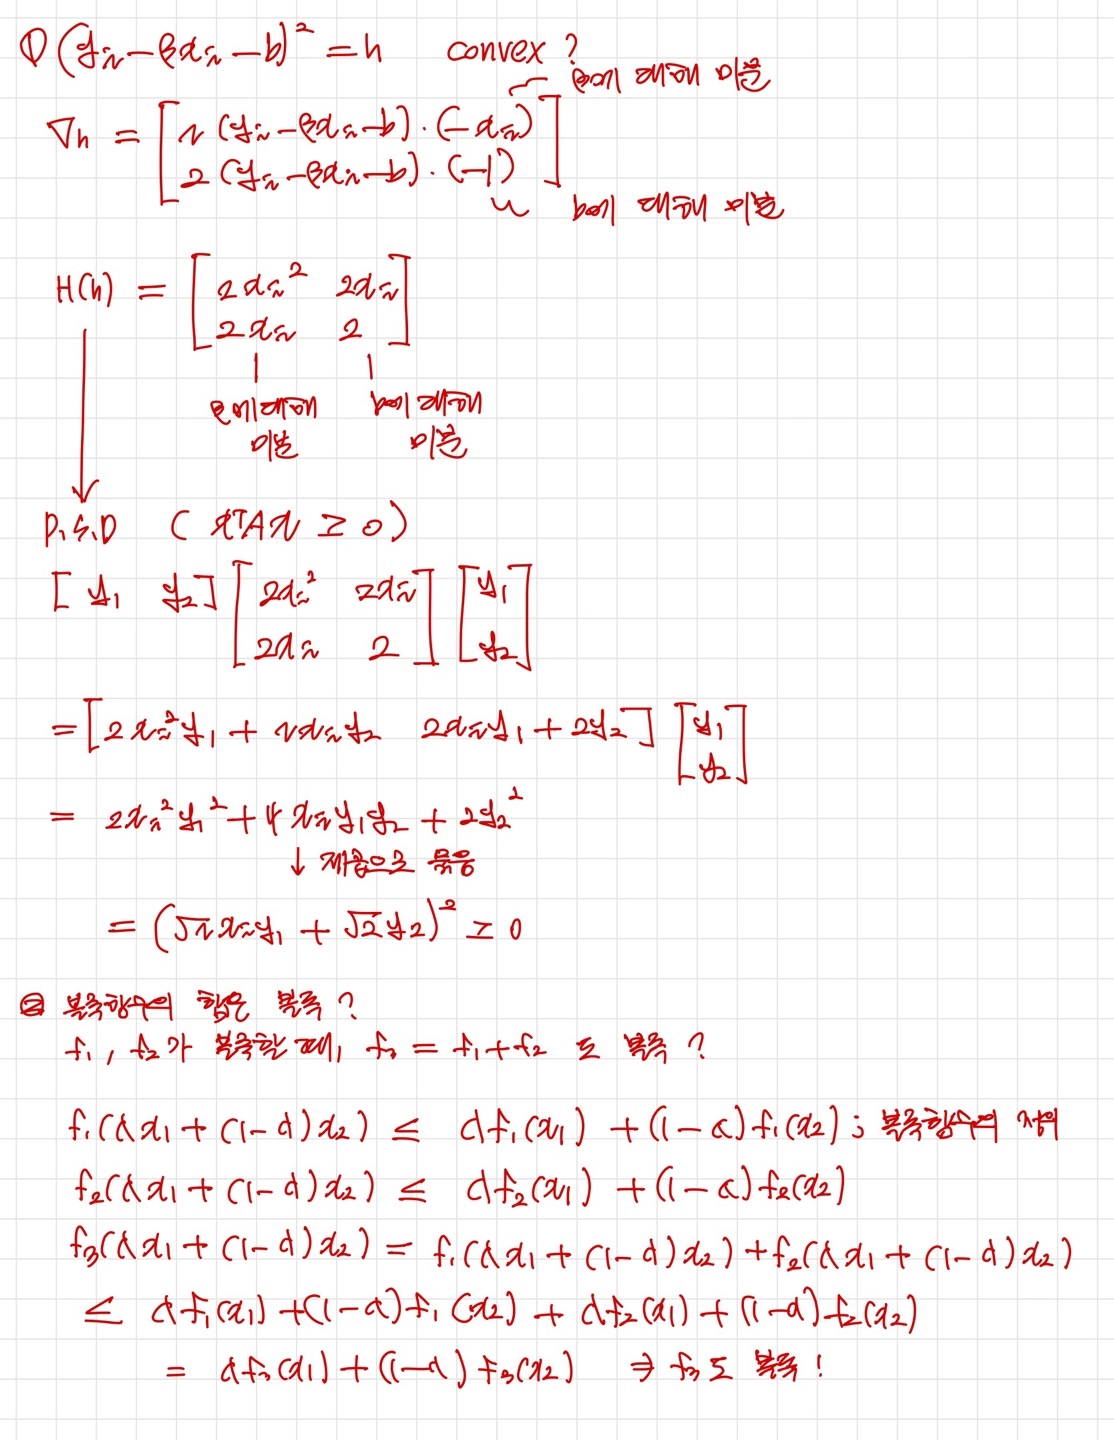 - $E_{(\beta, b)} = \frac 1m\sum\limits_{i=1}^m(y_i-\beta x_i-b)^2$ 을 $\beta$ 와 $b$에 대해 편미분 → $\beta$ 와 $b$도 식으로 표현할 수 있음 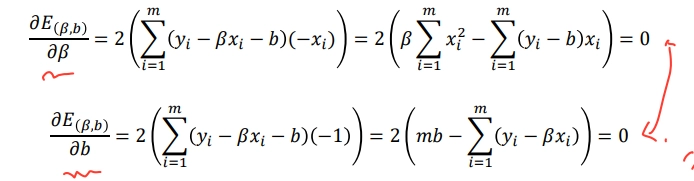 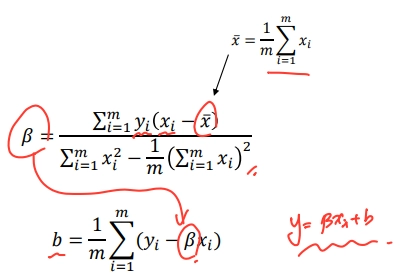 입력 데이터가 여러개인 경우 : 다변량 선형 회귀 $f(x_i) =b+\beta_1x_{i1}+\beta_2x_{i2}+{...}+ \beta_dx_{id}$ $\mathbf {E_{\hat \beta}=(y-X\hat\beta)^T(y-X\hat\beta)}$ (= 값 상수임)를 최소로 하는 $\hat \beta^*$ 을 찾는 것이 목표 필기 위의 필기 에 의해 $\mathbf {X^TX\hat\beta = X^Ty}$ 에서 $\mathbf {X^TX}$가 full rank 라면, (= 선형독립 이라면 = 역행렬이 있다면) $$ \mathbf {\hat \beta=(X^TX)^{-1}X^Ty} $$ 항상 똑같은 최적의 선형식이 도출된다. ⇒ 당연함. $\hat \beta$는 주어진 것들로 구해지기 때문 기하학적 표현 개념 수학적 표현 의미 열공간 $col(X)$ 입력 벡터(열 벡터)들이 만드는 공간(평면) 예측값 $\hat y = X\hat\beta$ 열공간 위의 어떤 점 오차 $\epsilon = y-X\hat\beta$ y와 예측값 사이의 벡터 정규방정식(normial equation) $X^T(y-X\hat\beta) =0$ 오차가 열공간에 직교함 → 오차가 0이 되어야 함. → 직교 조건에 해당 로그 선형 회귀 $\mathbf {\ln y = \beta^Tx+b}$: 데이터셋에서 대응하는 결과값 데이터가 지수 척도에서 변화한다면? === y가 선형이 아니라 지수적으로 증가하거나 감소 ⇒ 비선형 함수도 선형처럼 풀 수 있다. 로지스틱 회귀 ; 분류에 사용함 결과값이 1,0 인 이진 분류 문제라면, 선형 회귀 모델이 생성한 예측값을 0/1로 반환해 줘야함 단위 계단 함수 but 미분 불가능 로지스틱 함수 = 시그모이드 함수 $[-\infin, \infin]$ 의 입력값 $\mathbf x$를 $[0, 1]$의 출력값 $\mathbf y$로 바꾸어주는 함수 → 미분 가능 로지스틱 회귀: 선형회귀 + 로지스틱 함수 출력값: ‘클래스 1로 분류될 확률’ 출력값 > 0.5 = 1 출력값 < 0.5 = 0 $$ y = \frac{1}{1+e^{-(w^T+b)}} $$ $$ \ln \frac y{1-y} = z = w^T+b $$ ⇒ 분류를 해줄 뿐만 아니라 근사확률에 대한 예측도 가능함. ⇒ **선형 회귀 모델의 예측값을 로짓에 근사해보자** 학습 방법 손실 함수 우도(Likelihood): 확률의 곱셈 클수록 좋음(= 확률이 클수록 좋다) → 클수록 실제 데이터를 잘 맞추는 것이기 때문 우도를 최대한 크게하는 $\beta$를 찾아야함. ⇒ Maximum Likelihood Estimation (MLE) - $y_i$가 크면 $f(x_i)^{y_i}$의 값이 크게 나옴 - 반대로, $1-y_i$가 크면 $(1-f(x_i))^{1-y_i}$의 값이 크게 나옴 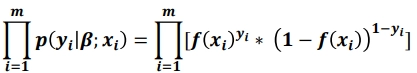 - 전체 샘플 개수 m 일 때 현재의 파라미터 $\beta$가 얼마나 좋은 파라미터인지 알 수 있음 - 확률과 우도(Likelhood) - 필기 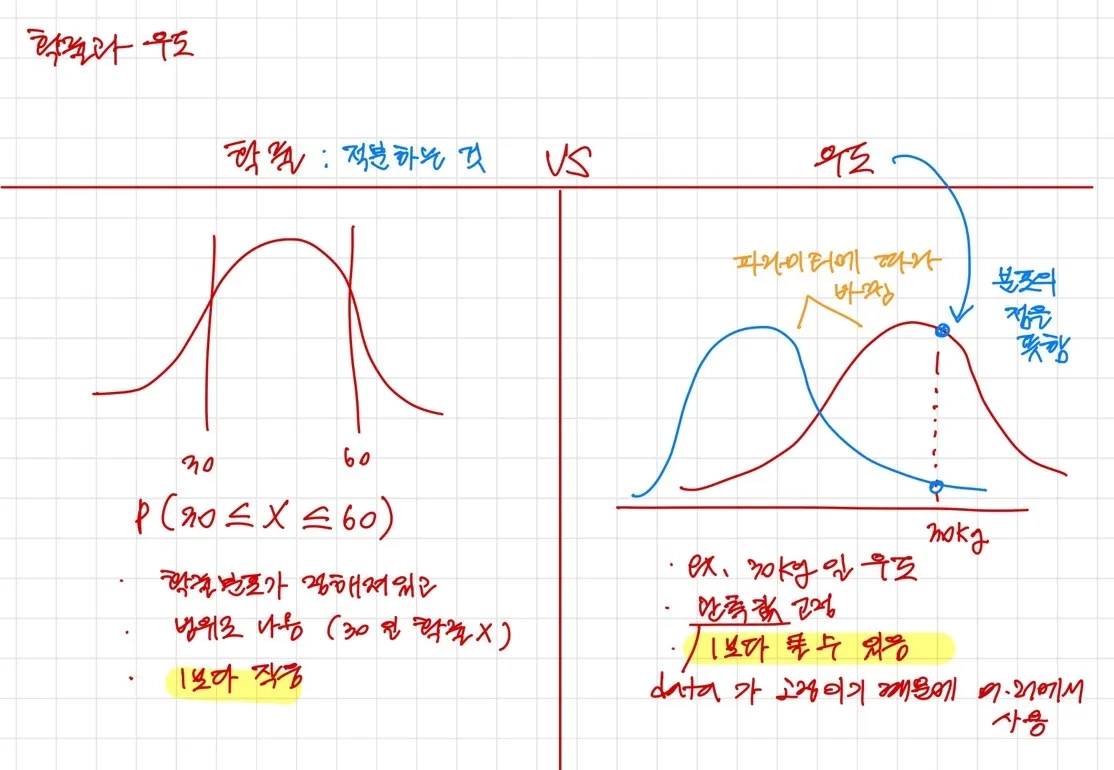 - Log-likelihood: 위의 우도 식에 로그 씌운 것 → 곱셈이므로 로그 씌우면 덧셈으로 바뀔 수 있음 - 우도는 확률의 곱셈인데, 확률이 작다면 ᄌᆬᆬᆬ작아질 수 있음 그러면 곤란해짐 → 로그를 씌우자. 그럼 덧셈이니까. 그리고 계산 쉬워짐 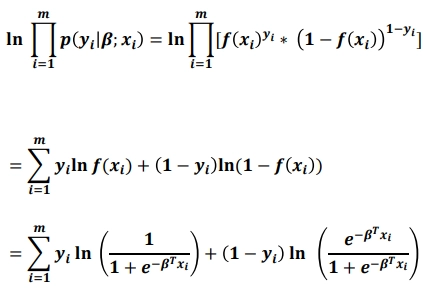 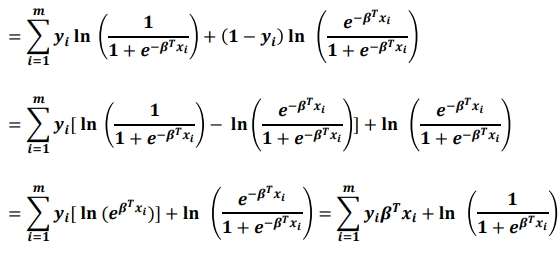 ⇒ 로지스틱 회귀: 선형회귀 + 로지스틱 함수 인 이유 손실함수 = 최소화 해야하는 값 ⇒ 작을수록 좋다. 우도는 $\beta$가 얼마나 좋은 파라미터인지 나타냄 but, 손실함수는 $\beta$가 얼마나 안좋은 파라미터인지를 보여줌 따라서 값이 ‘작을수록’ 좋아야함 따라서 우도에 마이너스를 붙이면 ‘작을수록 좋다‘ 라는 손실함수의 조건을 충족 함 ⇒ 따라서 로짓 우도에 음의 부호(-)를 붙여서 손실함수로 사용한다.* - **$\beta$에 대해 고차이고, 미분 가능, 볼록 함수이다**. ⇒ 최소점이 1개이고, 그 최소점을 찾을 수 있다. == 최적해가 존재한다. - **닫힌해가 존재하지 않음 =**= $\beta$에 대한 식을 직접적으로 계산하는 명확한 공식이 존재하지 않는다. 학습 방법: 최적화 알고리즘 ⇒ 경사하강법, 뉴턴법 걍 방법 똑같음
То, что RADAR обнаружил и классифицировал для этой возможности. Это опубликованный источником текст, а не подтверждение, что предложение ещё действует.
[ML] 선형 회귀. 공부 기록 선형 회귀 기본 형식 지도 학습 선형 모델: 속성들의 선형 조합을 통해 예측하는 함수를 학습하는 모델 독립변수 x로 종속변수 y를 예측하는 모델 $$ f(\mathbf x) = \mathbf \beta_1x_1 + \beta_2x_2 + {...} + \beta_nx_n+b = \beta^T\mathbf x+\mathbf b $$ b를 $\beta$ 에 포함해서 표현할 수도 있다. $\beta, b$: 학습을 통해 얻어야하는 파라미터 학습 방법 선형 회귀의 손실함수: 일반적으로 MSE(평균 제곱 오차) 사용 최소제곱법 입력 데이터가 하나인 경우 (*이런 경우는 거의 음슴.. 속성은 여러 개인 경우가 훨씬 많으니..) $f(x_i) =\beta_ix_i+b$ $MSE =…
Открыть источник