Загружаем каталог…
Загружаем каталог…
Kaggle 타이타닉 train.csv (891행, 12컬럼)로 승객의 생존 여부( Survived )를 맞히는 이진 분류를 해봤다. 모델은 LogisticRegression 하나만 썼고, 흐름은 EDA → 전처리 → 분리 → 스케일링 → 학습·튜닝 → 평가 순서다. 데이터 누수부터 짚고 가기 순서에서 제일 신경 쓴 건 분리를 스케일링보다 먼저 하는 거였다. StandardScaler 를 전체 데이터에 fit 하면 평균과 표준편차 안에 테스트 데이터 정보가 섞여 들어간다. 그러면 테스트 점수가 실제보다 좋게 나올 수 있다. 그래서 학습 데이터로만 fit_transform 하고, 테스트 데이터에는 transform 만 했다. 데이터 살펴보기 결측치는 세 컬럼에 있다. 컬럼 결측치 Age 177 Cabin 687 Embarked 2 Cabin 은 891개 중 687개가 비어 있어서 아예 버렸다. describe() 를 보면 Age 는 최소 0.42, 최대 80이고 Fare 는 최소 0, 중앙값 14.45인데 최대가 512.33이다. 박스플롯에서도 두 컬럼 모두 수염 밖으로 튀는 점들이 보인다. 그래도 이상치로 보고 지우지는 않았다. 0.42세는 돌이 안 된 아기일 뿐이고, 512파운드짜리 요금도 1등석 승객이 비싼 표를 산 거라 충분히 있을 법한 값이다. 타깃 비율은 사망 61.6%, 생존 38.4%다. 반반이 아니라서 뒤에서 데이터를 나눌 때 이 비율을 신경 써야 한다. 전처리 PassengerId , Name , Ticket , Cabin 을 빼고, 동승 가족 수를 합친 FamilySize 를 하나 만들었다. titanic_df = df.drop(["PassengerId", "Name", "Ticket", "Cabin"], axis=1) titanic_df["FamilySize"] = titanic_df["SibSp"] + titanic_df["Parch"] + 1 titanic_df["Age"] = titanic_df["Age"].fillna(titanic_df["Age"].mean()) titanic_df["Age"] = titanic_df["Age"].astype(int) titanic_df["Sex"] = titanic_df["Sex"].map({"male": 0, "female": 1}) titanic_df = pd.get_dummies(titanic_df, columns=["Embarked"], drop_first=True, dtype=int) 코드를 하나씩 보면 이렇다. Age 결측치는 평균 으로 채우고 정수로 바꿨다. 나이 분포가 오른쪽으로 꼬리가 있어서 사실 중앙값(28)이 더 안전한 선택이긴 하다. 평균은 29.7이라 이 데이터에선 차이가 크진 않다. Sex 는 map 으로 male → 0, female → 1로 바꿨다. 값이 두 개뿐이라 원-핫이 필요 없고, 그냥 0/1 라벨로 충분하다. Embarked 는 C, Q, S 세 값을 get_dummies(drop_first=True) 로 원-핫 인코딩해서 Embarked_Q , Embarked_S 두 컬럼이 됐다. 여기서 주의할 점이 있다. 결측치 2개를 따로 채우지 않았기 때문에, 그 두 행은 두 더미가 모두 0이 되면서 결과적으로 C(셰르부르) 승객과 똑같이 취급된다. 의도대로 하려면 get_dummies 전에 최빈값(S)으로 채워주는 게 맞다. 최종 피처는 Pclass , Sex , Age , SibSp , Parch , Fare , FamilySize , Embarked_Q , Embarked_S 이렇게 9개다. 표준화를 고른 이유 Fare 는 절반이 14.45 아래인데 최댓값이 512다. Min-Max 정규화를 쓰면 512가 1이 되고 나머지 대부분이 0 근처로 몰려버린다. 그래서 평균 0, 표준편차 1로 맞추는 StandardScaler 를 골랐다. 학습/테스트 분리 X = titanic_df.drop("Survived", axis=1) y = titanic_df["Survived"] X_train, X_test, y_train, y_test = train_test_split( X, y, test_size=0.2, stratify=y, random_state=2026 ) # (712, 9) (179, 9) scaler = StandardScaler() X_train_scaled = scaler.fit_transform(X_train) X_test_scaled = scaler.transform(X_test) stratify=y 를 준 건 생존 비율이 6:4로 기울어 있어서다. 그냥 무작위로 자르면 학습 세트와 테스트 세트의 생존 비율이 서로 달라질 수 있고, 그러면 학습한 분포와 평가하는 분포가 어긋난다. 실제로 테스트 179명은 사망 110명, 생존 69명으로 원래 비율이 거의 그대로 유지됐다. 로지스틱 회귀와 C 튜닝 기본 설정으로 먼저 돌려봤다. lr = LogisticRegression() lr.fit(X_train_scaled, y_train) y_pred = lr.predict(X_test_scaled) # train score: 0.8034 # test score: 0.7877 모델이 학습하면서 스스로 찾는 값(회귀 계수, 절편)이 파라미터고, 학습 전에 사람이 정해주는 값이 하이퍼파라미터다. 로지스틱 회귀에서 대표적인 하이퍼파라미터가 규제 강도를 정하는 C 다. 작을수록 규제가 세진다. for C in [0.01, 0.1, 1, 10, 100]: model = LogisticRegression(C=C, max_iter=1000, random_state=2026) model.fit(X_train_scaled, y_train) ... C train test 0.01 0.8104 0.7821 0.1 0.7992 0.7877 1 0.8034 0.7877 10 0.8034 0.7877 100 0.8034 0.7877 0.1 이상부터는 테스트 정확도가 전부 같다. 피처가 9개뿐이라 규제를 풀어도 과적합될 여지가 별로 없는 것 같다. 기본값 C=1 을 그대로 써도 된다는 결론이다. 다만 이렇게 테스트 점수를 보고 하이퍼파라미터를 고르면 테스트 세트가 사실상 검증용으로 쓰이게 된다. 제대로 하려면 학습 데이터 안에서 교차 검증( GridSearchCV 같은)으로 고르고, 테스트 세트는 마지막에 한 번만 보는 게 맞다. 평가 Accuracy : 0.8045 Precision: 0.7656 Recall : 0.7101 F1 Score : 0.7368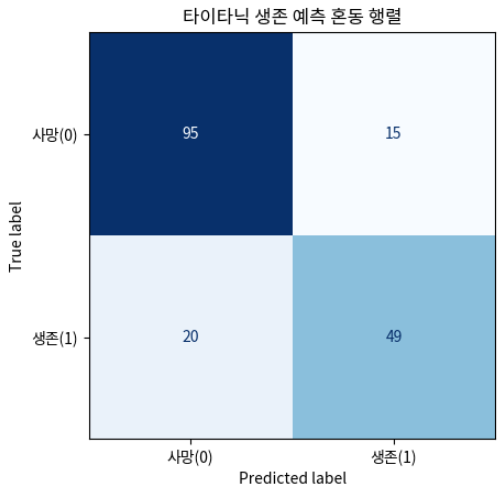 precision recall f1-score support 사망(0) 0.83 0.86 0.84 110 생존(1) 0.77 0.71 0.74 69 accuracy 0.80 179 macro avg 0.80 0.79 0.79 179 weighted avg 0.80 0.80 0.80 179 0.79 179 혼동 행렬을 풀어 쓰면, 실제 사망자 110명 중 92명은 맞혔고 18명은 생존으로 잘못 예측했다. 실제 생존자 69명 중에선 49명을 맞혔고 20명을 사망으로 예측했다. f1_score 는 기본적으로 양성 클래스(생존=1) 기준으로 계산된다. 정확도 78.8%보다 F1이 72.1%로 낮은 건, 수가 적은 생존 쪽이 사망 쪽(F1 0.83)보다 덜 맞았다는 뜻이다. 소수 클래스를 상대적으로 못 잡고 있는 셈이다. 어떤 오류가 더 치명적일까 구조 상황을 가정하면 실제 생존자를 사망으로 예측하는 쪽(FN, 20명) 이 더 위험하다. 살릴 수 있는 사람에게 구조 인력이 안 가게 되니까. 반대로 사망자를 생존으로 예측하면 인력이 헛걸음하는 정도로 끝난다. 이 관점이라면 생존 클래스의 재현율(현재 0.71)을 올리는 게 우선이다. 로지스틱 회귀는 predict_proba 로 확률을 주기 때문에, 0.5인 판정 기준을 낮춰서 재현율을 올리는 방법도 쓸 수 있다. 손볼 만한 부분 Embarked 결측치를 최빈값으로 채운 뒤 원-핫 인코딩하기 Age 를 중앙값으로 채우거나, 호칭(Mr, Mrs, Miss, Master)별 중앙값으로 채우기 FamilySize 는 SibSp + Parch + 1 이라 원본 두 컬럼과 정보가 겹친다. 하나만 남기거나 IsAlone 같은 다른 파생변수를 시도해볼 만하다 C는 교차 검증으로 고르기
То, что RADAR обнаружил и классифицировал для этой возможности. Это опубликованный источником текст, а не подтверждение, что предложение ещё действует.
머신러닝 실습. Kaggle 타이타닉 train.csv (891행, 12컬럼)로 승객의 생존 여부( Survived )를 맞히는 이진 분류를 해봤다. 모델은 LogisticRegression 하나만 썼고, 흐름은 EDA → 전처리 → 분리 → 스케일링 → 학습·튜닝 → 평가 순서다. 데이터 누수부터 짚고 가기 순서에서 제일 신경 쓴 건 분리를 스케일링보다 먼저 하는 거였다. StandardScaler 를 전체 데이터에 fit 하면 평균과 표준편차 안에 테스트 데이터 정보가 섞여 들어간다. 그러면 테스트 점수가 실제보다 좋게 나올 수 있다. 그래서 학습 데이터로만 fit_transform 하고, 테스트 데이터에는 transform 만 했다. 데이터 살펴보기 결측치는 세 컬럼에 있다. 컬럼 결측치 Age…
Открыть источник