Loading the catalog…
Loading the catalog…
데이터 분석 프로젝트 - '한국인의 삶을 파악하라' 이제 본격적으로 데이터 분석을 해보는 차례다. 한국복지패널데이터를 이용해 한국인의 삶을 파악하는 활동을 해보겠다. 데이터 분석 준비하기 install.packages("foreign") library(foreign) library(dplyr) #전처리 library(ggplot2) #시각화 library(readxl) #엑셀 파일 불러오기 #데이터 불러오기 raw_welfare <- read.spss(file = "Koweps_hpc10_2015_beta1.sav", to.data.frame = T) 복사본 만들기 원본은 복구해야 할 상황에 대비 welfare <- raw_welfare 코드북을 참고해 변수명 바꾸기 welfare <- rename(welfare, sex = h10_g3, birth = h10_g4, marriage = h10_g10, religion = h10_g11, income = p1002_8aq1, code_job = h10_eco9, code_region = h10_reg7) 데이터 분석 절차 1단계) 변수 검토 및 전처리 분석에 사용할 변수들을 전처리 변수의 특성을 파악하고 이상치를 정제한 다음 파생 변수 만들기 전처리는 분석에 활용할 변수 각각에 대해 실시한다 * 2단계) 변수 간 관계 분석 * 변수 간 관계를 파악하는 분석 데이터를 요약한 표를 만든 후 분석 결과를 쉽게 이해할 수 있는 그래프를 만든다 데이터를 분석해보자! 이제 이 데이터 분석 절차에 따라 _성별에 따른 월급 차이_를 알아보겠다. 1단계) 변수 검토 및 전처리 먼저 성별 변수의 전처리 과정이다. 변수 검토하기 변수의 타입 파악 > class(welfare$sex) [1] "numeric" 각 범주에 몇 명이 있는지 > table(welfare$sex) 1 2 7578 9086 #1은 7578명, 2는 9086명 전처리 코드북의 정보를 바탕으로 이상치를 검토하고 분석에서 이상치를 제외할 수 있도록 NA를 부여 welfare$sex <- ifelse(welfare$sex == 9, NA, welfare$sex) 값의 의미를 이해하기 쉽도록 문자로 변경 welfare$sex <- ifelse(welfare$sex == 1, "male", "female") 이제 월급 변수의 전처리 과정이다. 변수 검토하기 class(welfare$income) 월급변수는 연속 변수이기 때문에 summary로 요약통계량 확인 summary(welfare$income) > 범주 변수는 table()로 각 범주의 빈도를 확인하고 연속 변수는 summary()로 요약통계량을 확인한다! qplot은 최댓값까지 표현하도록 기본값이 설정되어 있다. 대다수를 차지하는 0~1000 사이의 데이터를 잘 표현되게 설정해준다. qplot(welfare$income) + xlim(0, 1000) 2. 전처리 전처리를 하기 전 먼저 이상치를 확인해준다. summary(welfare$income) Min. 1st Qu. Median Mean 3rd Qu. Max. NAs 0.0 122.0 192.5 241.6 316.6 2400.0 12030 결측치가 12030개 있다는 것을 확인 소득이 0 또는 9999로 기록된 경우를 NA(결측치)로 바꾼다 welfare$income <- ifelse(welfare$income %in% c(0,9999), NA, welfare$income) 두 변수의 전처리 작업 완료~~ !! **2단계) 변수 간 관계 분석 ** 성별 월급 평균표를 만들어 비교해보겠다. sex_incom <- welfare %>% filter(!is.na(income)) %>% group_by(sex) %>% summarise(mean_income = mean(income)) sex_incom ``` > sex_incom # A tibble: 2 × 2 sex mean_income <chr> <dbl> 1 female 162. 2 male 312. ``` ``` 그래프 만들기 ggplot(data=sex_incom, aes(x=sex, y=mean_income)) + geom_col() ``` 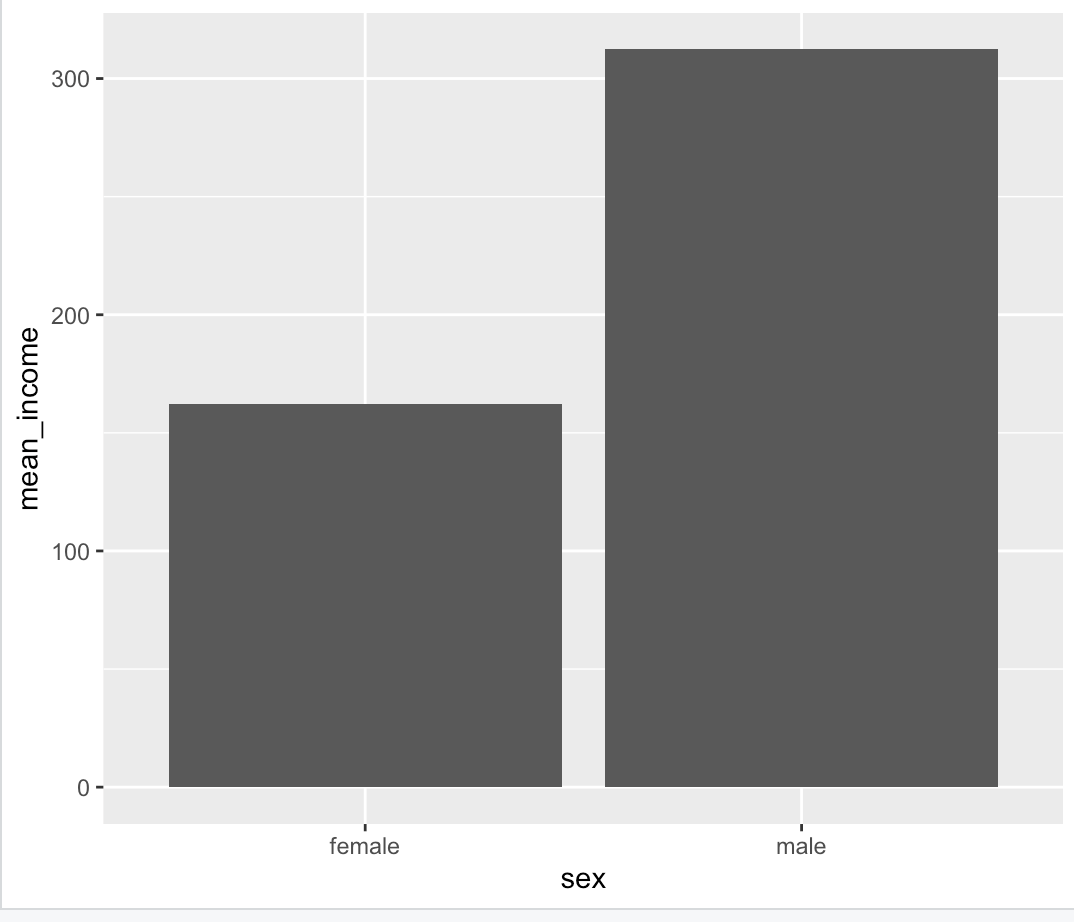
What RADAR observed and classified to build this opportunity. It is what the source published, not a verification that the offer is still active.
Do it! 쉽게 배우는 R 데이터 분석 09. 데이터 분석 프로젝트 - '한국인의 삶을 파악하라' 이제 본격적으로 데이터 분석을 해보는 차례다. 한국복지패널데이터를 이용해 한국인의 삶을 파악하는 활동을 해보겠다. 데이터 분석 준비하기 install.packages("foreign") library(foreign) library(dplyr) #전처리 library(ggplot2) #시각화 library(readxl) #엑셀 파일 불러오기 #데이터 불러오기 raw_welfare class(welfare$sex) [1] "numeric" 각 범주에 몇 명이 있는지 > table(welfare$sex) 1 2 7578 9086 #1은 7578명, 2는 9086명 전처리 코드북의 정보를 바탕으로 이상치를 검토하고…
Open source